Jawaban langsung: ClaudeClaude ProLangganan berbayar asisten AI Claude dari Anthropic. Langganan ini membuka connector ke alat luar.Buka glosarium Haiku 5.5 dan GPT-6 Luna punya harga token yang sama: $0,10 input dan $0,50 output per 1 juta token. Haiku 5.5 lebih pintar untuk agentAgent AIProgram AI yang mengerjakan langkah pekerjaan sendiri, misalnya membaca pesan, menyiapkan balasan, lalu mencatat hasilnya.Buka glosarium multi-langkah. Di uji independen Artificial Analysis, Haiku 5.5 menang di 5 dari 10 benchmark, Luna menang di 2, dan 3 seri. GPT-6 Luna lebih hemat untuk tugas pendek bervolume besar, karena Luna menulis lebih sedikit token.
Kondisi utama: pilih dari biaya per tugas yang lulus, bukan dari harga per token. Di uji kami, kedua model lulus 54 dari 54 tugas bisnis pendek, tetapi tagihan Haiku 5.5 1,9x sampai 3,3x lebih besar. Batas: uji kami memakai 6 tugas pendek dengan data dummy, jadi hasil ini tidak berlaku untuk agent panjang, computer use, atau dokumen di atas 100.000 token.
Pada 9 Oktober 2026 kami membaca pengumuman Anthropic, Claude Docs, halaman model GPT-6 Luna di OpenAI, dan halaman perbandingan Artificial Analysis. Pada hari yang sama kami menjalankan 108 panggilan APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium dengan prompt sama lewat OpenRouter. Catatan: asisten chat Rama Digital memakai GPT-6 Luna sejak 24 September 2026.
Kenapa harga per token bisa menipu
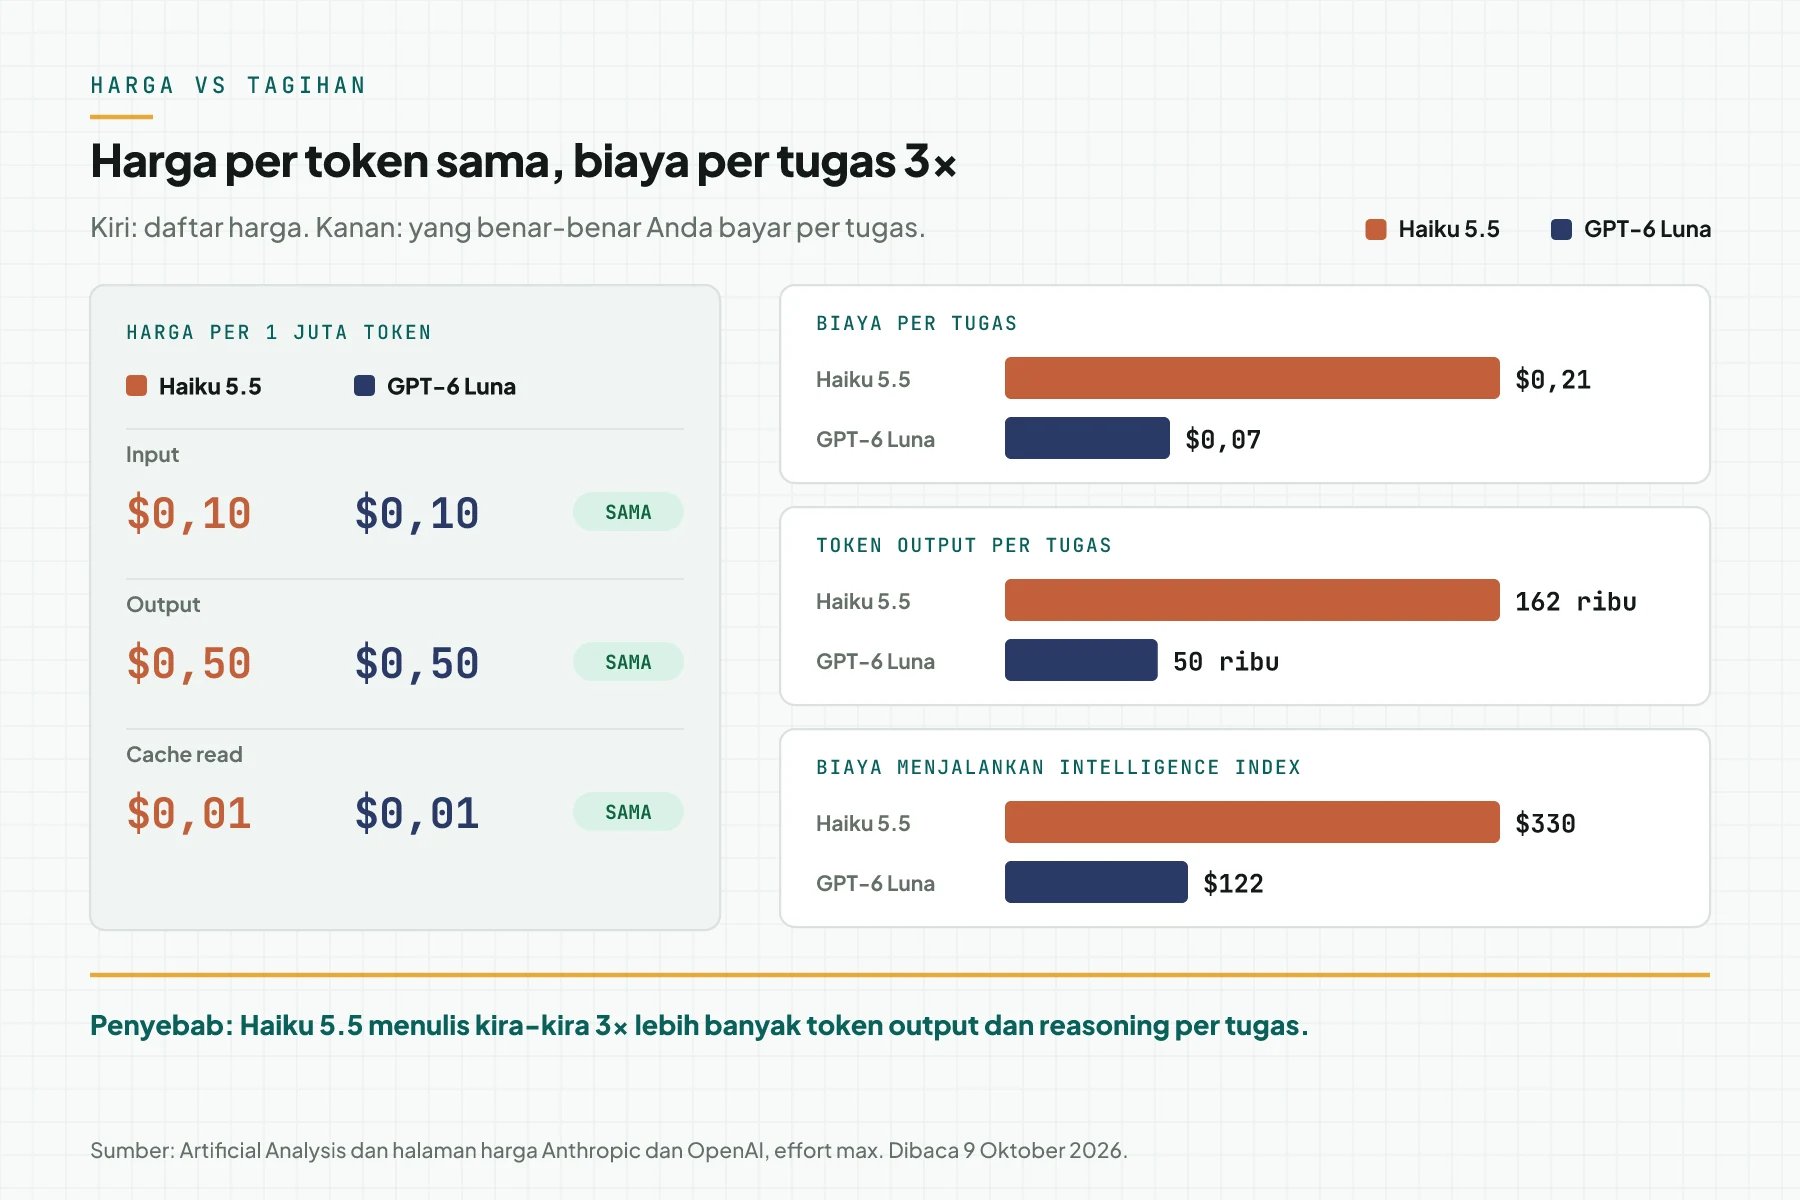
Dua model dengan harga token sama belum tentu punya tagihan sama. Tagihan = harga token x jumlah token. Model yang berpikir lebih panjang menulis lebih banyak token reasoning, dan token reasoning dibayar sebagai token output.
Itu yang terjadi pada pasangan ini. Artificial Analysis mencatat Haiku 5.5 memakai 162 ribu token output per tugas, Luna hanya 50 ribu. Jadi biaya per tugas Haiku 5.5 $0,21, Luna $0,07, atau kira-kira 3x.
Bulan lalu kami membandingkan 4 model murah, termasuk Haiku 4.5 dan Luna. Baca perbandingan GPT-6 Luna, DeepSeek Flash, Gemini Flash, dan Claude Haiku 4.5 untuk konteks kelas harga ini.
Head to head: angka resmi dan uji independen
Harga dan spesifikasi
Anthropic merilis Claude Haiku 5.5 pada 7 Oktober 2026. Harganya turun 90% dari Haiku 4.5 untuk prompt sampai 100.000 token. Anthropic menulis Haiku 5.5 rata-rata 75% lebih murah untuk dijalankan. Sumber: pengumuman Claude Haiku 5.5.
| Item | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Rilis | 7 Oktober 2026 | 22 September 2026 |
| Input / output per 1 juta token | $0,10 / $0,50 | $0,10 / $0,50 |
| Cache read / cache write | $0,01 / $0,125 | $0,01 / $0,125 |
| Prompt panjang | Di atas 100.000 token: $0,50 / $2,50 | Di atas 272.000 token: input dan cache 2x |
| Konteks / output maks | 1 juta / 128.000 token | 1.050.000 / 128.000 token |
| Effort | low, medium, high, xhigh, max; default medium | none, low, medium, high, xhigh, max; default medium |
| Knowledge cutoff | Juni 2026 | 18 Mei 2026 |
Sumber: Claude Docs Models overview, halaman model GPT-6 Luna, dan tabel harga Anthropic, dibaca 9 Oktober 2026.
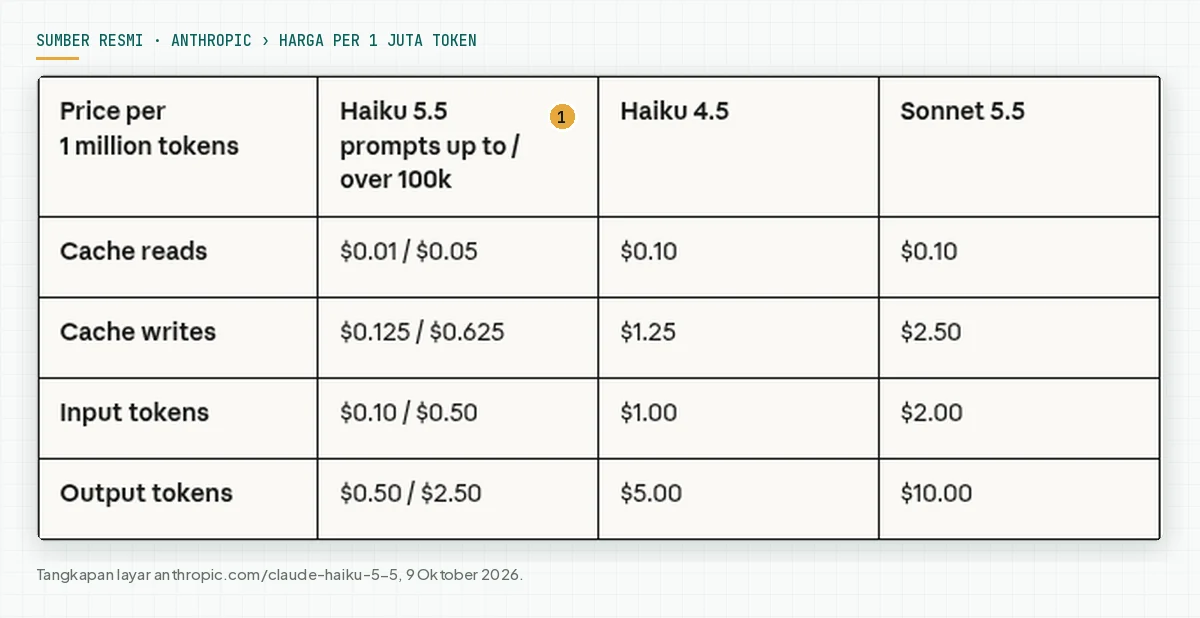
Perhatikan batas 100.000 token. Di atas batas itu, input Haiku 5.5 menjadi $0,50 dan output $2,50 per 1 juta token. Luna baru naik di atas 272.000 token input, dan hanya untuk input dan cache.
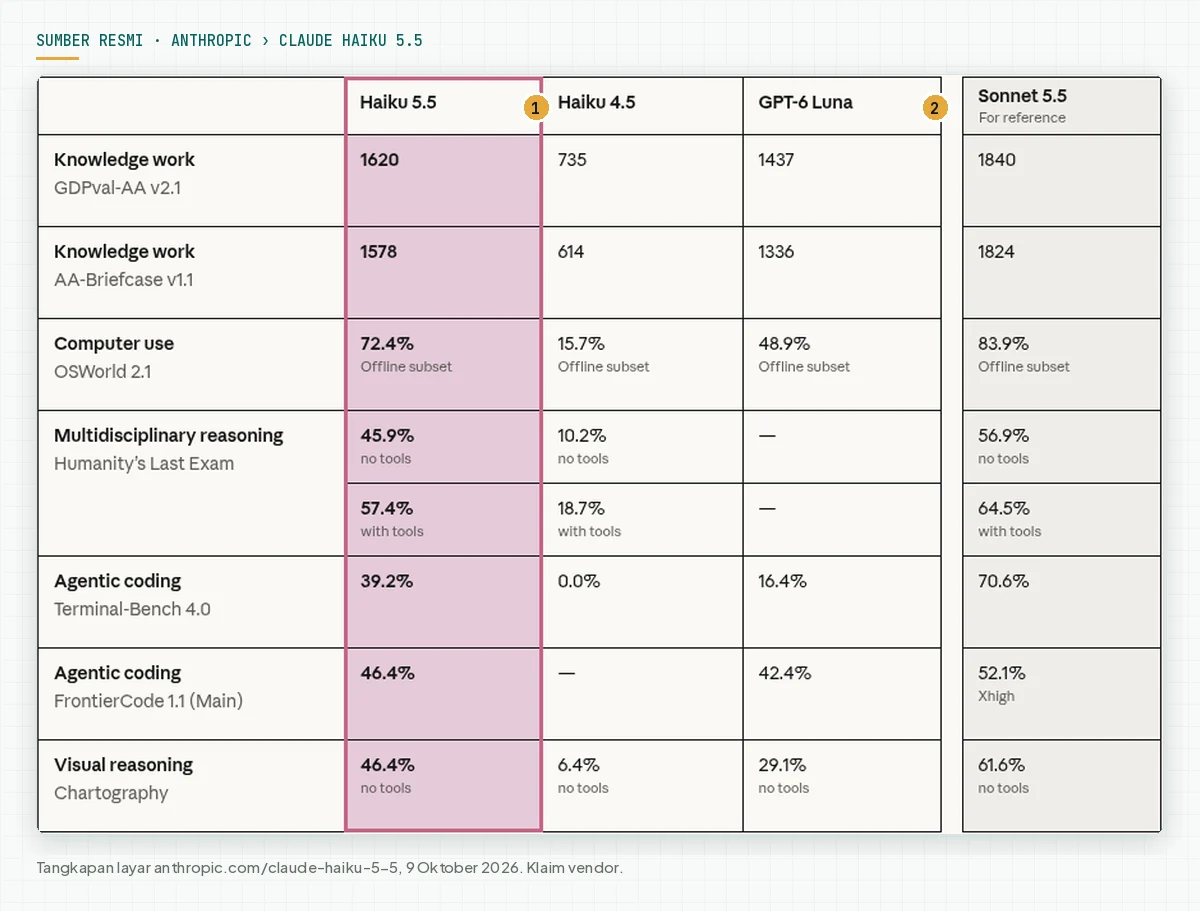
Benchmark vendor: Haiku 5.5 unggul jauh di agent
Di tabel Anthropic, Haiku 5.5 mencetak 72,4% di OSWorld 2.1, Luna 48,9%. Di Terminal-Bench 4.0, Haiku 5.5 39,2%, Luna 16,4%. Ini klaim vendor, jadi kami cek ke sumber independen.
Uji independen: skor 5-2-3
Artificial Analysis menguji kedua model pada effort max dengan 10 benchmark. Intelligence Index Haiku 5.5 adalah 43, Luna 38. Haiku 5.5 menang di Terminal-Bench (33% vs 13%) dan GDPval-AA. Luna menang di AutomationBench-AA (53% vs 35%) dan GDP.pdf. Sumber: perbandingan Artificial Analysis.
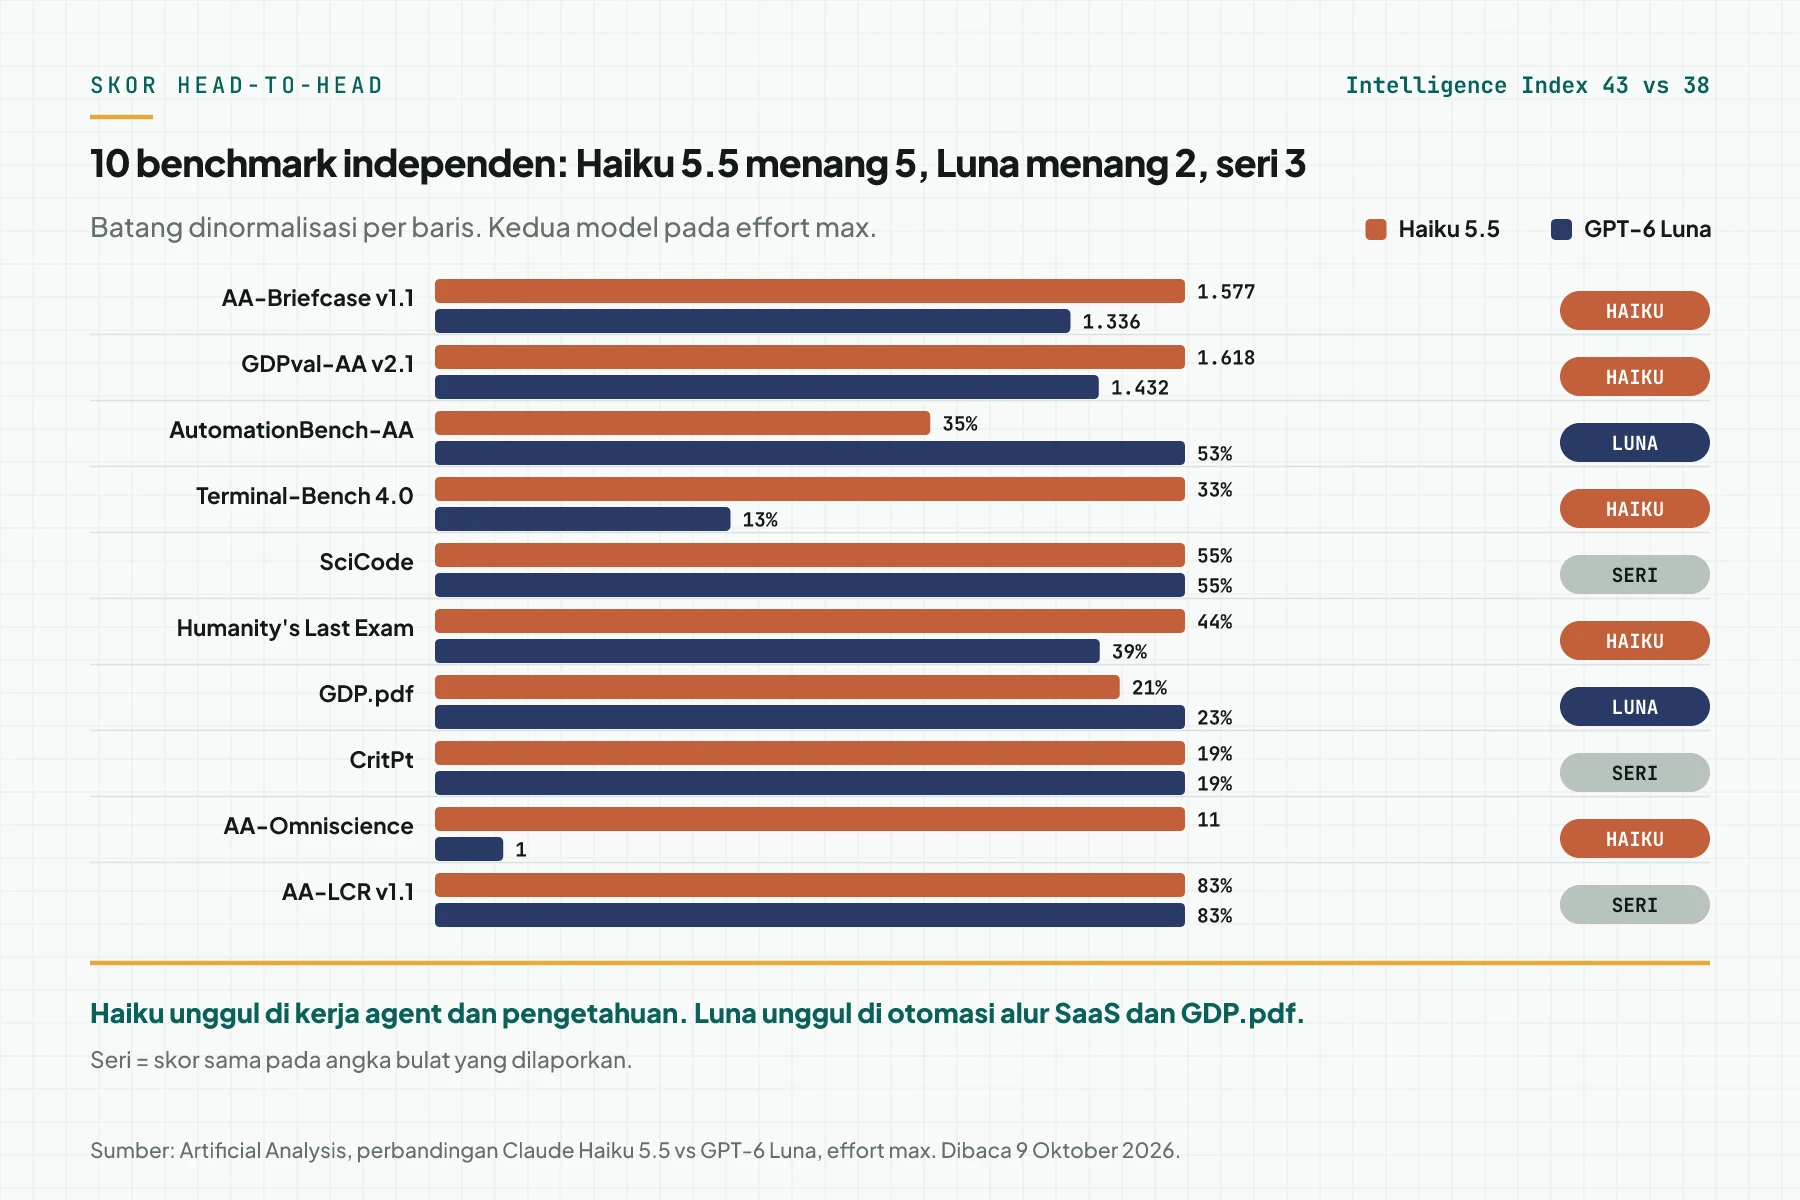
Satu hasil penting untuk chatbot: AA-Omniscience. Skor ini menghukum jawaban yang salah dan tidak menghukum jawaban "tidak tahu". Haiku 5.5 mencetak 11, Luna 1, jadi Haiku 5.5 lebih jarang mengarang fakta pada uji ini.
Kenapa tagihan bisa 3x
Di halaman yang sama, biaya menjalankan seluruh Intelligence Index adalah $330 untuk Haiku 5.5 dan $122 untuk Luna. Token reasoning per tugas: 129 ribu lawan 39 ribu.
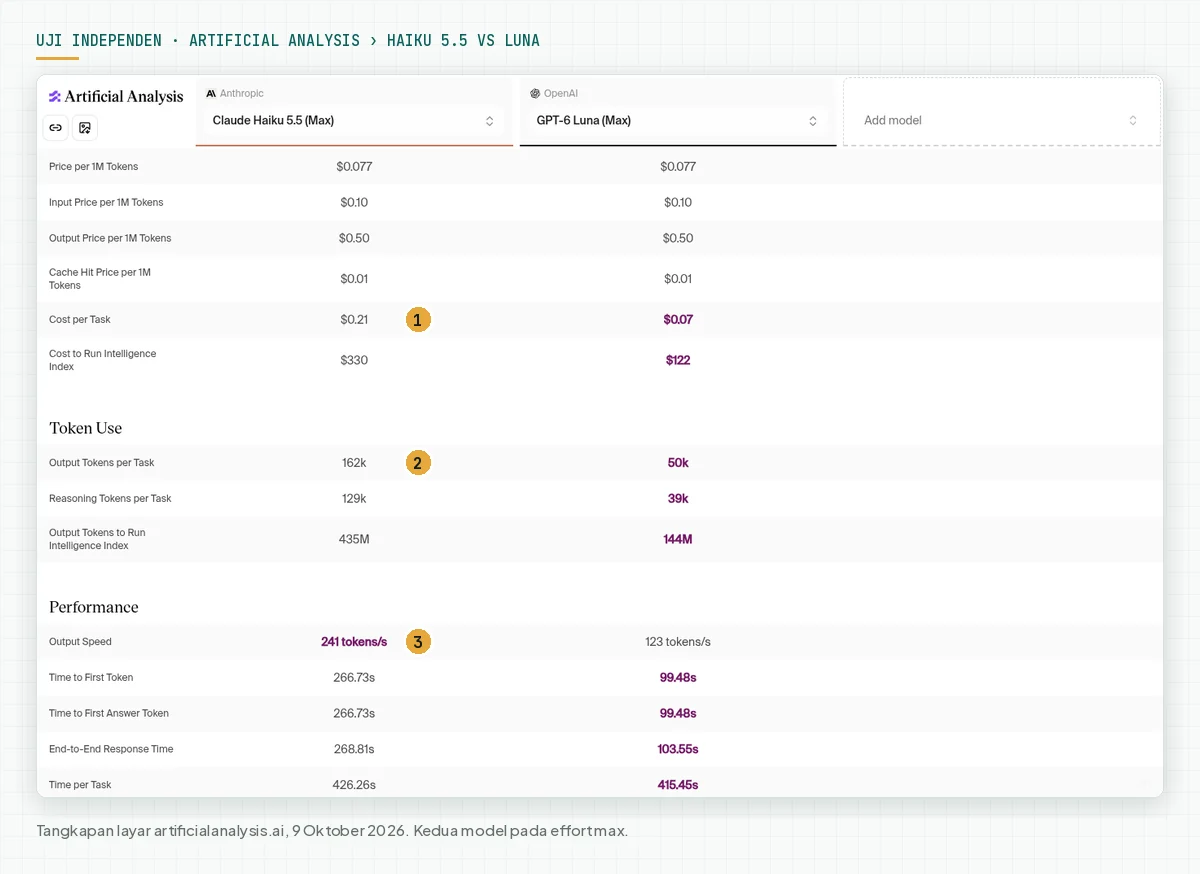
Ada satu hal yang mengejutkan. Haiku 5.5 menulis 241 token per detik, Luna 123. Namun waktu per tugas hampir sama: 426 detik lawan 415 detik, karena Haiku 5.5 berpikir lebih lama.
Effort: bandingkan pada biaya yang sama
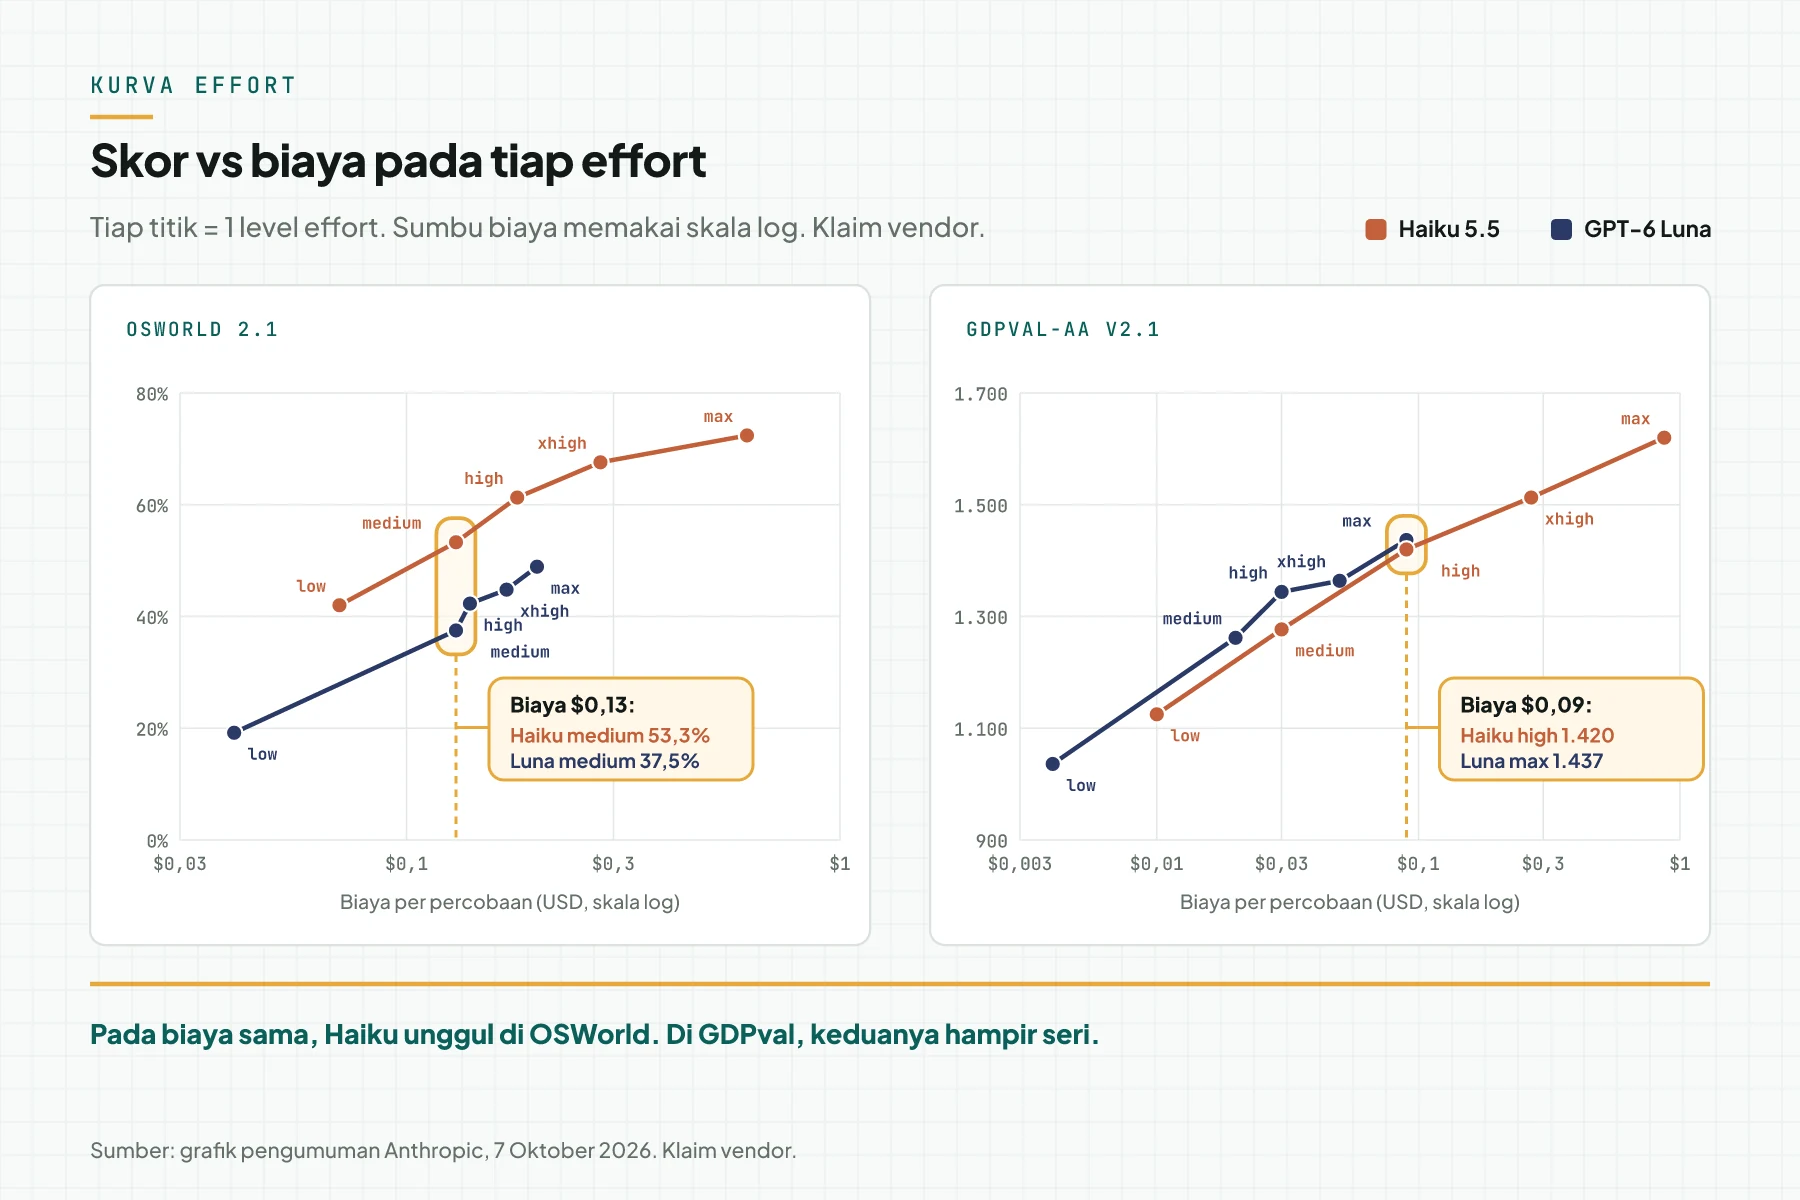
Haiku 5.5 adalah model Haiku pertama dengan setelan effort. Anthropic menerbitkan grafik skor lawan biaya per percobaan untuk tiap effort. Grafik ini adil, karena kita dapat membandingkan kedua model pada biaya yang sama.
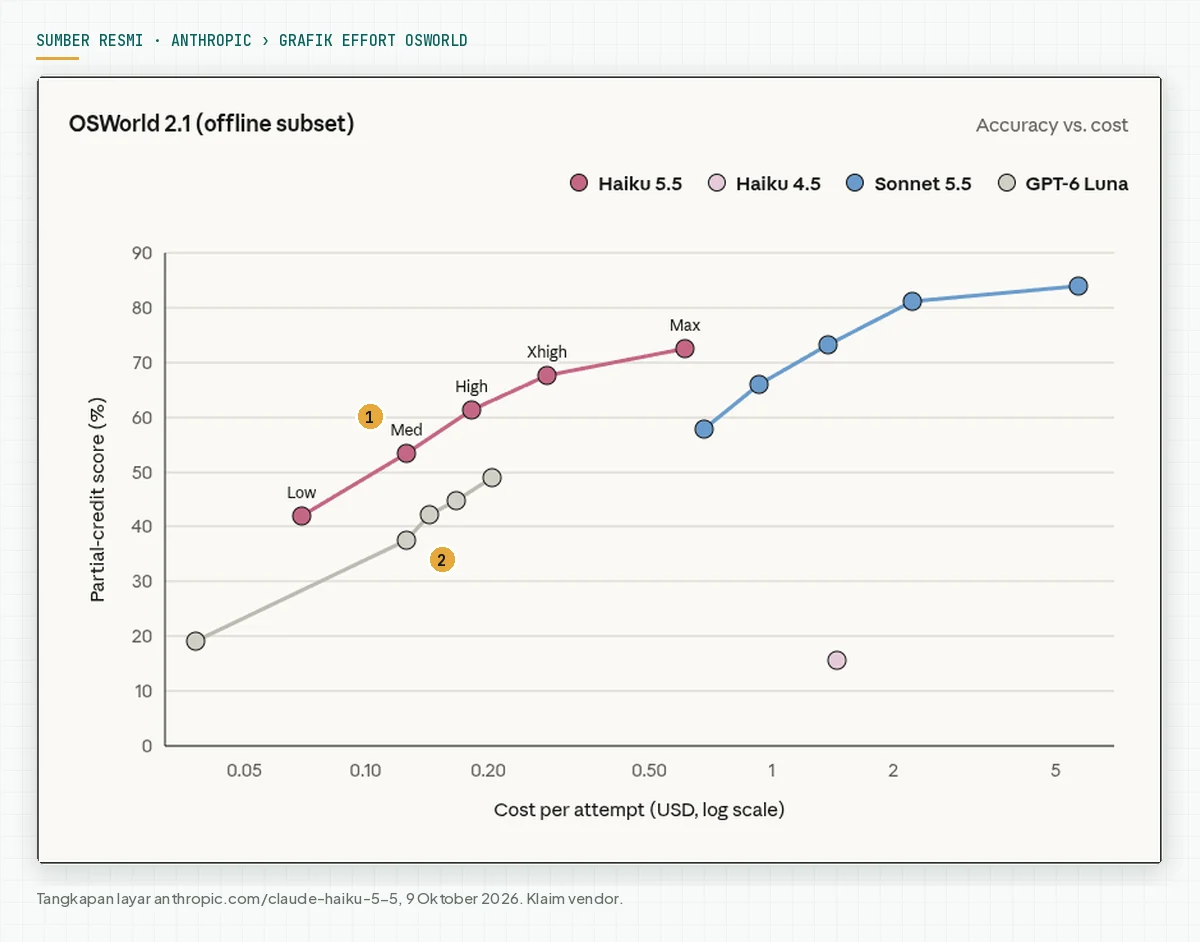
Pada biaya $0,13 per percobaan di OSWorld, Haiku 5.5 medium mencetak 53,3% dan Luna medium 37,5%. Di GDPval-AA, hasilnya lain. Pada biaya $0,09, Haiku 5.5 high mencetak 1.420 dan Luna max 1.437, jadi hampir seri.
Uji Rama Digital: 108 panggilan, prompt sama
Pada 9 Oktober 2026 kami mengirim 6 tugas bisnis dummy ke kedua model lewat OpenRouter. Tugasnya: hitung invoice dengan diskon dan PPN, ekstrak pesanan dari chat WhatsApp ke JSON, beri label 8 pesan pelanggan, tulis balasan CS tanpa diskon palsu, jawab dari dokumen yang tidak memuat jawaban, dan tulis fungsi JavaScript yang kami uji otomatis.
Setiap tugas berjalan 3 kali pada effort low, medium, dan high. Total 54 panggilan per model. Haiku 5.5 dilayani Claude Platform on AWS, Luna dilayani OpenAI.
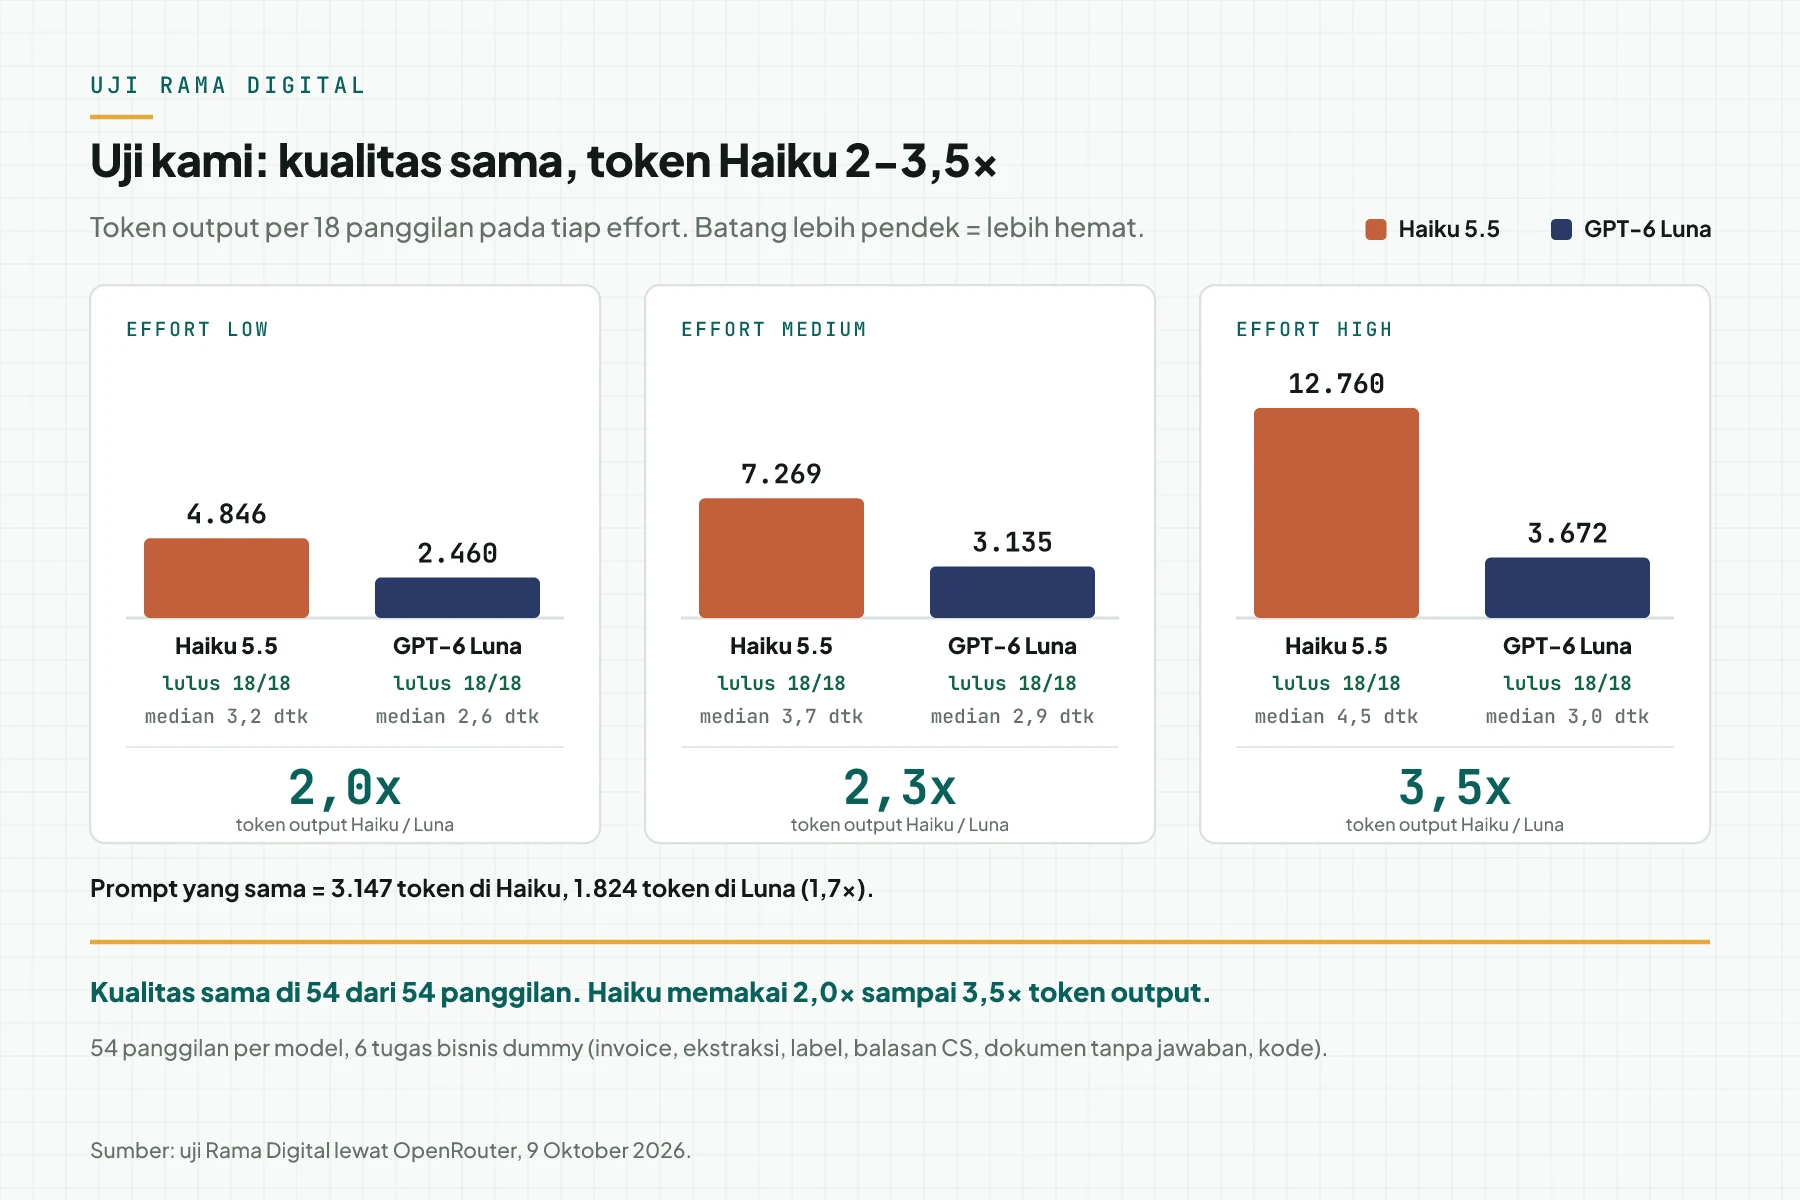
| Effort | Lulus Haiku / Luna | Median waktu Haiku / Luna | Token output Haiku / Luna | Biaya Haiku / Luna (18 panggilan) |
|---|---|---|---|---|
| low | 18/18 / 18/18 | 3,2 / 2,6 detik | 4.846 / 2.460 | $0,0027 / $0,0014 |
| medium | 18/18 / 18/18 | 3,7 / 2,9 detik | 7.269 / 3.135 | $0,0039 / $0,0018 |
| high | 18/18 / 18/18 | 4,5 / 3,0 detik | 12.760 / 3.672 | $0,0067 / $0,0020 |
Tiga temuan dari uji kami:
- Kualitas sama: kedua model lulus 54 dari 54. Satu jawaban Haiku 5.5 sempat gagal karena pemeriksa otomatis kami salah membaca kalimat "tidak menyebutkan". Kami cek manual, dan jawabannya benar.
- Prompt yang sama dihitung 3.147 token di Haiku 5.5 dan 1.824 token di Luna, atau 1,7x. Claude Docs menulis tokenizer baru Haiku 5.5 menghitung teks kira-kira 30% lebih banyak dari Haiku 4.5.
- Luna selesai lebih cepat di tugas pendek: median 2,9 detik lawan 3,7 detik pada effort medium. Kecepatan tulis Haiku 5.5 kalah oleh panjang reasoning-nya.
Batas uji ini: 6 tugas pendek, 3 kali ulang, tanpa cache dan tanpa tool. Uji ini tidak mengukur agent panjang, tempat Haiku 5.5 unggul di benchmark.
Yang Anda perlukan sebelum memilih
- Akun API Anthropic dan OpenAI, atau 1 akun OpenRouter yang melayani keduanya.
- 20 contoh tugas nyata dari sistem Anda, dengan jawaban benar yang sudah Anda tulis.
- Log biaya AI 14 hari terakhir, bila sistem Anda sudah berjalan.
- Skrip kecil yang mencatat token input, token output, waktu, dan lulus atau gagal per panggilan.
- Batas biaya bulanan di dashboard penyedia, supaya uji tidak lepas kendali.
Langkah 1: Kelompokkan tugas Anda
Bagi tugas AI Anda menjadi 2 kelompok: agent multi-langkah dan tugas pendek bervolume besar. Agent multi-langkah memakai tool, browser, atau terminal. Tugas pendek adalah label, ekstraksi, ringkasan, dan balasan chat.
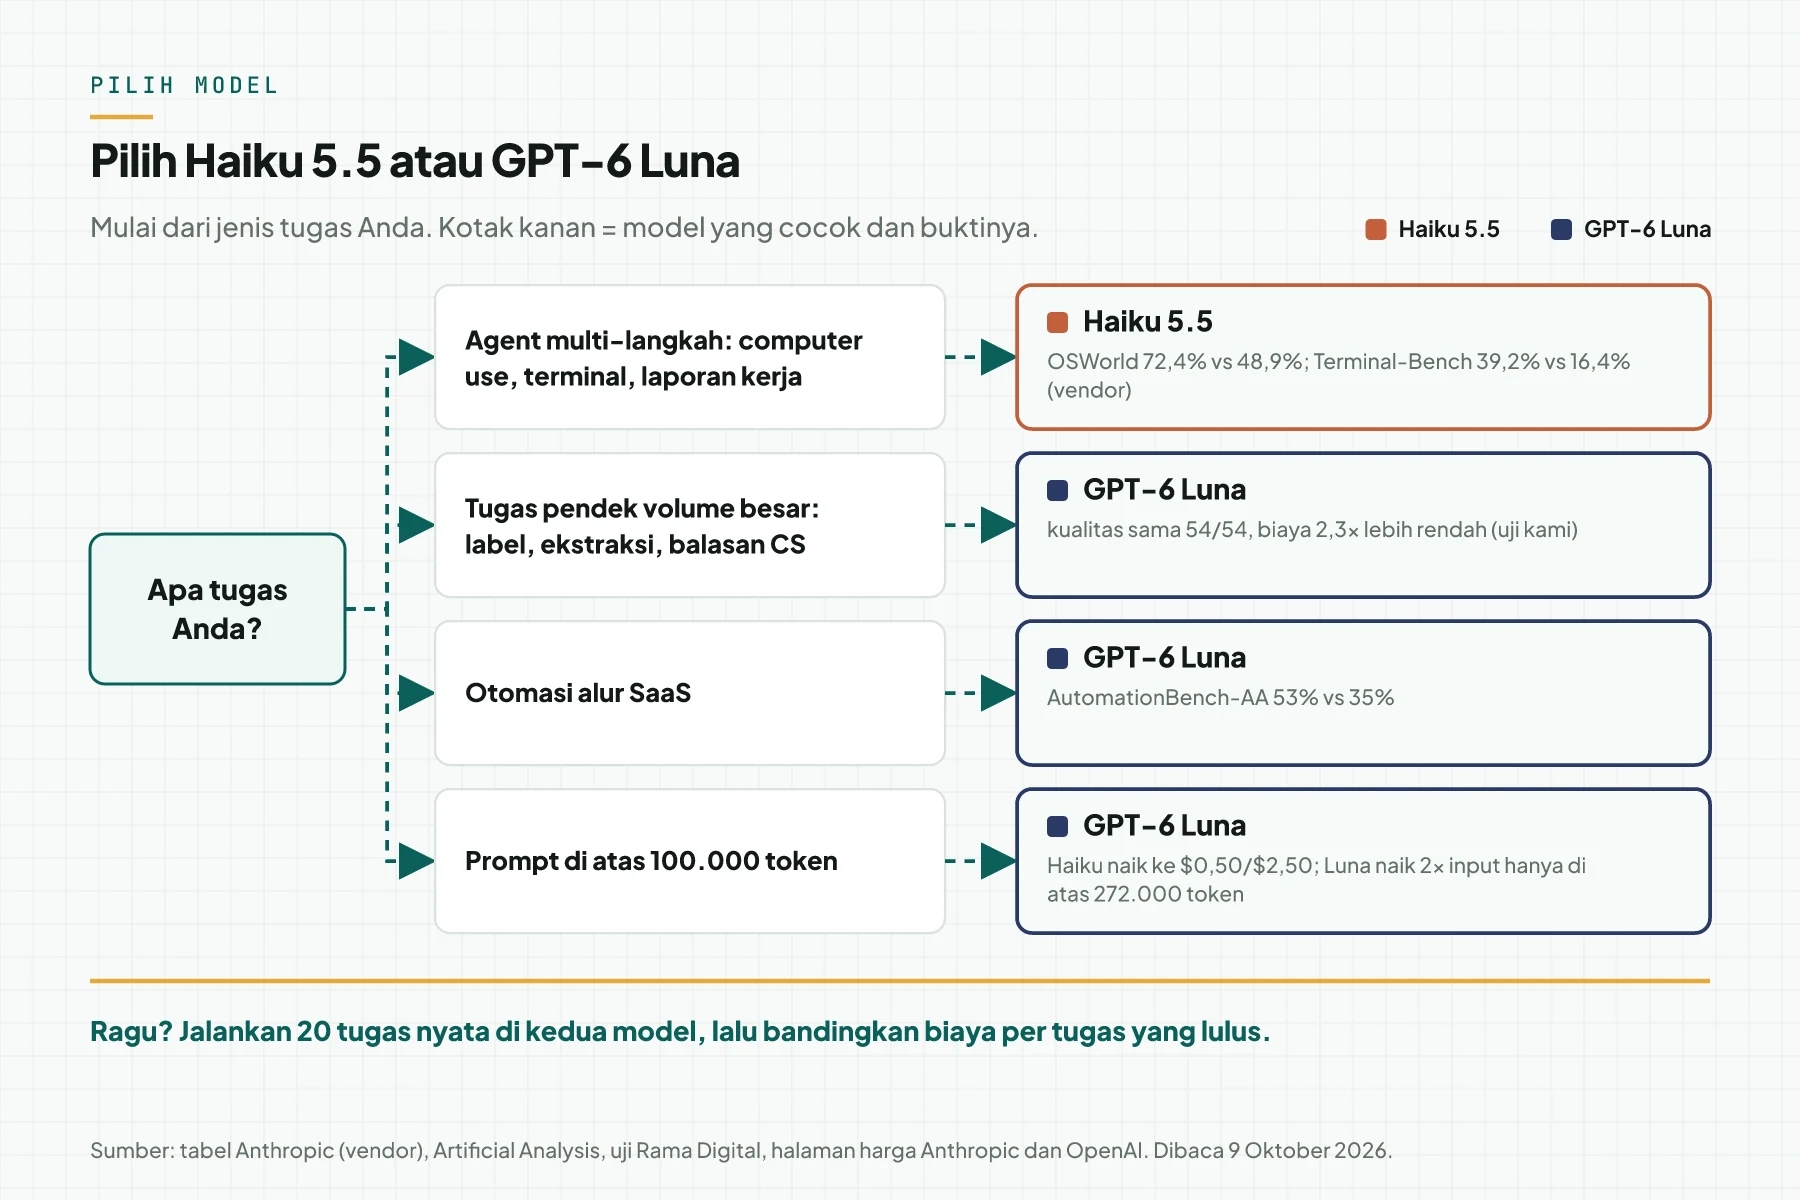
Rekomendasi Rama Digital: mulai dengan Luna untuk tugas pendek dan Haiku 5.5 untuk subagent. Anthropic sendiri menyarankan Haiku 5.5 sebagai subagent untuk Opus 5.5 dan Sonnet 5.5.
Verifikasi: setiap alur AI Anda punya 1 label kelompok di dokumen arsitektur.
Langkah 2: Jalankan 20 tugas nyata di kedua model
Kirim 20 tugas yang sama ke kedua model dengan effort medium, yaitu default keduanya. Pakai prompt, tool, dan data yang sama. Ulangi tiap tugas 3 kali, karena jawaban model AI tidak selalu sama.
Untuk Haiku 5.5, set effort lewat output_config.effort. Untuk Luna, set reasoning.effort. Lewat OpenRouter, keduanya memakai reasoning: { effort: "medium" }.
Verifikasi: tabel Anda punya 120 baris, yaitu 20 tugas x 3 ulangan x 2 model, tanpa error API.
Langkah 3: Hitung biaya per tugas yang lulus
Bagi total biaya dengan jumlah tugas yang lulus. Angka ini lebih jujur dari harga per token, karena ia menghitung token reasoning dan jawaban yang gagal.
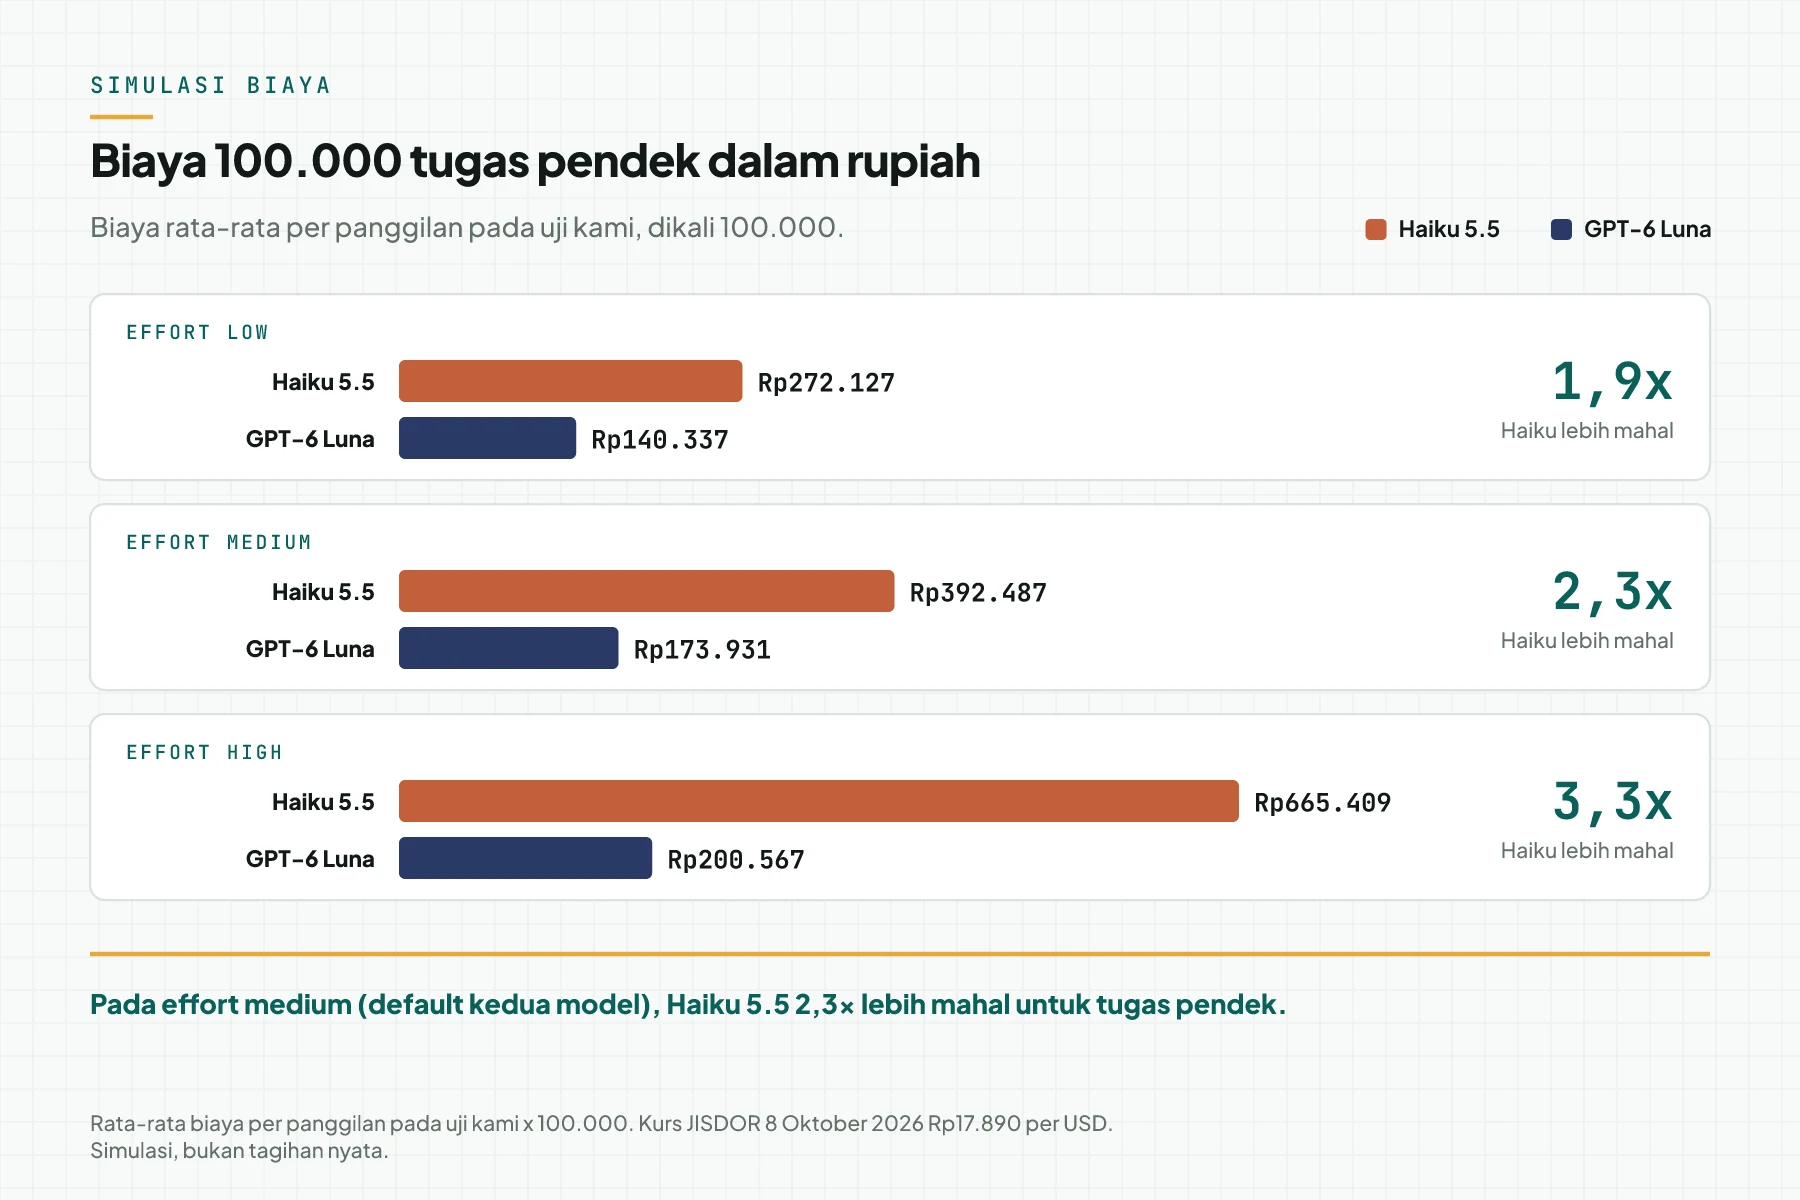
Contoh dari uji kami: pada effort medium, 1 tugas pendek rata-rata $0,000219 di Haiku 5.5 dan $0,000097 di Luna. Kurs JISDOR Bank Indonesia 8 Oktober 2026: Rp17.890 per USD. Sumber kurs: JISDOR Bank Indonesia.
Verifikasi: Anda punya 1 angka rupiah per 1.000 tugas lulus untuk tiap model.
Langkah 4: Perbaiki kode sebelum pindah ke Haiku 5.5
Lewati langkah ini bila Anda tidak memakai Claude. Ganti model ID saja belum selesai, karena Haiku 5.5 punya 5 breaking changes dari Haiku 4.5. Sumber: What's new in Claude Haiku 5.5.
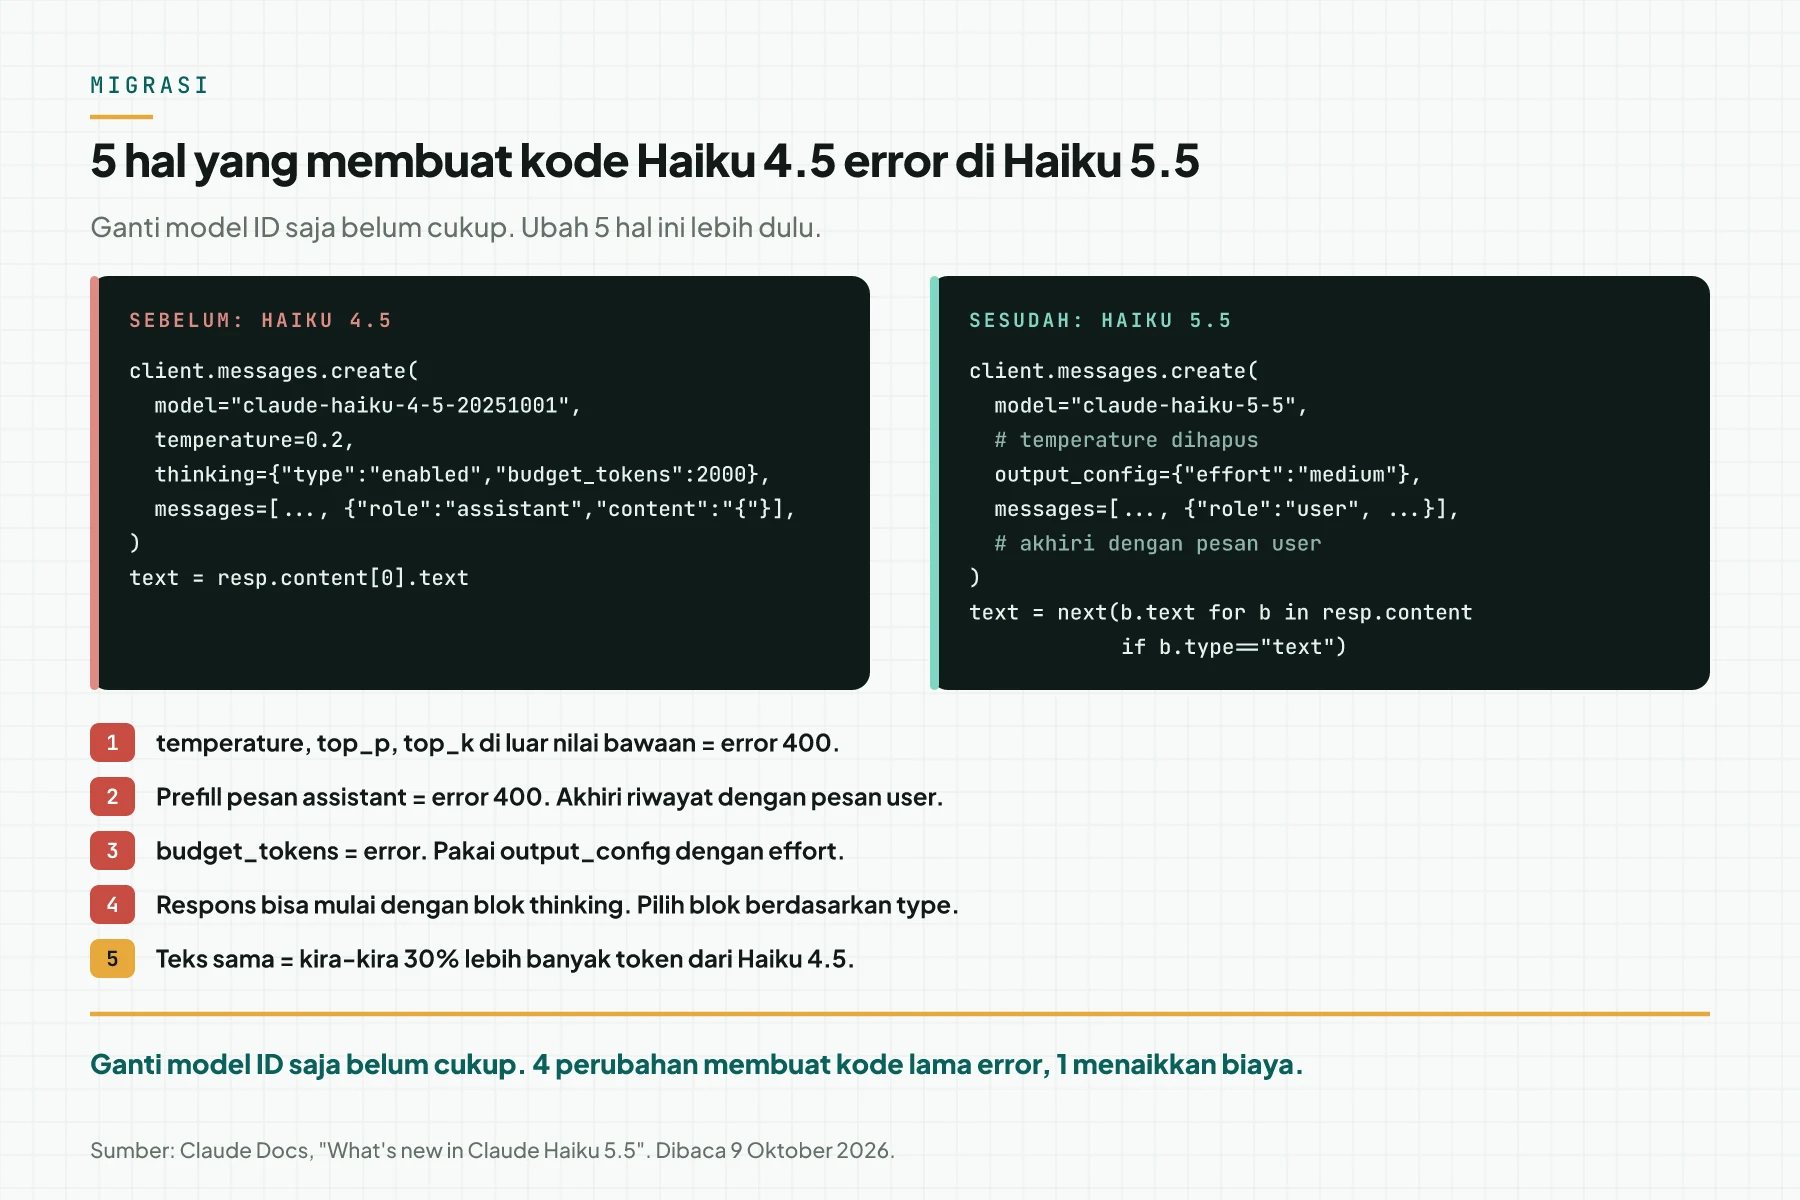
- Hapus
temperature,top_p, dantop_kyang tidak default. Nilai itu kini menghasilkan error. - Akhiri
messagesdengan giliran user. Prefill assistant kini menghasilkan error. - Ganti
budget_tokensdengan adaptive thinking dan effort. - Ambil jawaban berdasarkan
type, karena respons dapat diawali blok thinking. - Naikkan
max_tokens, karena token thinking ikut dihitung di batas itu.
Verifikasi: 20 tugas uji berjalan tanpa error 400, dan setiap jawaban punya blok text.
Langkah 5: Pasang router dan batas biaya
Arahkan tiap kelompok tugas ke model pemenangnya di Langkah 3. Tambahkan fallback ke model kedua bila penyedia pertama gagal. Pasang alarm bila token output per tugas naik 50% dari angka uji.
Pola ini kami pakai pada chatbot klien: model keputusanJevModel AI kecil dari TypeSafe yang memutuskan nasib tiap chat: balas, lewati, tandai untuk tim, atau keluarkan dari follow-up. Jev tidak menulis balasan.Cara Jev memilih chat yang dijawab murah memilah chat dulu, lalu model chat menjawab. Baca cara menghitung biaya API GPT-6 dan Claude untuk rumus per bulan.
Verifikasi: dashboard biaya menunjukkan biaya per model per hari, dan 1 uji fallback berhasil.
Contoh simulasi: toko online dengan 100.000 chat per bulan
Simulasi dengan data dummy. "Toko Contoh" memakai AI untuk label chat masuk dan balasan pertama. Angka biaya memakai rata-rata uji kami pada effort medium.
| Tanggal | Tindakan | Yang dicatat | Hasil |
|---|---|---|---|
| 13 Okt 2026 | Kelompokkan tugas | 2 alur: label chat, balasan pertama | Keduanya tugas pendek |
| 14 Okt 2026 | Uji 20 tugas x 3 x 2 model | Lulus, token, waktu, biaya | Kedua model lulus 60/60 |
| 15 Okt 2026 | Hitung biaya per tugas lulus | Rupiah per 100.000 tugas | Haiku 5.5 Rp392.487, Luna Rp173.931 |
| 16 Okt 2026 | Pilih Luna, Haiku 5.5 sebagai fallback | Konfigurasi router | Hemat kira-kira Rp218.556 per bulan |
| 23 Okt 2026 | Tinjau 7 hari | Token output per tugas | Alarm tidak menyala |
Selisih ini kecil untuk 1 toko. Selisih menjadi besar bila prompt Anda panjang, karena token input juga dihitung 1,7x lebih banyak di Haiku 5.5 pada uji kami.
Checklist memilih Haiku 5.5 atau Luna
- Label setiap alur AI sebagai agent atau tugas pendek. Pemilik: lead engineer. Bukti: dokumen arsitektur.
- Kumpulkan 20 tugas nyata dengan jawaban benar. Pemilik: pemilik alur. Bukti: berkas uji bertanggal.
- Jalankan uji 3 ulangan pada effort medium di kedua model. Pemilik: engineer. Bukti: tabel 120 baris.
- Hitung rupiah per 1.000 tugas lulus. Pemilik: engineer. Bukti: lembar hitung dengan kurs dan tanggal.
- Perbaiki 5 breaking changes bila memilih Haiku 5.5. Pemilik: engineer. Bukti: 0 error 400 di staging.
- Pasang router, fallback, dan alarm token. Pemilik: platform engineer. Bukti: 1 uji fallback berhasil.
- Hentikan dan uji ulang bila tugas lulus turun lebih dari 1 dari 20, atau token per tugas naik lebih dari 50%. Pemilik: pemilik alur. Bukti: catatan keputusan bertanggal.
Pertanyaan yang sering muncul
Mana yang lebih murah, Claude Haiku 5.5 atau GPT-6 Luna? Harga token sama: $0,10 input dan $0,50 output per 1 juta token. Biaya per tugas berbeda. Artificial Analysis mencatat $0,21 lawan $0,07, dan uji kami mencatat Haiku 5.5 2,3x lebih mahal pada effort medium.
Mana yang lebih pintar, Haiku 5.5 atau Luna? Haiku 5.5. Intelligence Index Artificial Analysis 43 lawan 38, dan Haiku 5.5 menang di 5 dari 10 benchmark. Luna menang di AutomationBench-AA dan GDP.pdf.
Model mana yang cocok untuk chatbot WhatsApp? Untuk balasan pendek bervolume besar, mulai dengan GPT-6 Luna, karena kualitasnya sama di uji kami dan tagihannya lebih kecil. Pakai Haiku 5.5 bila bot menjalankan tool berlapis.
Apakah kode Haiku 4.5 langsung jalan di Haiku 5.5? Tidak selalu. temperature non-default, prefill assistant, dan budget_tokens menghasilkan error di Haiku 5.5. Respons juga dapat diawali blok thinking, jadi pilih blok jawaban berdasarkan type.
Bagaimana menurunkan token Haiku 5.5? Turunkan effort ke low atau medium, lalu ukur lagi. Di uji kami, effort low memakai token output 2x Luna, sedangkan high memakai 3,5x. Untuk tugas sederhana, effort low tetap lulus 18 dari 18.
Langkah berikutnya
Batas yang tetap berlaku: angka vendor, Artificial Analysis, dan uji kami hanya titik awal, karena prompt dan data Anda berbeda. Uji 20 tugas nyata sebelum memindahkan trafik. Bila tagihan AI chatbot Anda naik tanpa kualitas naik, lihat layanan Jasa Optimasi Chatbot AI. Untuk membaca log biaya sistem Anda bersama tim kami, pesan sesi AI Diagnostic.
Ingin tahu posisi model yang lebih besar? Baca Claude Sonnet 5.5 vs Sonnet 5 dan GPT-6 Sol vs GPT-6 Luna vs Claude Opus 5.5.
Sumber
- Anthropic: Introducing Claude Haiku 5.5
- Claude Docs: Models overview
- Claude Docs: What's new in Claude Haiku 5.5
- Claude Docs: Migrating to Claude Haiku 5.5
- OpenAI: GPT-6 Luna model
- OpenAI: Introducing GPT-6 Sol and Luna
- Artificial Analysis: Claude Haiku 5.5 vs GPT-6 Luna
- Artificial Analysis: Claude Haiku 5.5
- Artificial Analysis: GPT-6 Luna
- VentureBeat: Anthropic launches Claude Haiku 5.5
- Bank Indonesia: kurs JISDOR