Jawaban langsung: biaya 1 tugas sama dengan 4 bagian token dikali harganya: input tanpa cache, cache read, cache write, dan output. Hasilnya dikali pengali, dibagi tingkat berhasil, lalu dikali volume dan kurs. Simulasi bot CS 20.000 percakapan per bulan menghasilkan 3 angka: Luna Rp750 ribu, Sol Rp15,0 juta, dan Opus 5.5 Rp29,0 juta.
Kondisi utama: rumus ini berlaku untuk APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium standar OpenAI dan Anthropic dengan harga 23 September 2026. Batas: simulasi menganggap jumlah token sama di tiap model, padahal tokenizer tiap vendor berbeda, jadi ukur token Anda sendiri sebelum memutuskan.
Kami membaca halaman harga resmi, panduan prompt caching, dan kurs JISDOR Bank Indonesia pada 23 September 2026. Potongan kode di artikel ini kami uji dengan pemeriksaan otomatis. Semua beban kerja di artikel ini adalah simulasi dengan data dummy.
Kenapa harga per token menyesatkan
Harga per token mudah dibandingkan: Opus 5.5 berharga 2x Sol dan 40x Luna pada output. Namun tagihan ditentukan oleh jumlah token per tugas, porsi cache, panjang prompt, dan tugas yang gagal lalu diulang.
Contoh nyata datang dari grafik vendor. Pada FrontierCode medium, Sol dan Opus 5.5 sama-sama tercatat $0,80 per tugas, walau harga token Opus 5.5 2x lebih tinggi. Bila kedua vendor menghitung biaya dengan cara yang sama, Opus 5.5 memakai sekitar setengah token Sol untuk tugas yang sama.
Kami memakai cara pikir yang sama di task cost sheet untuk ModelArk, Codex, Claude, dan MiniMax dan skema akuntansi biaya token Hermes Agent. Artikel ini menerapkannya pada 3 model yang rilis 22 September 2026.
Rumus biaya per tugas
Setiap token input masuk tepat 1 dari 3 kelas harga. OpenAI menulis bahwa cache write bukan biaya tambahan: token input memakai harga uncached, cached, atau cache write. Sumber: OpenAI tentang prompt caching GPT-6.
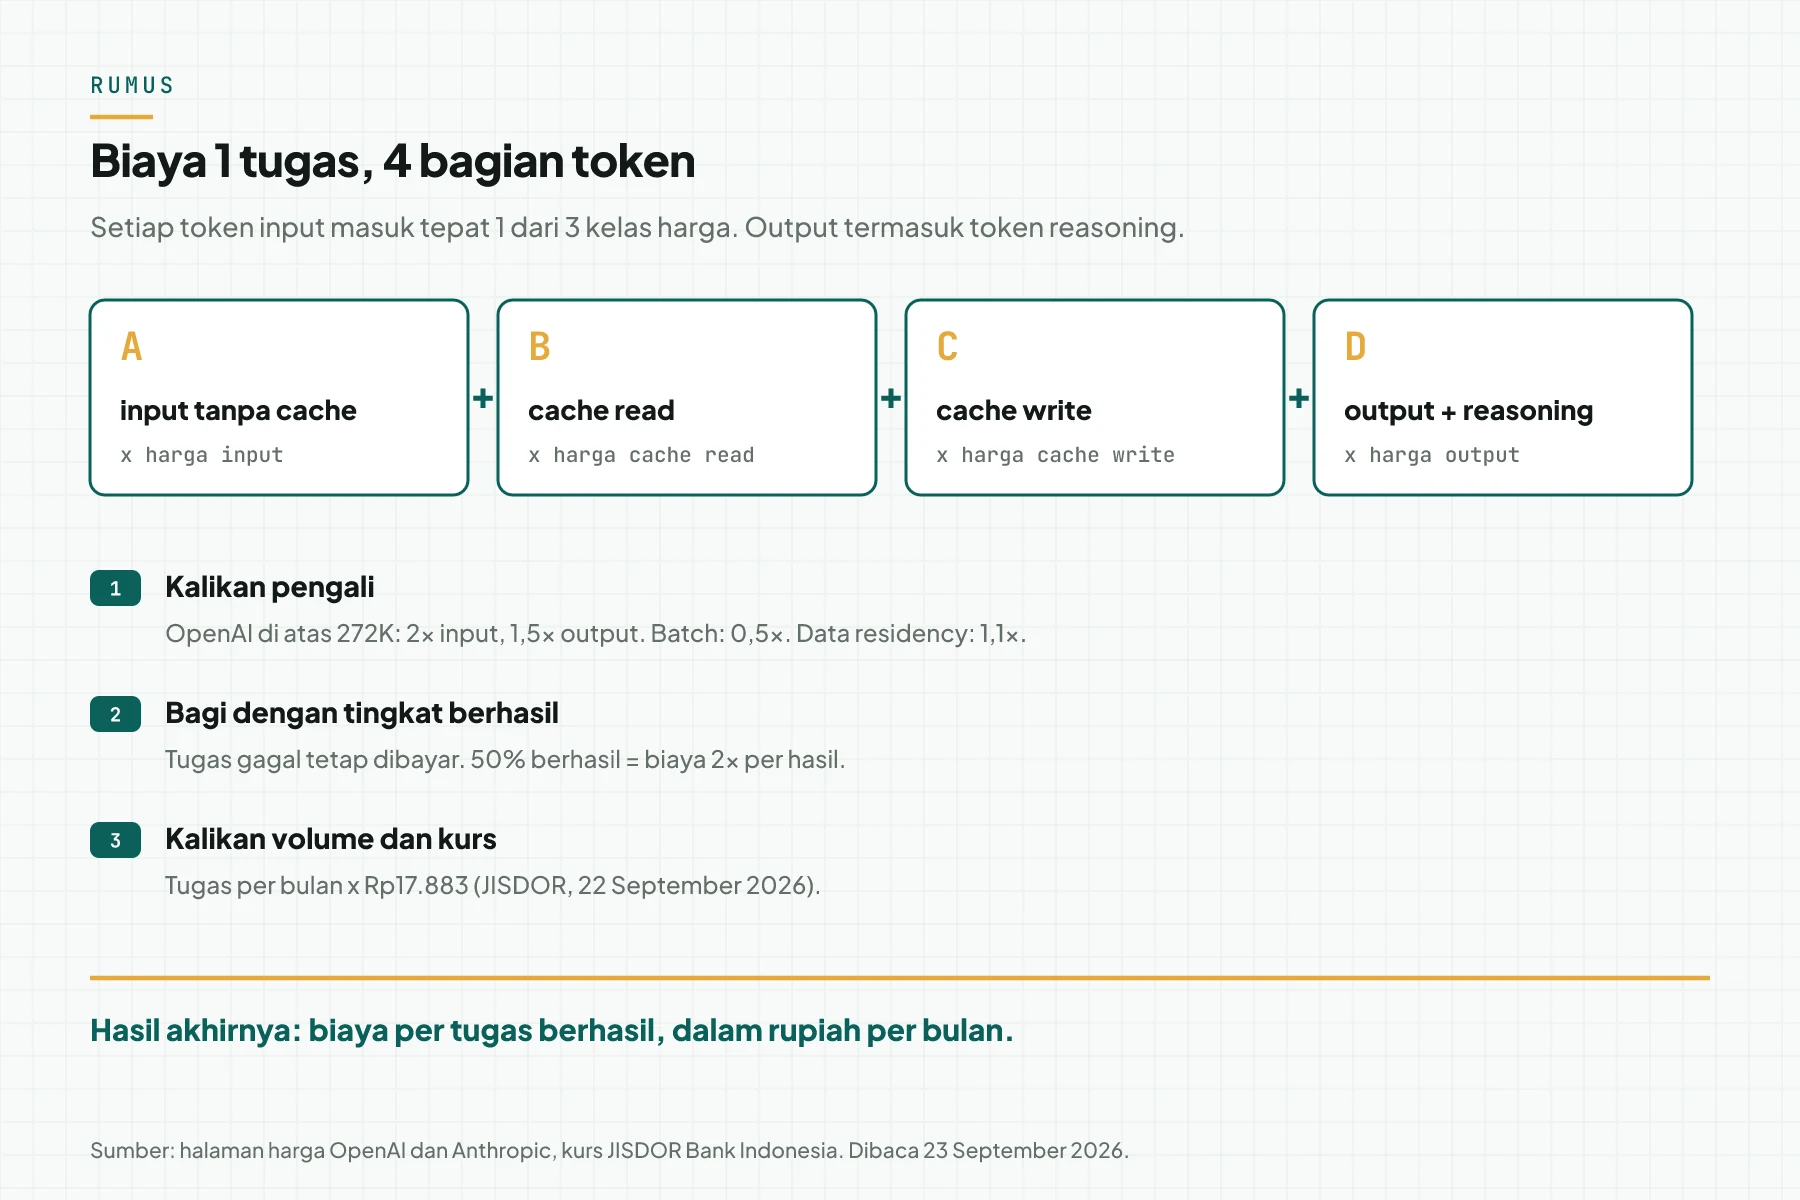
Bagian A: input tanpa cache
Token yang model proses dari nol. Harganya $2 di Sol, $0,10 di Luna, dan $4 di Opus 5.5 per 1 juta token.
Bagian B: cache read
Token dari awal prompt yang sama dengan permintaan sebelumnya. GPT-6 memberi diskon 90%, jadi $0,20 di Sol dan $0,01 di Luna. Opus 5.5 memberi diskon 95%, jadi $0,20.
Bagian C: cache write
Token yang pertama kali disimpan ke cache. GPT-6 kini menagih 1,25x harga input: $2,50 di Sol dan $0,125 di Luna. Opus 5.5 menagih $5 untuk cache 5 menit dan $8 untuk cache 1 jam.
Bagian D: output, termasuk reasoning
Token reasoning dan token jawaban dibayar dengan harga output yang sama. Effort yang lebih tinggi menambah token reasoning, jadi effort mengubah biaya secara langsung.
| Aturan tagihan | GPT-6 Sol dan Luna | ClaudeClaude ProLangganan berbayar asisten AI Claude dari Anthropic. Langganan ini membuka connector ke alat luar.Buka glosarium Opus 5.5 |
|---|---|---|
| Umur cache | Minimal 30 menit setelah tulis atau pakai terakhir | 5 menit, atau 1 jam dengan cache write 2x |
| Diskon cache read | 90% | 95% |
| Cache write | 1,25x harga input | 1,25x (5 menit) atau 2x (1 jam) |
| Prompt di atas 272.000 token | 2x input dan cache, 1,5x output | Harga standar sampai 1 juta token |
| Batch API | 50% harga standar | 50% harga standar |
| Pemrosesan di wilayah tertentu | +10% bila tersedia | 1,1x untuk inference_geo us |
| Fast mode | 2x harga | $8 input dan $40 output |
Sumber: halaman model GPT-6 Sol, halaman model GPT-6 Luna, dan halaman harga Claude, dibaca 23 September 2026.
Tiga jebakan yang membuat hitungan meleset
Tiga hal membuat harga per token tidak setara antarvendor. Periksa ketiganya sebelum Anda membuat anggaran.
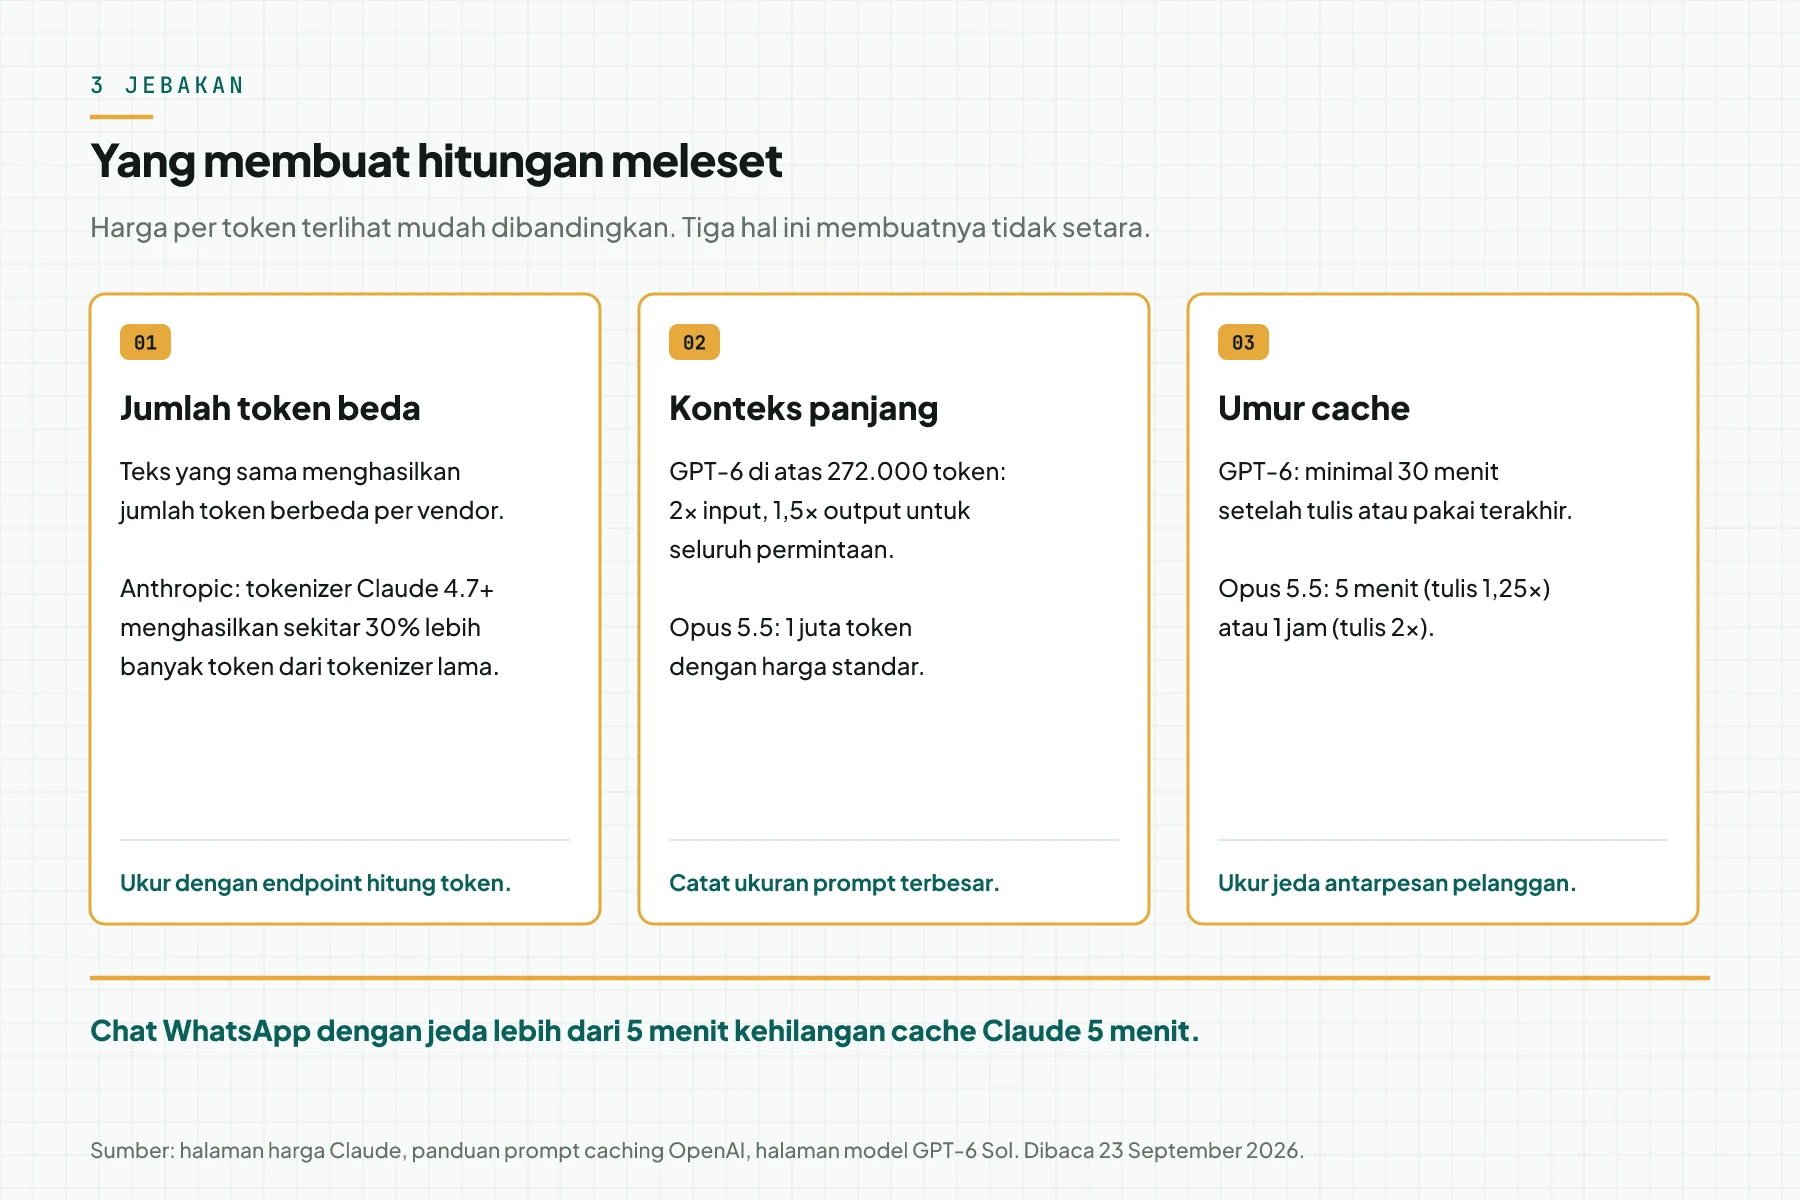
- Jumlah token berbeda. Anthropic menulis bahwa tokenizer Claude 4.7 dan sesudahnya menghasilkan sekitar 30% lebih banyak token daripada tokenizer lama Anthropic. Hitung teks Anda dengan endpoint hitung token tiap vendor.
- Konteks panjang. GPT-6 menaikkan harga seluruh permintaan di atas 272.000 token input. Opus 5.5 memakai harga standar sampai 1 juta token.
- Umur cache. Cache GPT-6 bertahan minimal 30 menit. Cache Opus 5.5 bertahan 5 menit, atau 1 jam dengan biaya tulis 2x.
Yang perlu Anda siapkan
- Log per permintaan dari API OpenAI dan Anthropic, bukan hanya total tagihan bulanan.
- Daftar jenis tugas dan volume per bulan, misalnya percakapan CS, sesi koding, atau dokumen.
- Tingkat berhasil per jenis tugas, dari pemeriksa otomatis atau review manusia.
- Kurs rupiah dengan tanggalnya. Kami memakai JISDOR Bank Indonesia 22 September 2026: Rp17.883 per USD.
- 1 lembar hitung atau skrip kecil untuk rumus di bawah.
Langkah 1: Baca 4 angka dari objek usage
Ambil 4 angka dari setiap respons API. Nama field-nya berbeda, dan arti input_tokens juga berbeda antarvendor.
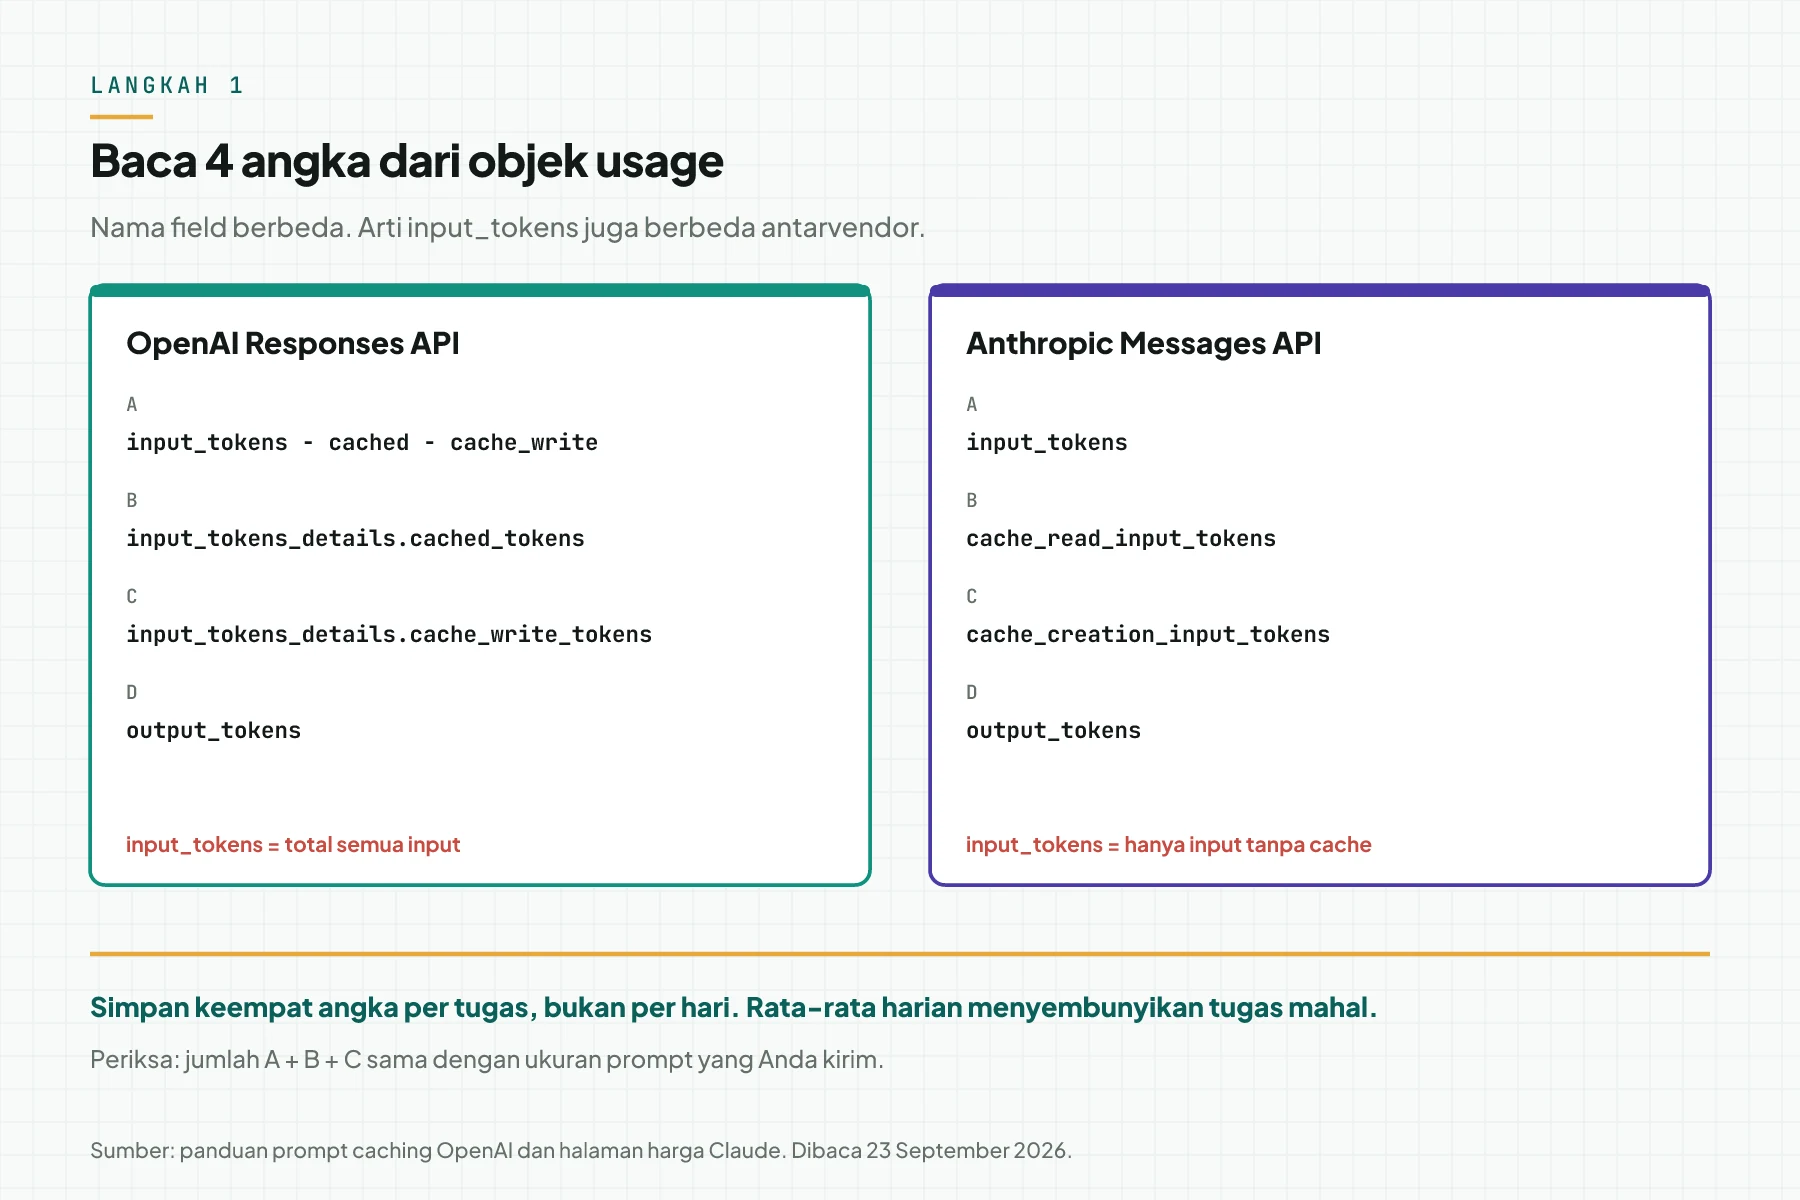
Fungsi berikut menghitung biaya 1 respons dari objek usage. Kami menguji kedua fungsi ini terhadap simulasi di artikel ini, termasuk premi 272.000 token.
const HARGA = { // USD per 1 juta token, 23 September 2026
  'gpt-6-sol':       { input: 2,   cached: 0.2,  write: 2.5,   output: 10 },
  'gpt-6-luna':      { input: 0.1, cached: 0.01, write: 0.125, output: 0.5 },
  'claude-opus-5-5': { input: 4,   cached: 0.2,  write: 5,     output: 20 },
};

function biayaOpenAI(model, u) {
  const cached = u.input_tokens_details?.cached_tokens ?? 0;
  const write = u.input_tokens_details?.cache_write_tokens ?? 0;
  const baru = u.input_tokens - cached - write;
  const panjang = u.input_tokens > 272000; // premi konteks panjang GPT-6
  const kIn = panjang ? 2 : 1, kOut = panjang ? 1.5 : 1, p = HARGA[model];
  return (kIn * (baru * p.input + cached * p.cached + write * p.write)
    + kOut * u.output_tokens * p.output) / 1e6;
}

function biayaAnthropic(model, u) {
  const p = HARGA[model]; // cache write 5 menit; cache 1 jam berharga $8
  return (u.input_tokens * p.input
    + (u.cache_read_input_tokens ?? 0) * p.cached
    + (u.cache_creation_input_tokens ?? 0) * p.write
    + u.output_tokens * p.output) / 1e6;
}
Periksa: untuk OpenAI, jumlah token baru, cached, dan cache write sama dengan input_tokens. Sumber field: panduan prompt caching OpenAI dan halaman harga Claude.
Langkah 2: Pisahkan token cache dari token baru
Hitung 1 percakapan dengan dan tanpa cache untuk melihat dampaknya. Simulasi kami memakai 4 giliran, prompt tetap 4.500 token, total 24.000 token input, dan 1.600 token output.
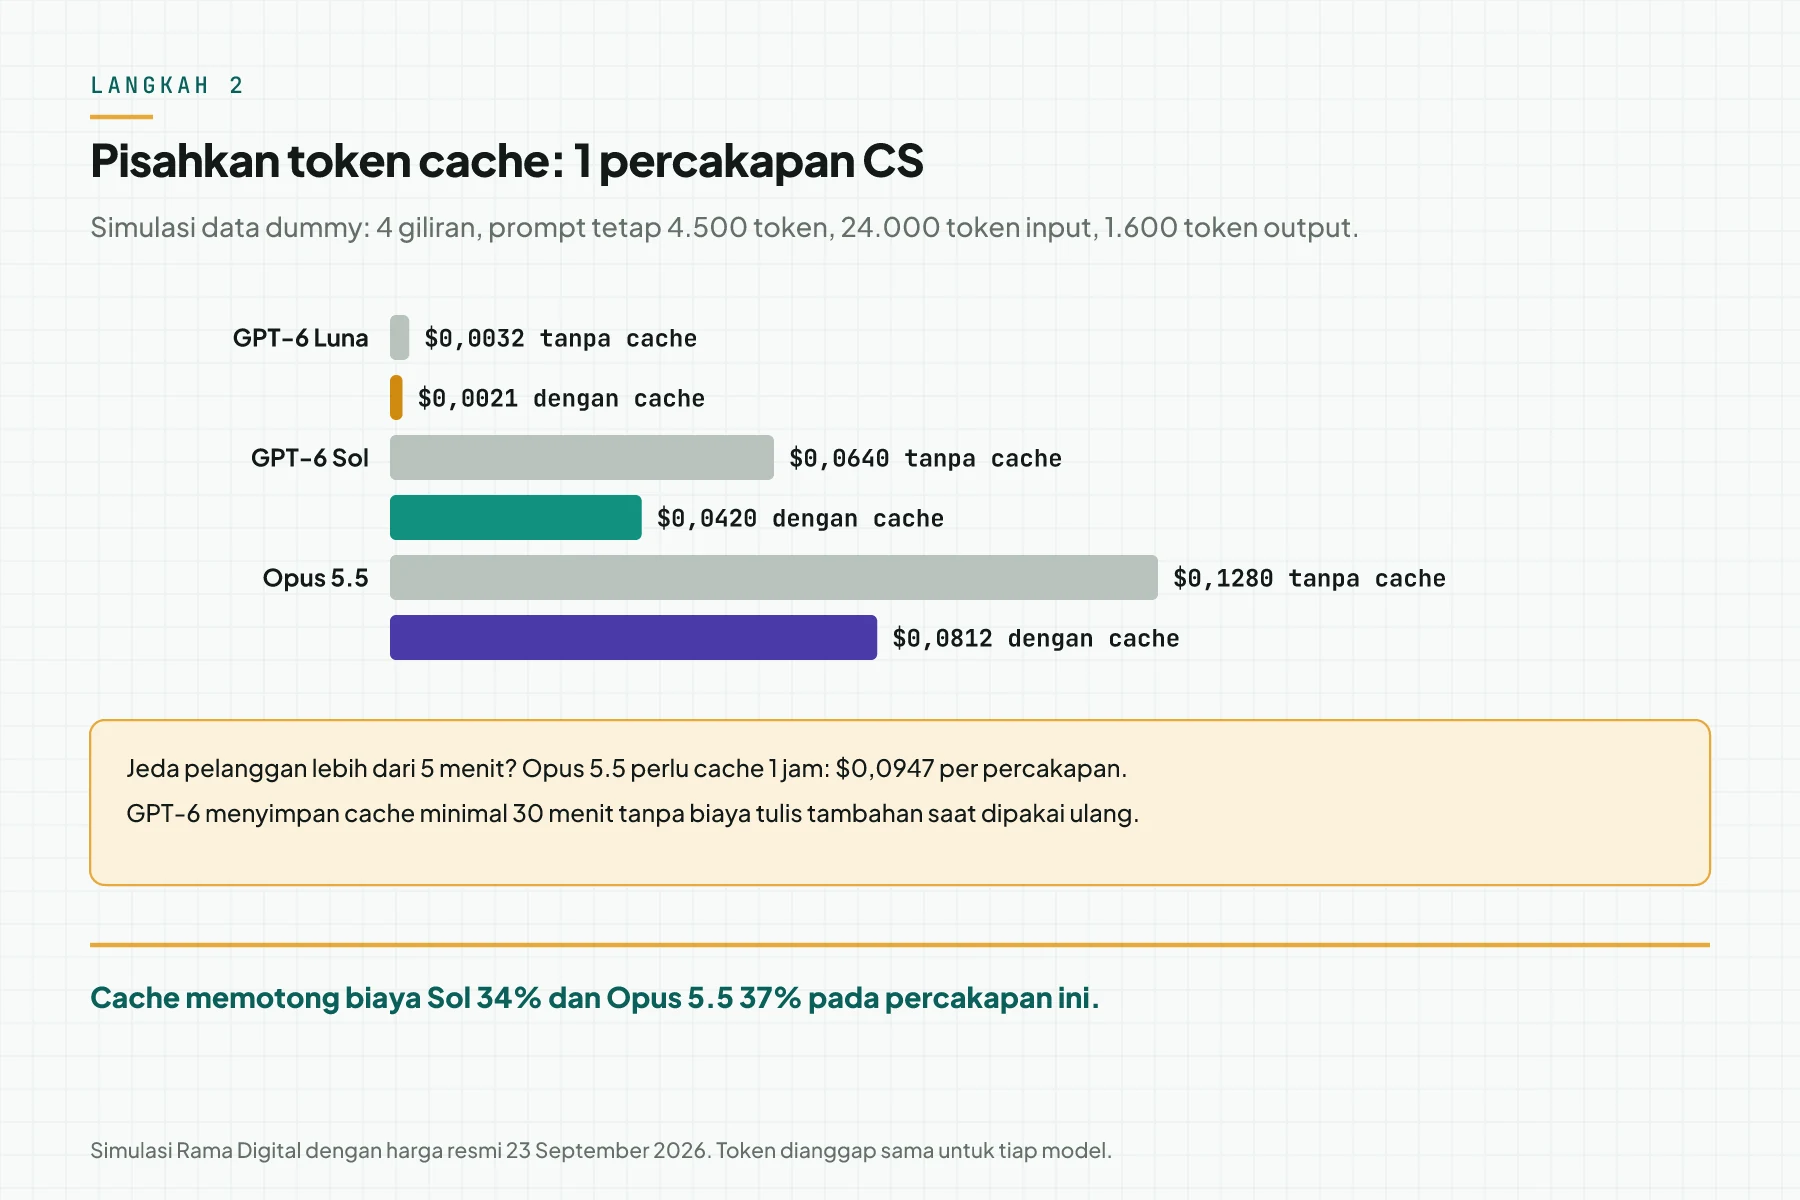
| Model | Tanpa cache | Dengan cache | Hemat |
|---|---|---|---|
| GPT-6 Luna | $0,0032 | $0,0021 | 34% |
| GPT-6 Sol | $0,0640 | $0,0420 | 34% |
| Claude Opus 5.5 | $0,1280 | $0,0812 | 37% |
Periksa: pada log nyata, porsi cache read Anda mendekati asumsi ini. Bila jeda pelanggan sering lebih dari 5 menit, pakai cache 1 jam di Opus 5.5 atau terima cache miss.
Langkah 3: Cek premi konteks panjang
Catat ukuran prompt terbesar per jenis tugas. Di atas 272.000 token, keunggulan harga Sol atas Opus 5.5 hampir hilang.
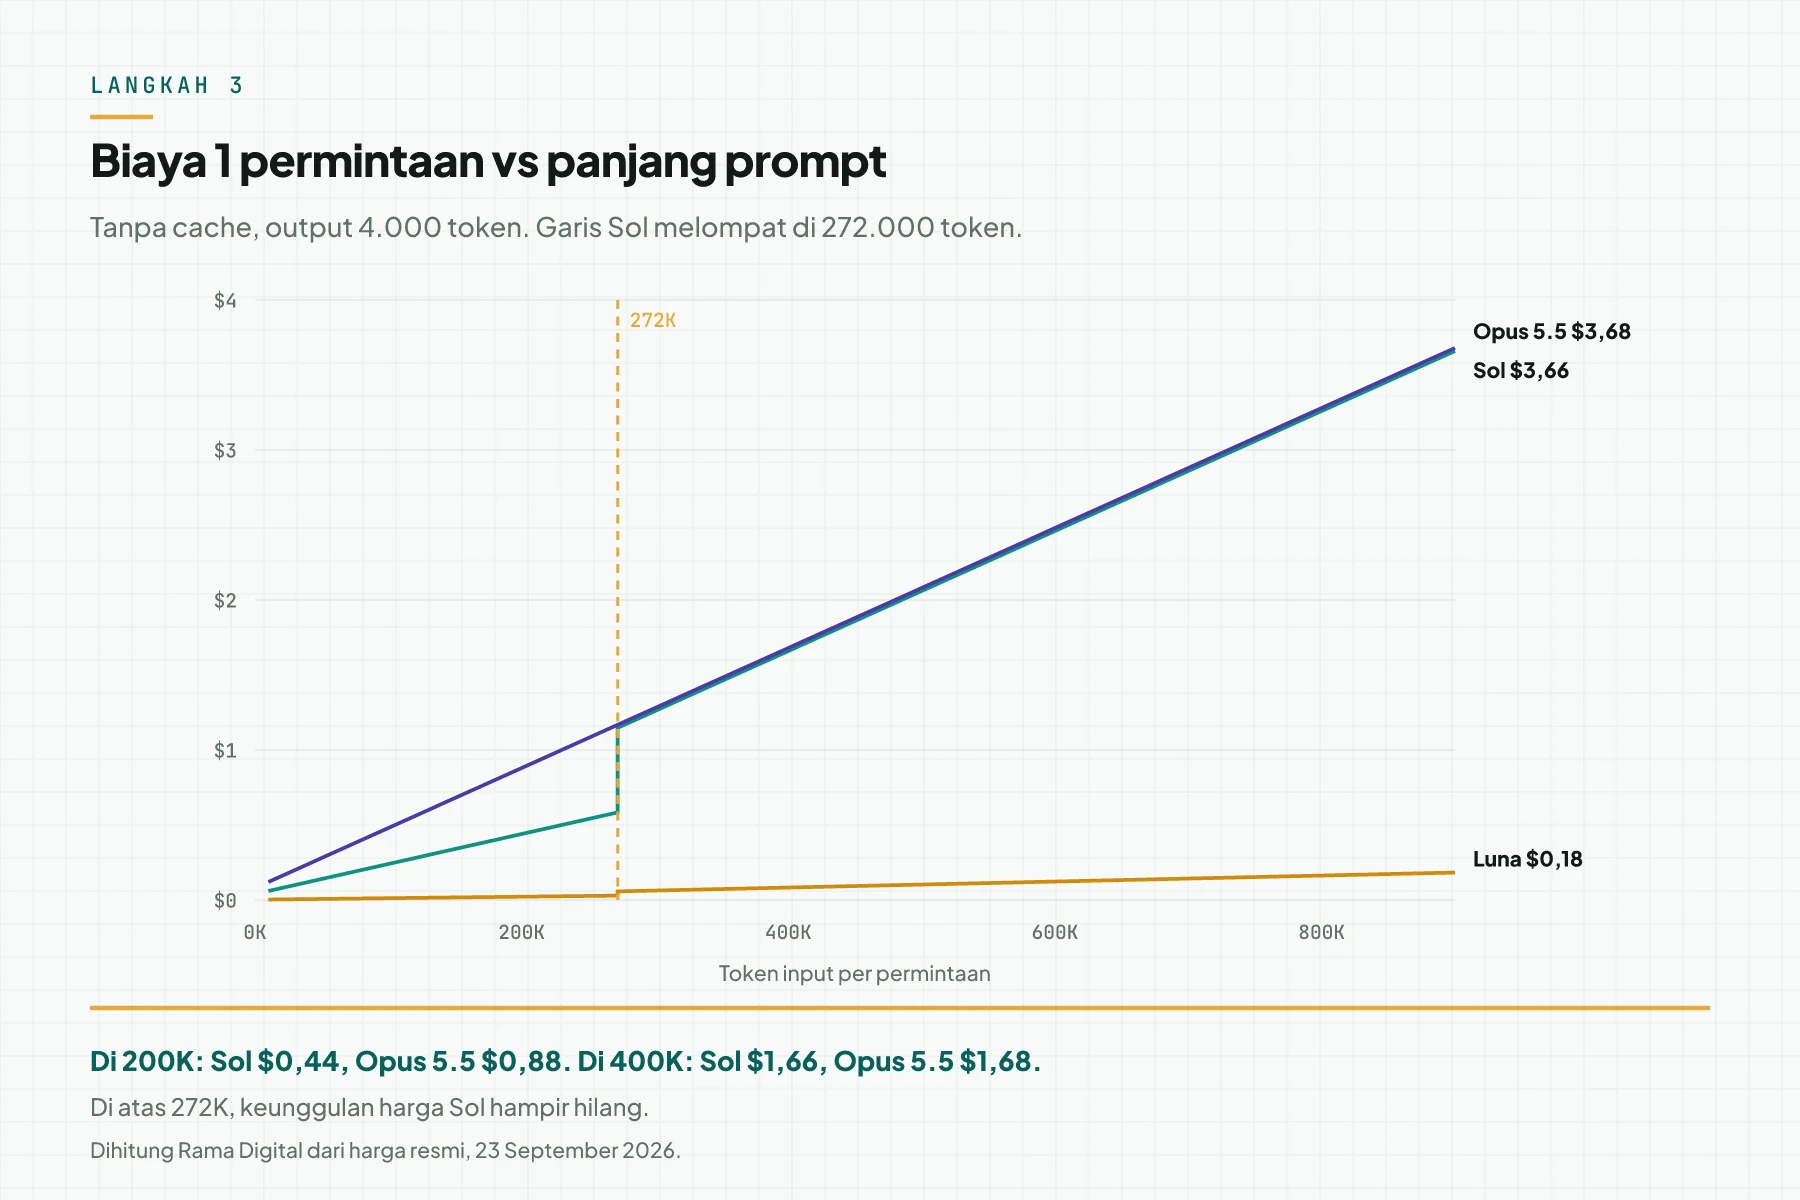
| Prompt tanpa cache, output 4.000 token | GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|---|
| 100.000 token | $0,01 | $0,24 | $0,48 |
| 200.000 token | $0,02 | $0,44 | $0,88 |
| 400.000 token | $0,08 | $1,66 | $1,68 |
| 800.000 token | $0,16 | $3,26 | $3,28 |
Periksa: tidak ada jenis tugas Anda yang berada di antara 250.000 dan 272.000 token tanpa alarm. Aturan lengkapnya ada di panduan migrasi GPT-6 Sol dan Luna.
Langkah 4: Kalikan dengan volume dan kurs
Kalikan biaya 1 tugas dengan volume per bulan, lalu dengan kurs JISDOR. Tabel berikut memakai 3 beban kerja simulasi dengan data dummy.
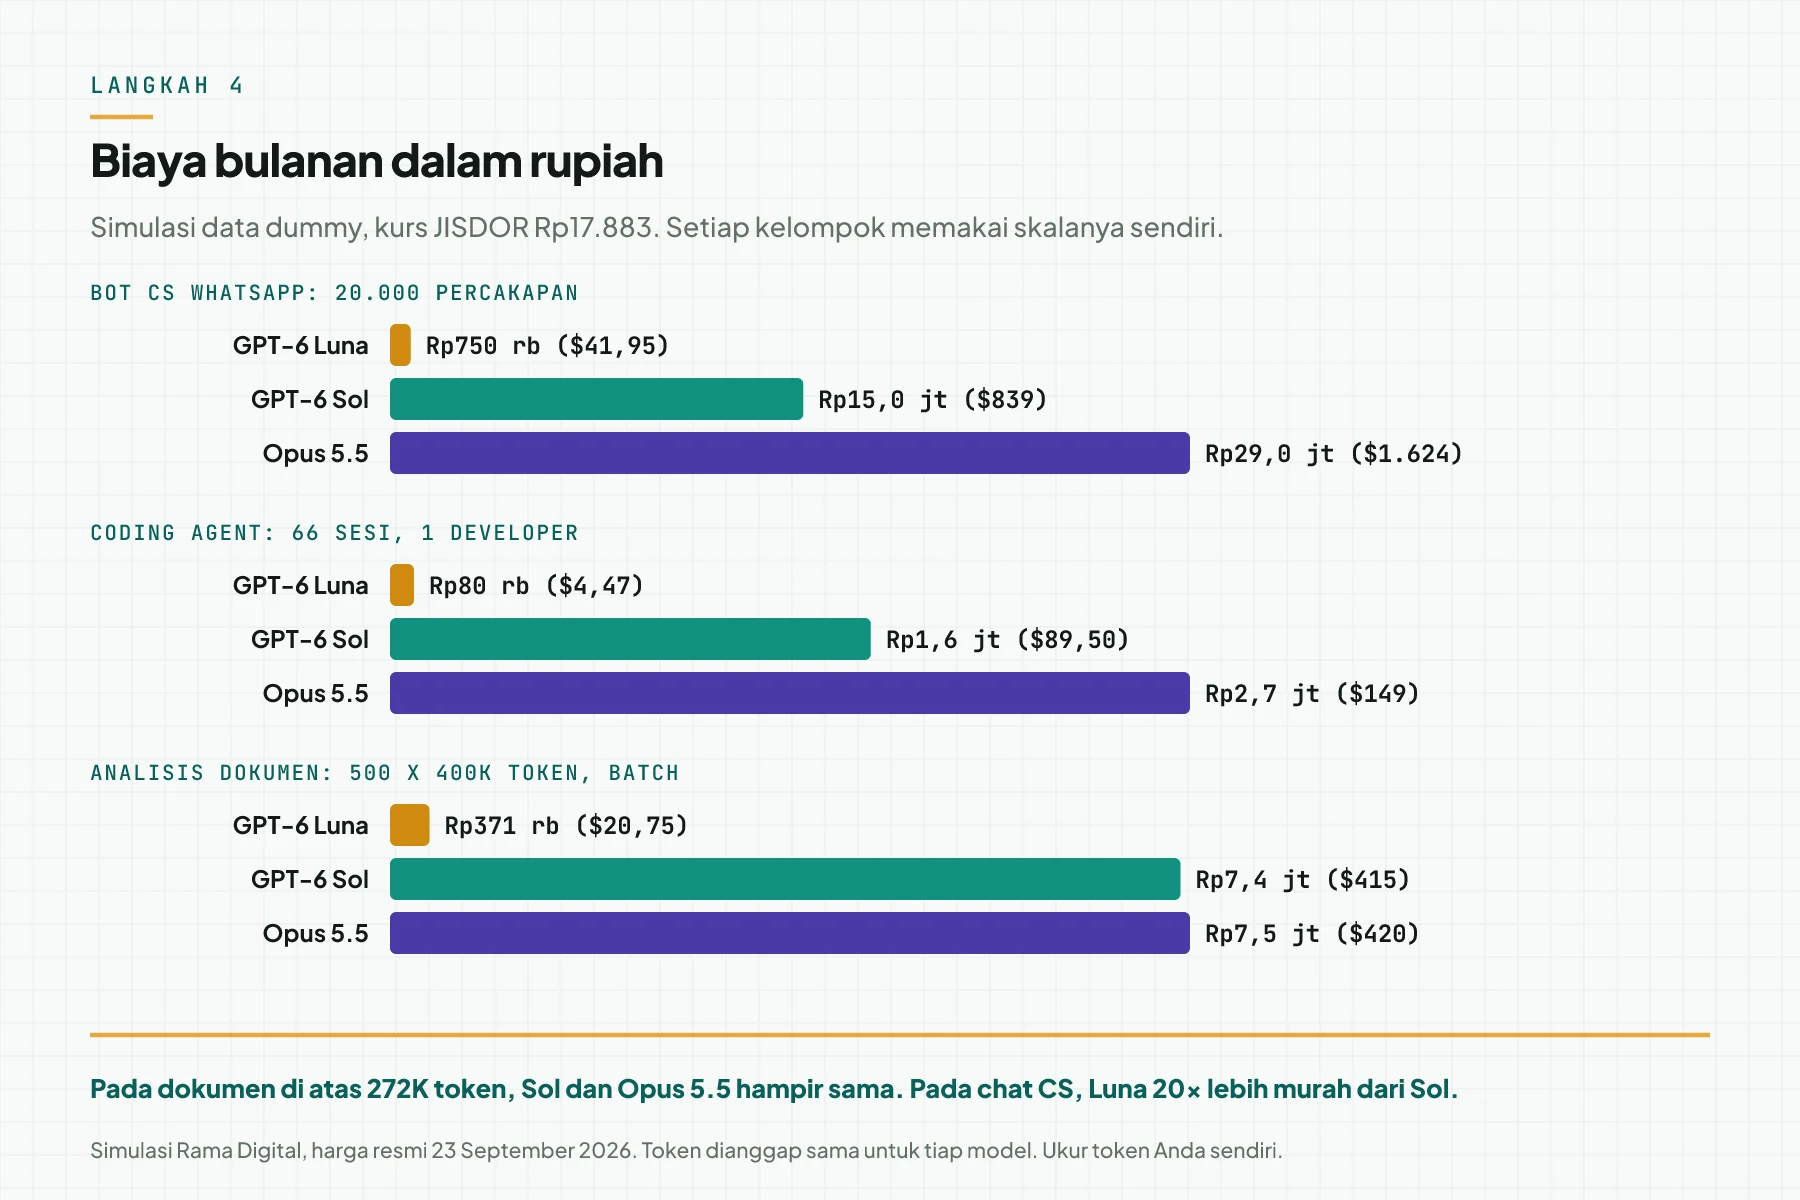
| Beban kerja simulasi | Asumsi per unit | GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|---|---|
| Bot CS WhatsApp, 20.000 percakapan | 24.000 token input, 75% dari cache; 1.600 token output | Rp750 ribu | Rp15,0 juta | Rp29,0 juta |
| Coding agentAgent AIProgram AI yang mengerjakan langkah pekerjaan sendiri, misalnya membaca pesan, menyiapkan balasan, lalu mencatat hasilnya.Buka glosarium, 66 sesi | 40 giliran x 60.000 token, 95% dari cache; 60.000 token output | Rp80 ribu | Rp1,6 juta | Rp2,7 juta |
| Analisis dokumen, 500 dokumen | 400.000 token input, 4.000 token output, Batch API | Rp371 ribu | Rp7,4 juta | Rp7,5 juta |
Angka ini memakai jumlah token yang sama untuk tiap model. Pada pemakaian nyata, Opus 5.5 sering memakai lebih sedikit token per tugas, dan Luna pada effort max memakai lebih banyak token daripada Luna medium.
Periksa: total simulasi Anda berada dalam 20% dari tagihan bulan lalu. Bila selisihnya lebih besar, asumsi token atau volume Anda salah.
Langkah 5: Bagi dengan tingkat berhasil
Tugas yang gagal tetap dibayar. Bagi biaya per tugas dengan tingkat berhasil agar Anda melihat biaya per hasil yang dapat dipakai.
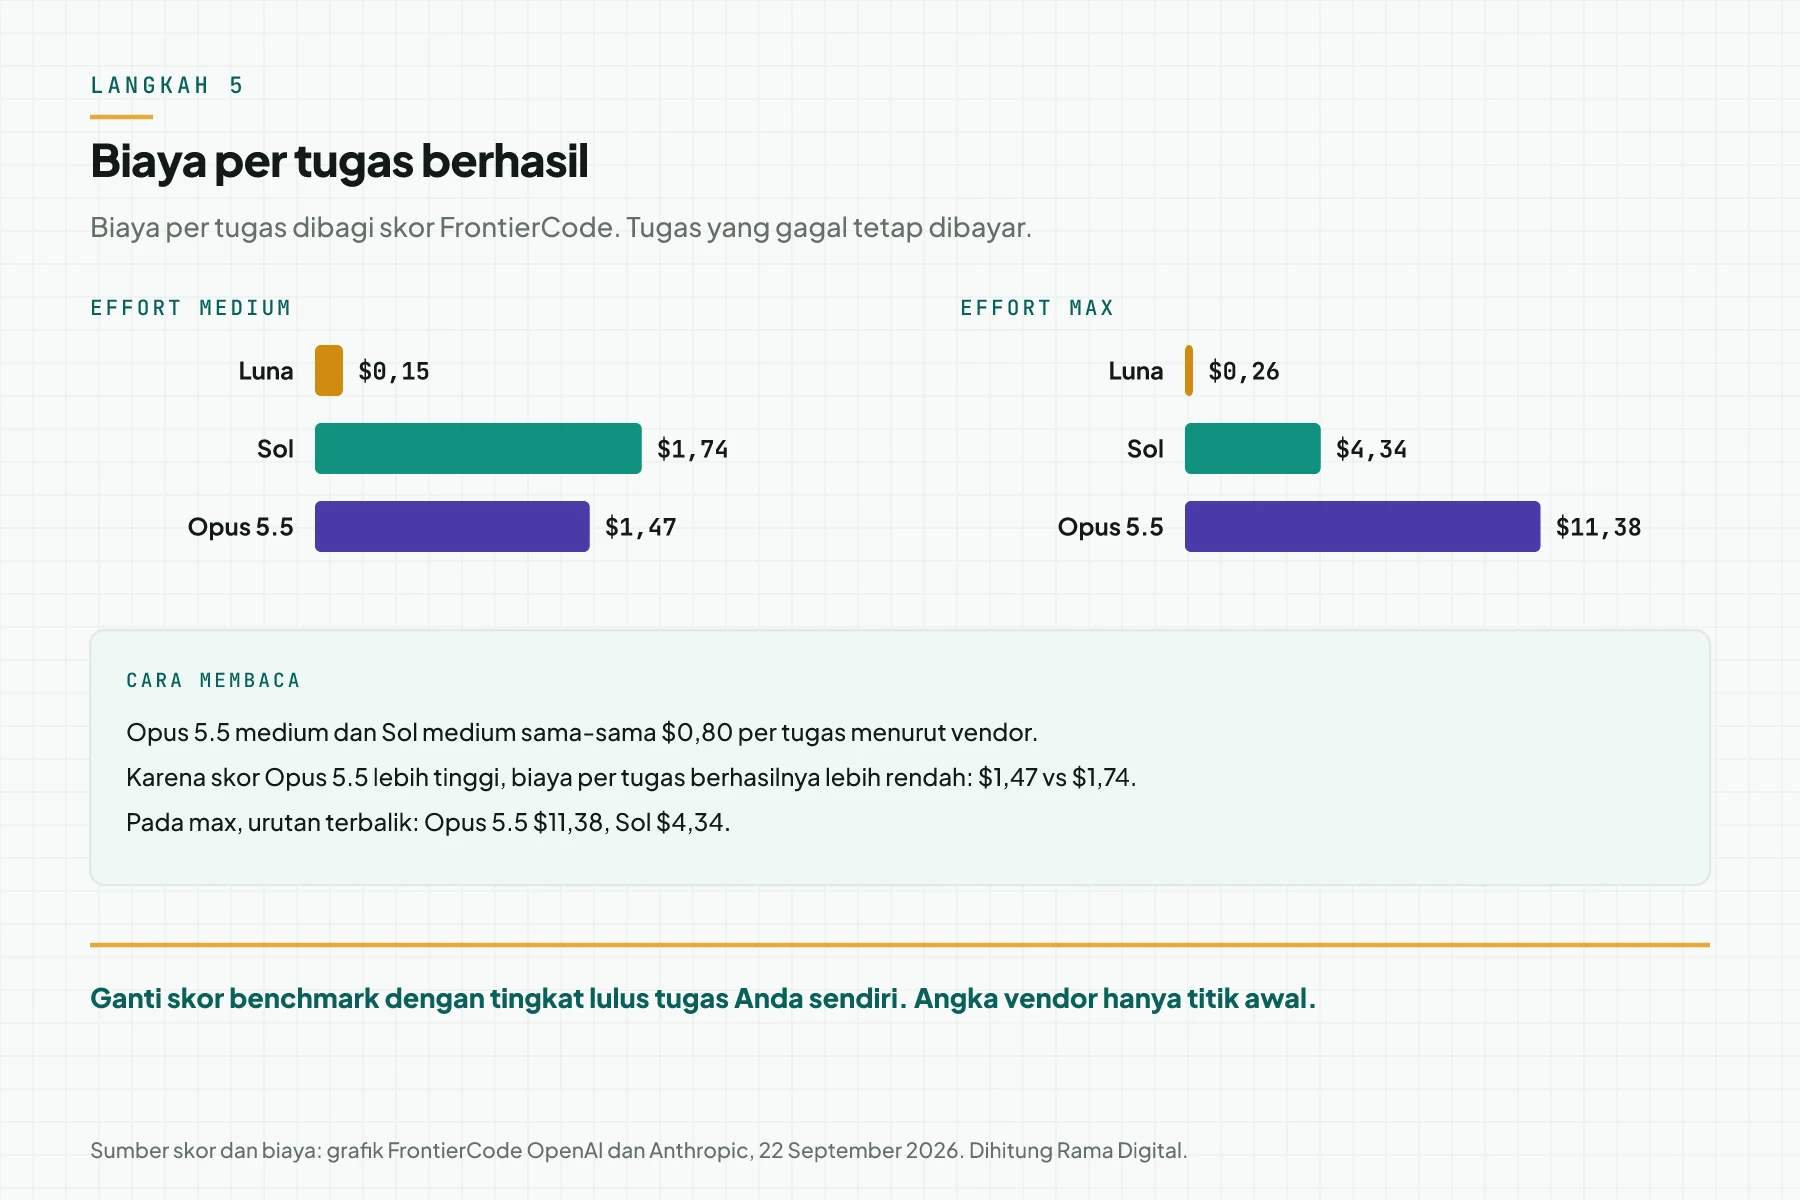
| FrontierCode 1.1 | Biaya per tugas | Skor | Biaya per tugas berhasil |
|---|---|---|---|
| GPT-6 Luna medium | $0,053 | 35,5% | $0,15 |
| GPT-6 Sol medium | $0,80 | 45,9% | $1,74 |
| Claude Opus 5.5 medium | $0,80 | 54,6% | $1,47 |
| GPT-6 Sol max | $2,14 | 49,3% | $4,34 |
| Claude Opus 5.5 max | $6,19 | 54,4% | $11,38 |
Skor dan biaya berasal dari grafik OpenAI dan Anthropic, jadi keduanya klaim vendor. Ganti skor itu dengan tingkat lulus 20 tugas Anda sendiri. Cara mengujinya ada di perbandingan GPT-6 Sol, Luna, dan Claude Opus 5.5.
Contoh kerja: anggaran 1 bulan untuk UMKM dummy
Simulasi dengan data dummy. Toko online "Kopi Sleman" menjalankan bot CS dan 1 developer dengan coding agent. Rencana routing: Luna untuk CS, Sol untuk koding.
| Tanggal | Input | Yang sistem catat | Keluaran |
|---|---|---|---|
| 1 Oktober 2026 | Anggaran awal dari simulasi | CS di Luna Rp750 ribu, koding di Sol Rp1,6 juta | Rencana Rp2,4 juta per bulan |
| 8 Oktober 2026 | Log minggu pertama | Porsi cache CS 68%, bukan 75% | Naikkan estimasi CS 10% |
| 15 Oktober 2026 | Tingkat lulus CS | 94% lulus skema, 6% naik ke Sol | Tambah biaya eskalasi |
| 31 Oktober 2026 | Tagihan akhir | Selisih 12% dari rencana | Asumsi valid, pakai untuk bulan berikutnya |
Tanggal di tabel ini adalah rencana simulasi, bukan data nyata. Polanya yang penting: rencana, ukur 1 minggu, koreksi asumsi, lalu bandingkan dengan tagihan.
Checklist hitung biaya
- Simpan 4 angka usage per permintaan. Pemilik: developer. Bukti: skema tabel log.
- Kelompokkan permintaan per jenis tugas. Pemilik: developer. Bukti: kolom jenis tugas di log.
- Hitung porsi cache read per jenis tugas. Pemilik: developer. Bukti: laporan mingguan porsi cache.
- Catat prompt terbesar dan pasang alarm di 250.000 token. Pemilik: ops. Bukti: aturan alarm.
- Ukur tingkat berhasil per jenis tugas. Pemilik: kepala tim. Bukti: hasil pemeriksa atau review.
- Ubah biaya ke rupiah dengan kurs bertanggal. Pemilik: finance. Bukti: lembar hitung dengan sumber kurs.
- Bandingkan simulasi dengan tagihan bulan lalu. Pemilik: finance. Bukti: selisih dalam persen.
- Berhenti memakai simulasi dan ukur ulang bila selisihnya lebih dari 20%.
Model termurah bergantung pada bentuk beban kerja
Rekomendasi Rama Digital berikut berlaku untuk harga 23 September 2026 dan simulasi di atas.
| Bentuk beban kerja | Model termurah per tugas berhasil | Kondisi |
|---|---|---|
| Volume tinggi, prompt pendek, hasil dicek kode | GPT-6 Luna | Effort high untuk tugas yang memuat angka |
| Koding harian dengan cache tinggi | GPT-6 Sol | Tingkat lulus Sol pada tugas Anda dekat dengan Opus 5.5 |
| Koding sulit yang sering gagal di Sol | Claude Opus 5.5 medium | Biaya per tugas berhasil lebih rendah pada FrontierCode medium |
| Dokumen di atas 272.000 token | Sol dan Opus 5.5 hampir sama | Pilih yang tingkat lulusnya lebih tinggi |
| Chat dengan jeda panjang | GPT-6 | Cache 30 menit tanpa biaya tulis ulang saat dipakai |
Pilih model dengan biaya per tugas berhasil terendah, bukan harga token terendah. Hitung ulang setiap 30 hari, karena harga dan versi model berubah cepat.
Pertanyaan yang sering muncul
Apakah token reasoning ikut dibayar? Ya. Token reasoning dibayar dengan harga output. Effort yang lebih tinggi menambah token reasoning, jadi biaya naik bersama effort.
Kurs apa yang sebaiknya dipakai untuk anggaran? Pakai kurs bertanggal dari sumber resmi. Kami memakai JISDOR Bank Indonesia 22 September 2026, Rp17.883 per USD.
Kenapa input_tokens OpenAI dan Anthropic tidak dapat dibandingkan langsung? Di OpenAI, input_tokens adalah total semua input termasuk cache. Di Anthropic, input_tokens hanya input tanpa cache.
Apakah Batch API dapat digabung dengan cache? Anthropic menulis bahwa diskon Batch API dan prompt caching dapat digabung. Periksa perilaku yang sama di invoice OpenAI Anda sebelum memakainya dalam anggaran.
Seberapa sering hitungan ini perlu diperbarui? Perbarui setiap 30 hari, atau segera setelah vendor mengubah harga atau merilis model baru.
Langkah berikutnya
Batas yang tetap berlaku: simulasi ini memakai token yang sama untuk tiap model, dan tokenizer tiap vendor berbeda. Anggaran yang aman memakai log 1 minggu dari sistem Anda sendiri.
Bila Anda ingin kami memetakan alur kerja dan menghitung effort serta dampaknya, buka AI Workflow Audit. Untuk membahasnya dulu, pilih jadwal Konsultasi Awal 30 menit.