Jawaban langsung: pakai GPT-6 Luna untuk pekerjaan bervolume tinggi yang hasilnya dapat dicek kode. Pakai GPT-6 Sol untuk agentAgent AIProgram AI yang mengerjakan langkah pekerjaan sendiri, misalnya membaca pesan, menyiapkan balasan, lalu mencatat hasilnya.Buka glosarium dengan tool dan koding harian. Pakai ClaudeClaude ProLangganan berbayar asisten AI Claude dari Anthropic. Langganan ini membuka connector ke alat luar.Buka glosarium Opus 5.5 untuk tugas panjang yang salahnya mahal. Luna berharga $0,10 dan $0,50 per 1 juta token input dan output. Sol berharga $2 dan $10. Opus 5.5 berharga $4 dan $20.
Kondisi utama: pembagian ini berlaku bila Anda mengukur biaya per tugas yang berhasil, bukan harga per token. Batas: benchmark vendor tidak membandingkan ketiga model secara langsung, jadi uji tetap wajib pada 20 tugas nyata Anda sebelum memindahkan trafik.
Kami membaca halaman resmi OpenAI, Anthropic, dan Artificial Analysis pada 23 September 2026. Pada hari yang sama kami menguji ketiga model dengan prompt yang sama, 18 panggilan pada effort medium dan 6 panggilan tambahan untuk Luna. Contoh bisnis di artikel ini memakai data dummy.
Tiga rilis dalam 1 hari membuat pilihan lebih sulit
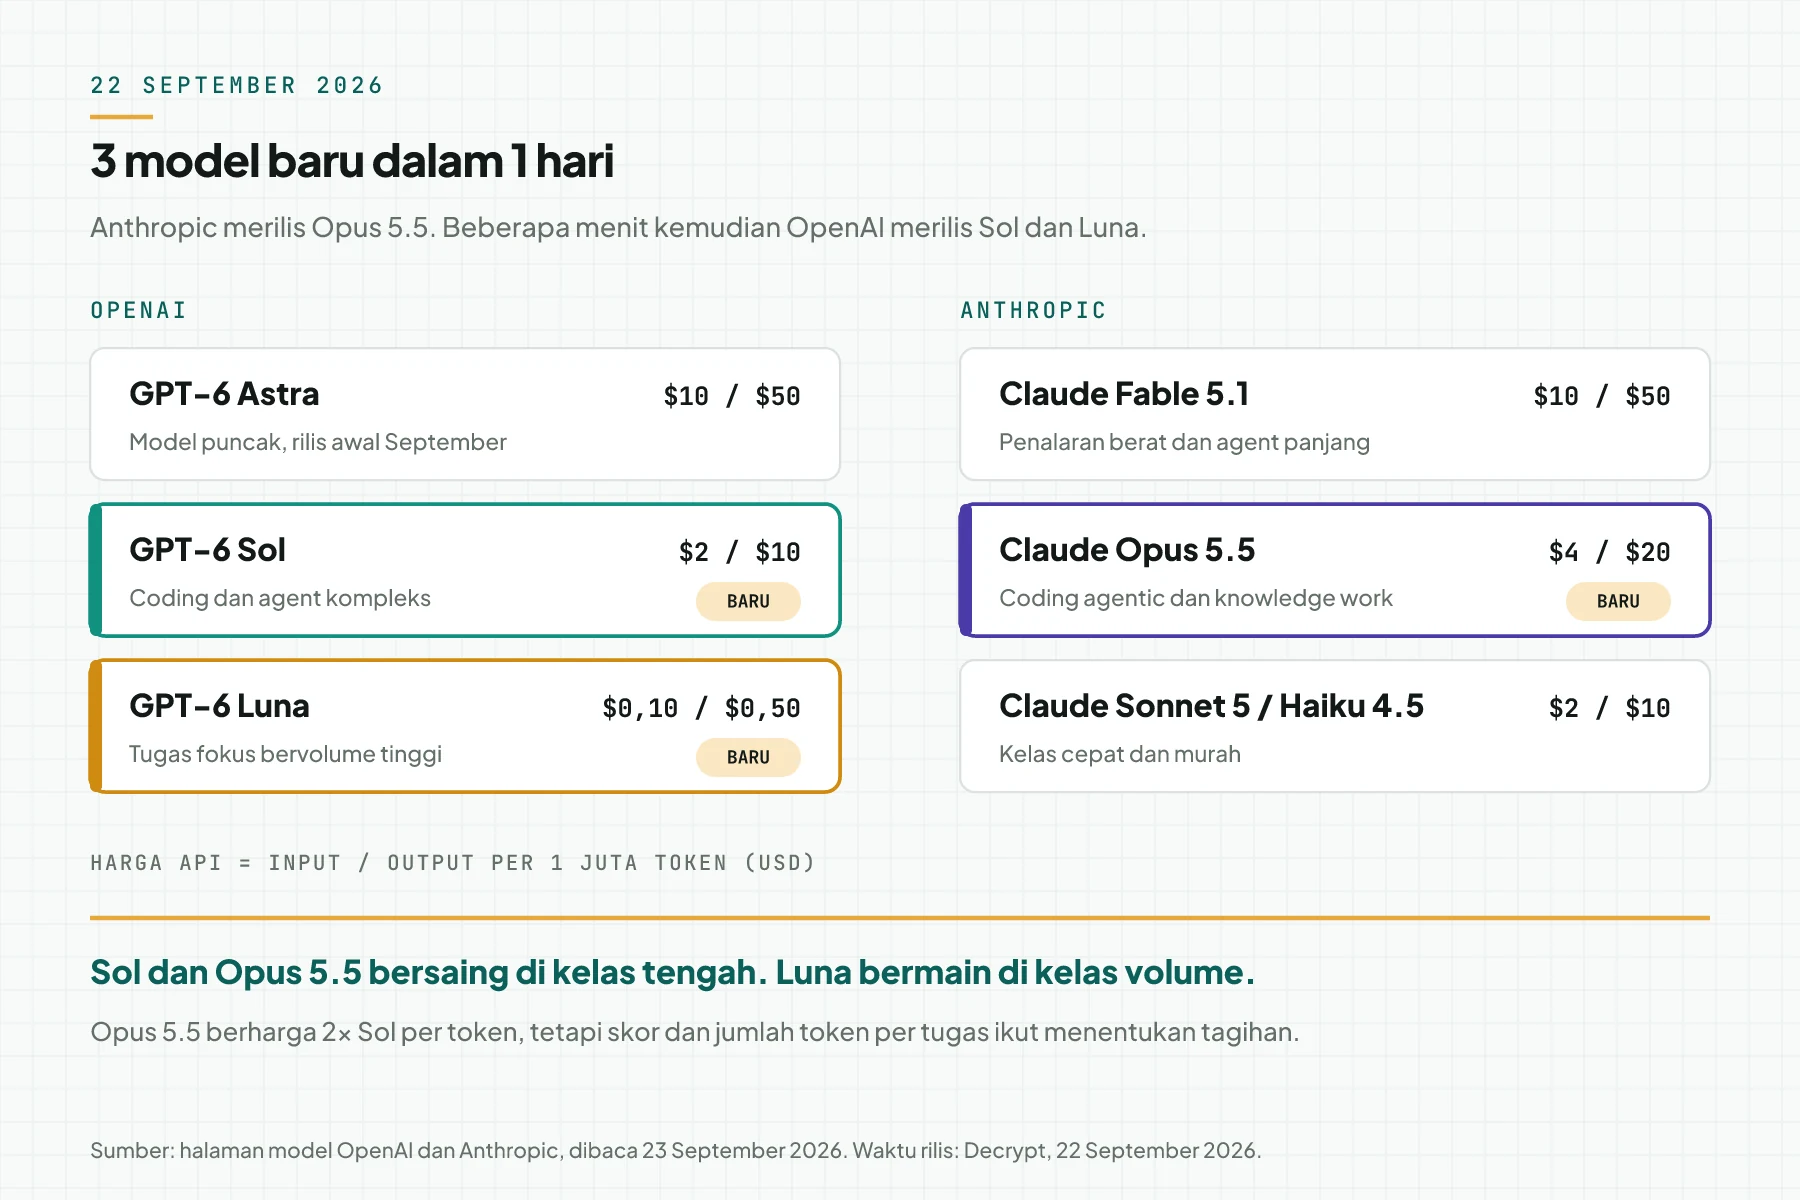
Anthropic merilis Claude Opus 5.5 pada 22 September 2026. OpenAI merilis GPT-6 Sol dan GPT-6 Luna pada hari yang sama. Decrypt melaporkan jarak kedua rilis hanya beberapa menit.
Masalahnya sederhana. Tiap vendor membandingkan modelnya dengan model lama pesaing, bukan dengan rilis baru pesaing. OpenAI membandingkan Sol dengan Claude Opus 5 dan Fable 5.1. Anthropic membandingkan Opus 5.5 dengan GPT-6 Astra dan GPT-5.6 Sol.
Tim yang memakai lebih dari 1 model sekarang harus memilih ulang. Jika Anda sebelumnya memakai GPT-5.6, baca juga cara kami membaca Sol, Terra, dan Luna pada GPT-5.6. Jika Anda memakai Opus 5, bandingkan dengan catatan rilis Claude Opus 5.
Spesifikasi dan harga berdampingan
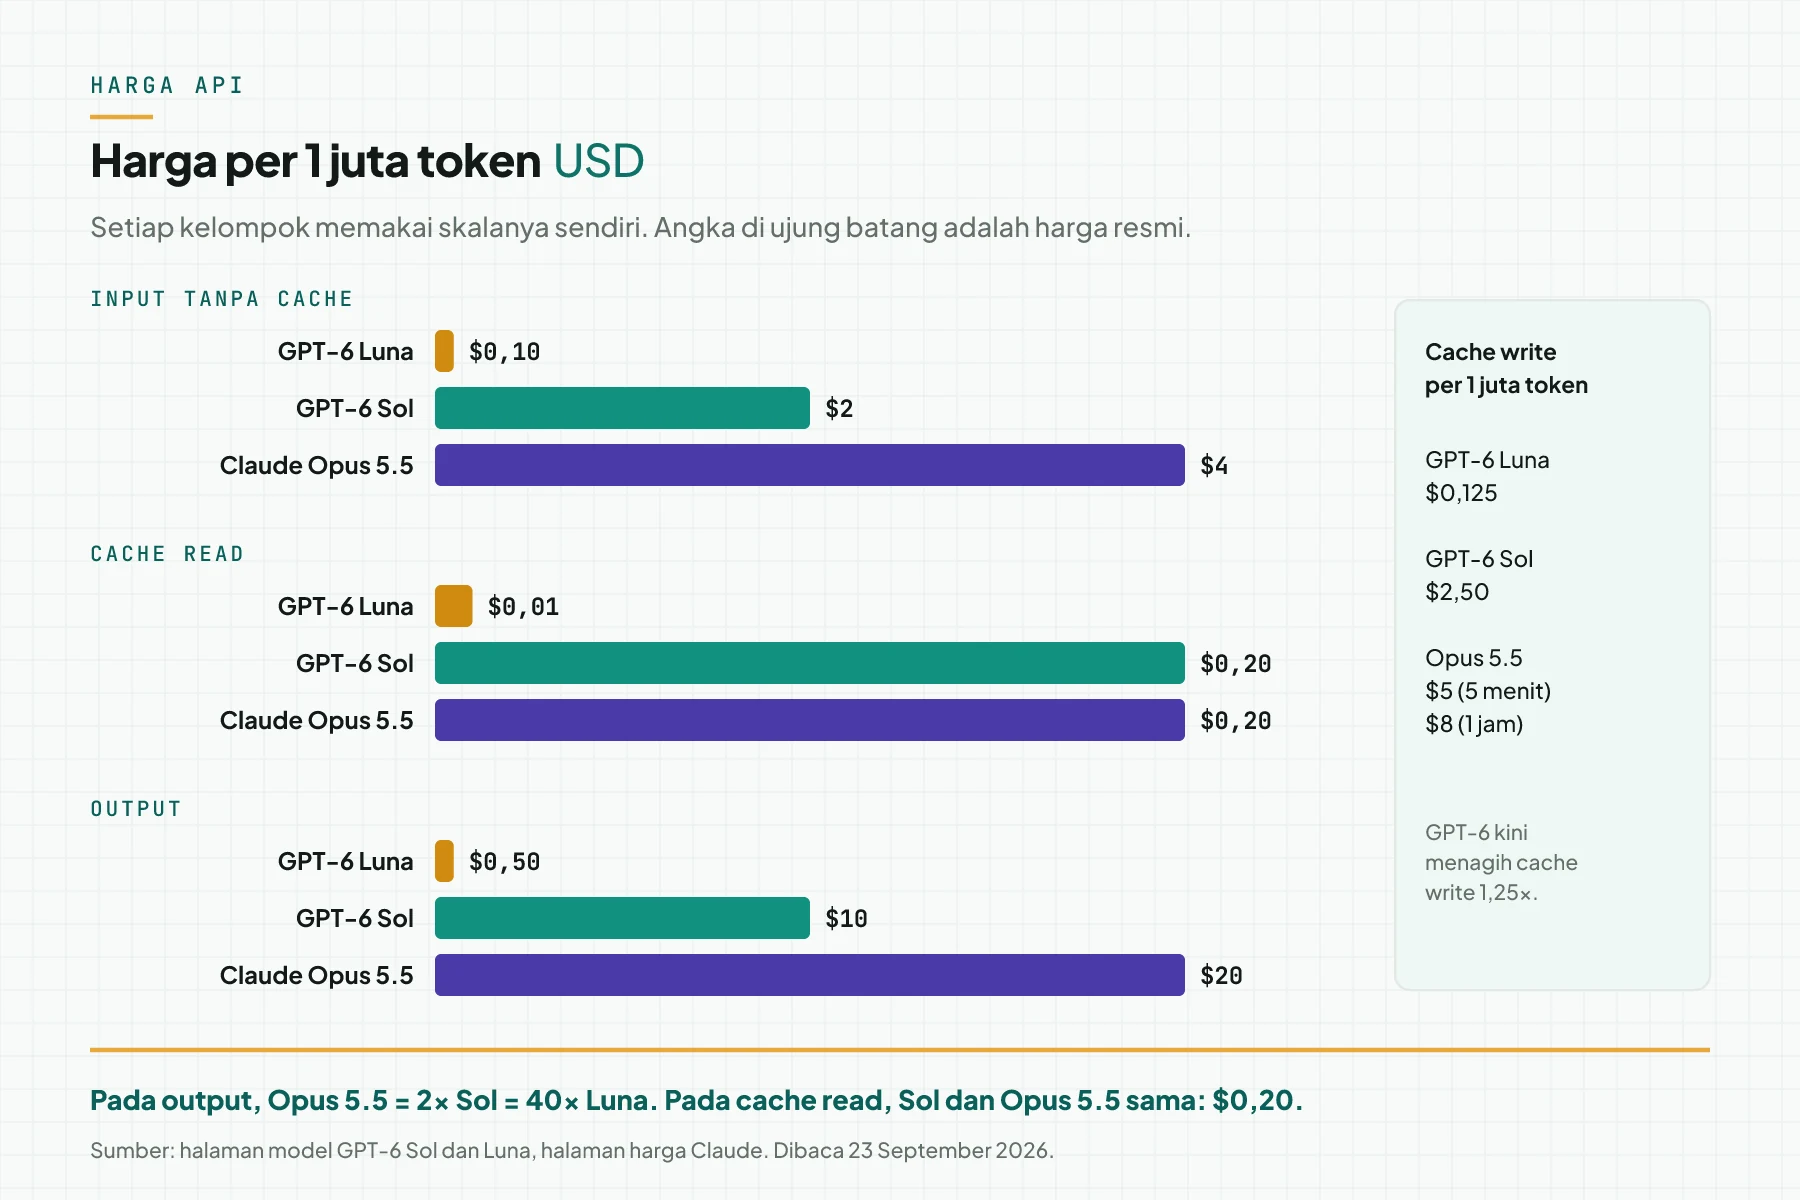
Tabel berikut memakai angka dari halaman model resmi. Harga tertulis dalam USD per 1 juta token pada pemrosesan standar, dibaca 23 September 2026.
| Item | GPT-6 Sol | GPT-6 Luna | Claude Opus 5.5 |
|---|---|---|---|
| ID APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium | gpt-6-sol | gpt-6-luna | claude-opus-5-5 |
| Input / output | $2 / $10 | $0,10 / $0,50 | $4 / $20 |
| Cache read | $0,20 | $0,01 | $0,20 |
| Cache write | $2,50 | $0,125 | $5 (5 menit), $8 (1 jam) |
| Konteks / output maksimal | 1.050.000 / 128.000 token | 1.050.000 / 128.000 token | 1 juta / 128.000 token |
| Prompt di atas 272.000 token | 2x input, 1,5x output | 2x input, 1,5x output | Harga standar |
| Knowledge cutoff | 20 April 2026 | 18 Mei 2026 | Juni 2026 (reliable) |
| Level effort | none sampai max, default medium | none sampai max, default medium | low sampai max, default medium |
| Batch | 50% harga standar | 50% harga standar | $2 / $10 |
Sumber: halaman model GPT-6 Sol, halaman model GPT-6 Luna, ringkasan model Claude, dan halaman harga Claude.
Dua baris sering terlewat. Pertama, GPT-6 kini menagih cache write sebesar 1,25x harga input. Kedua, Opus 5.5 tidak memakai premi konteks panjang, jadi prompt 900.000 token berharga sama per token dengan prompt 9.000 token.
Ketersediaan di aplikasi
Sol dan Luna tersedia di ChatGPT Work dan Codex untuk paket Plus, Pro, Business, Enterprise, dan Edu. Pengguna Free dan Go mendapat Luna di aplikasi desktop. OpenAI menulis bahwa kedua model belum ada di Chat biasa.
Opus 5.5 tersedia di Claude Platform, Amazon Web Services, Google Cloud, dan Microsoft Azure. Anthropic juga menaikkan batas pemakaian 5 jam untuk paket Pro, Max, Team, dan Enterprise berbasis kursi. Di GitHub Copilot, Sol dan Luna tersedia sejak 22 September 2026.
Benchmark: yang dapat dibandingkan dan yang tidak
Angka benchmark hanya berguna bila metodenya sama. Kami memisahkan 3 jenis data. Jenis pertama adalah benchmark yang dipublikasikan kedua vendor. Jenis kedua memiliki angka mirip tetapi cara hitung beda. Jenis ketiga adalah uji independen dengan harness yang sama.
FrontierCode: 1 benchmark, 2 vendor
FrontierCode 1.1 Main menilai apakah perubahan kode siap digabung ke codebase nyata. OpenAI dan Anthropic sama-sama memuat grafik skor per level effort untuk benchmark ini. Kedua grafik mencatat skor Fable 5.1 max yang sama, 50,3%, jadi skala skornya cocok.
Pada effort medium, Opus 5.5 mencapai 54,6% dan Sol mencapai 45,9%. Keduanya tercatat $0,80 per tugas. Luna medium mencapai 35,5% dengan biaya $0,053 per tugas.
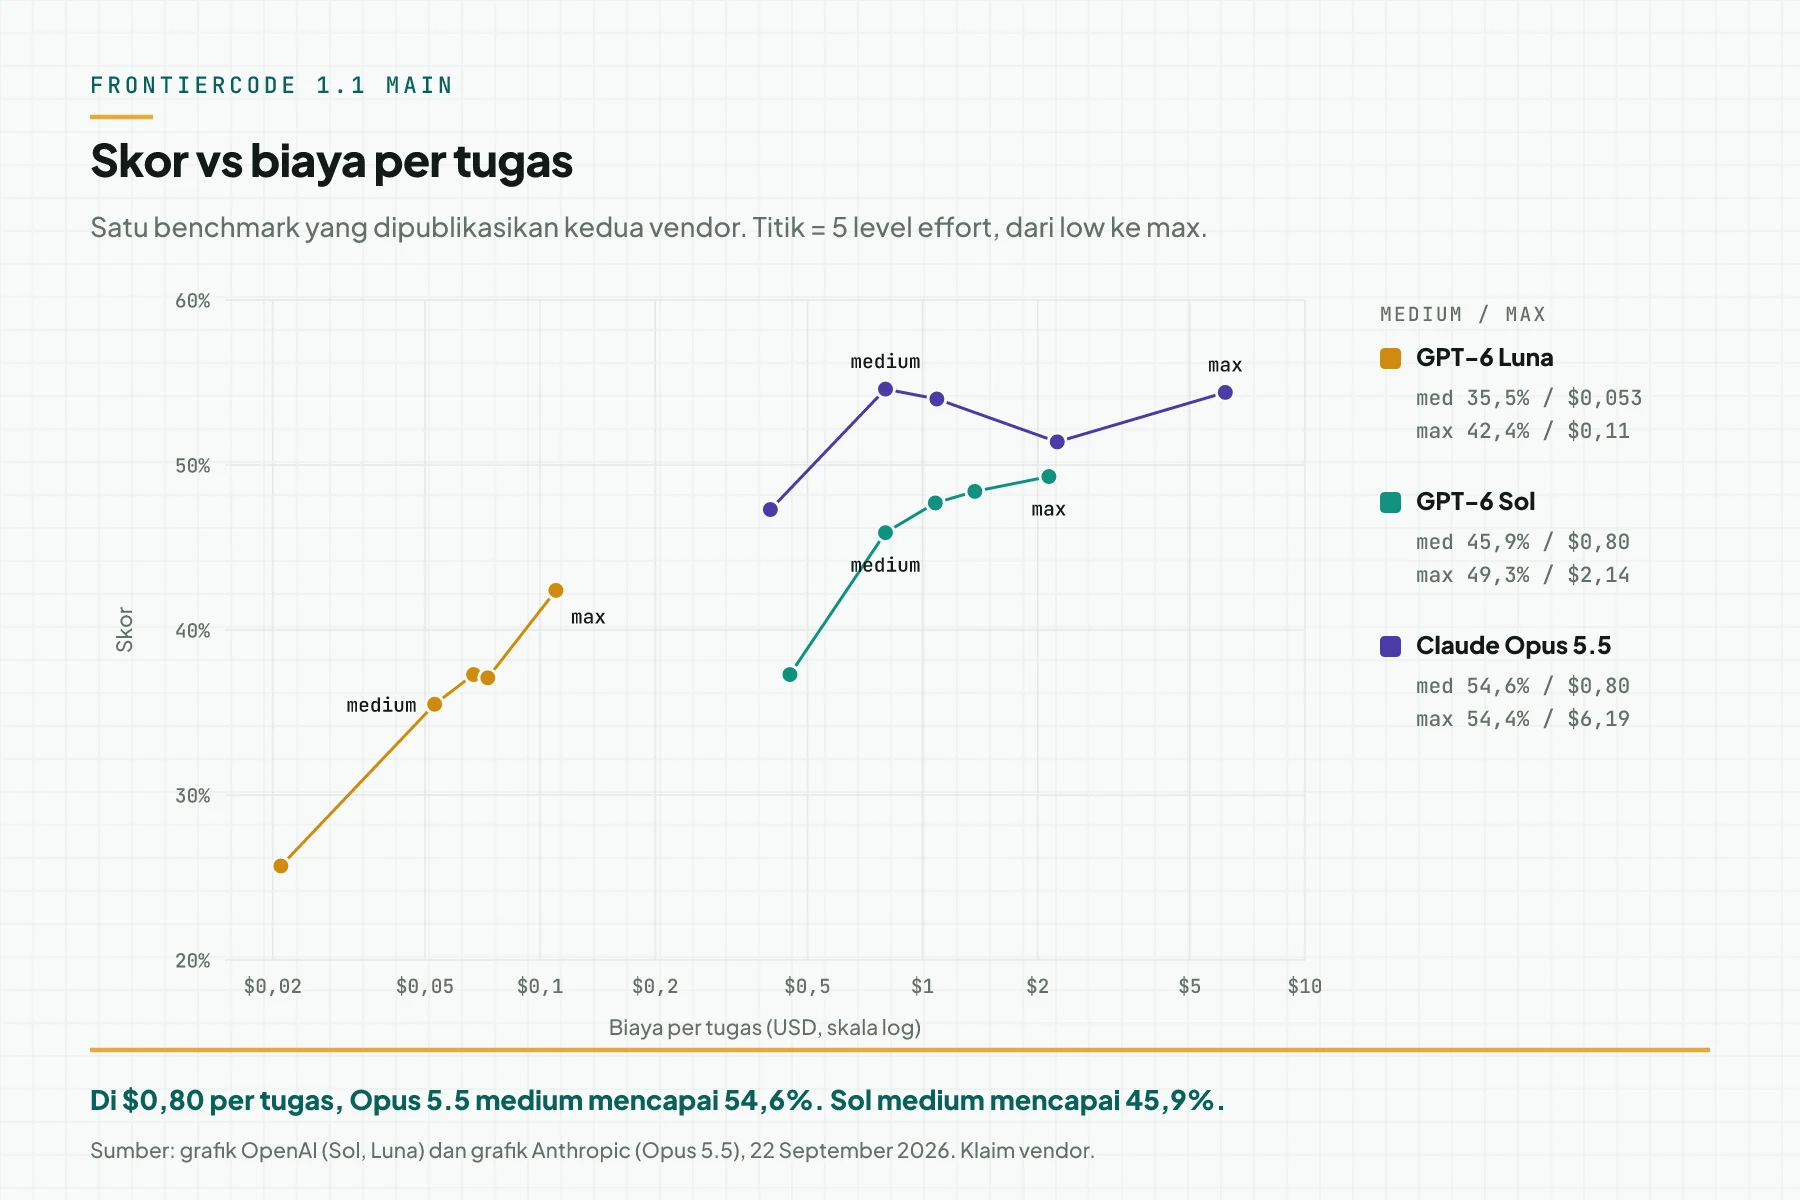
Batasnya: biaya per tugas dihitung oleh tiap vendor. Biaya GPT-6 Astra max pada grafik OpenAI tercatat $4,59, sedangkan grafik Anthropic mencatat $4,36 untuk model yang sama.
AutomationBench: angka mirip, cara hitung beda
AutomationBench menguji alur kerja bisnis lintas aplikasi. OpenAI melaporkan Sol xhigh 33,2% pada versi 1.0.6 dengan biaya $0,27 per tugas. Anthropic melaporkan Opus 5.5 max 40,0% dari uji Zapier, dengan biaya $1,37 per tugas.
Kedua sumber mencatat Opus 5 max di 26,9%. Namun biaya Opus 5 max berbeda jauh: OpenAI menyebut 11,1x biaya Sol, sedangkan grafik Anthropic menyebut $1,27. Jadi skor AutomationBench boleh Anda bandingkan dengan hati-hati, tetapi biaya per tugasnya tidak.
Uji independen Artificial Analysis
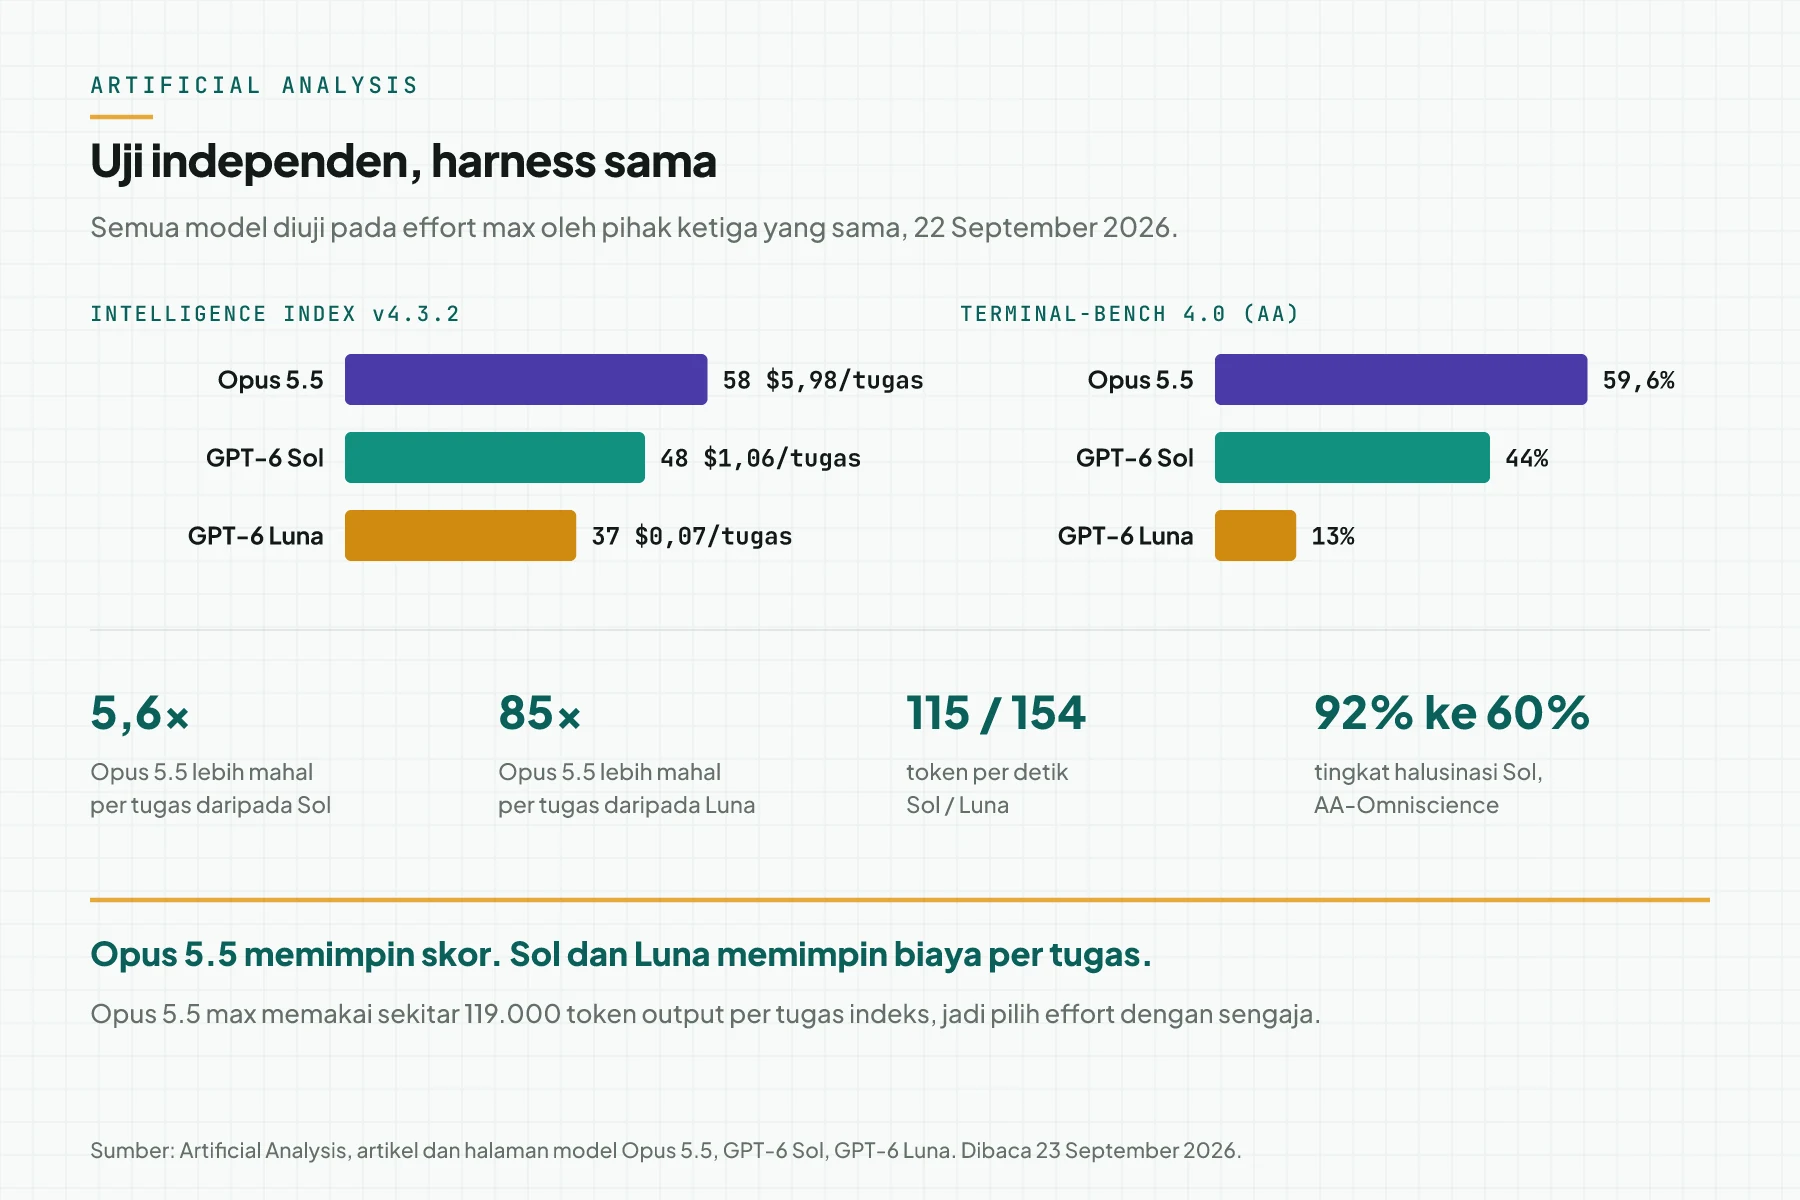
Artificial Analysis menguji ketiga model dengan harness yang sama pada effort max. Hasilnya tercatat pada artikel Opus 5.5 dan artikel GPT-6 Sol dan Luna, keduanya bertanggal 22 September 2026.
| Ukuran | GPT-6 Sol | GPT-6 Luna | Claude Opus 5.5 |
|---|---|---|---|
| Intelligence Index v4.3.2 | 48 | 37 | 58 |
| Biaya per tugas indeks | $1,06 | $0,07 | $5,98 |
| Terminal-Bench 4.0 | 44% | 13% | 59,6% |
| Kecepatan output | 115 token per detik | 154 token per detik | Belum tercatat |
Opus 5.5 memimpin skor. Sol 5,6x lebih murah per tugas daripada Opus 5.5, dan Luna 85x lebih murah. Artificial Analysis juga mencatat bahwa Opus 5.5 max memakai sekitar 119.000 token output per tugas indeks.
Yang perlu Anda siapkan
- 1 akun API OpenAI dan 1 akun API Anthropic, atau 1 gateway yang meneruskan ke keduanya.
- Daftar 20 tugas nyata dari 1 alur kerja, lengkap dengan jawaban yang benar.
- 1 pemeriksa otomatis per tugas: skema JSON, tes unit, atau aturan bisnis.
- Log per permintaan yang menyimpan model, effort, token, waktu, dan hasil pemeriksa.
- Kurs rupiah untuk laporan biaya. Kami memakai JISDOR Bank Indonesia 22 September 2026: Rp17.883 per USD.
Langkah 1: Kelompokkan pekerjaan dengan 3 pertanyaan
Mulai dari pekerjaan, bukan dari model. Jawab 3 pertanyaan berikut dari atas, lalu berhenti pada jawaban "ya" pertama.
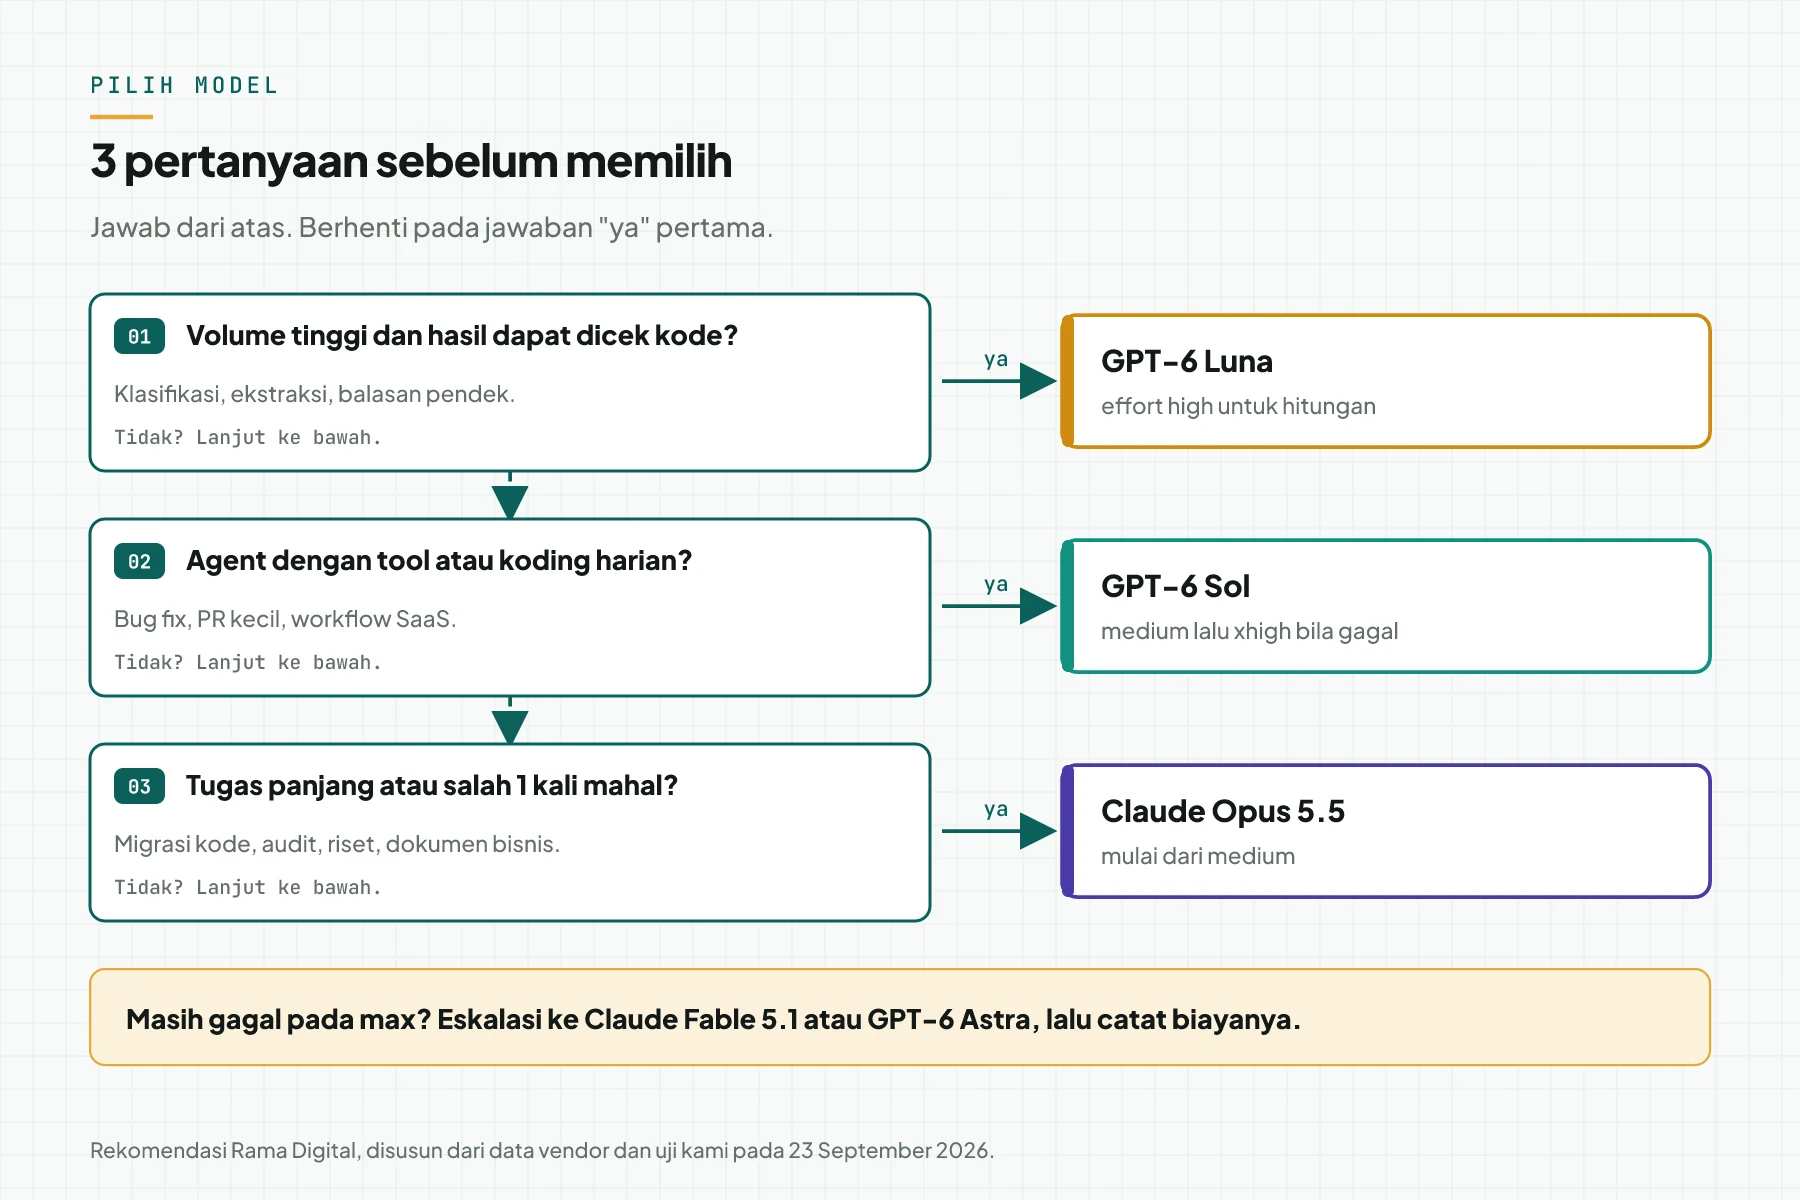
- Volume tinggi dan hasilnya dapat dicek kode? Contoh: klasifikasi pesan, ekstraksi data pesanan, balasan pendek. Pilih Luna.
- Agent dengan tool atau koding harian? Contoh: bug fix, PR kecil, alur SaaS. Pilih Sol.
- Tugas panjang atau salah 1 kali mahal? Contoh: migrasi kode, audit, riset, dokumen bisnis. Pilih Opus 5.5.
Periksa: setiap tugas di daftar 20 tugas Anda mendapat 1 jalur. Sumber pembagian ini adalah fokus yang vendor tulis sendiri: OpenAI menyebut Sol untuk "complex coding and agenticAgenticCara kerja saat tugas rutin dikerjakan agent AI, lalu staf atau owner memeriksa dan menyetujui hasilnya.Buka glosarium workflows" dan Luna untuk "focused, high-volume tasks".
Langkah 2: Uji 3 model dengan prompt yang sama
Kirim prompt yang sama persis ke ketiga model, lalu nilai hasilnya dengan kode, bukan dengan rasa. Kami melakukannya pada 23 September 2026 dengan 3 tugas. Tugasnya adalah ekstraksi pesanan WhatsApp ke JSON, balasan keluhan pelanggan, dan hitung bug PPN.
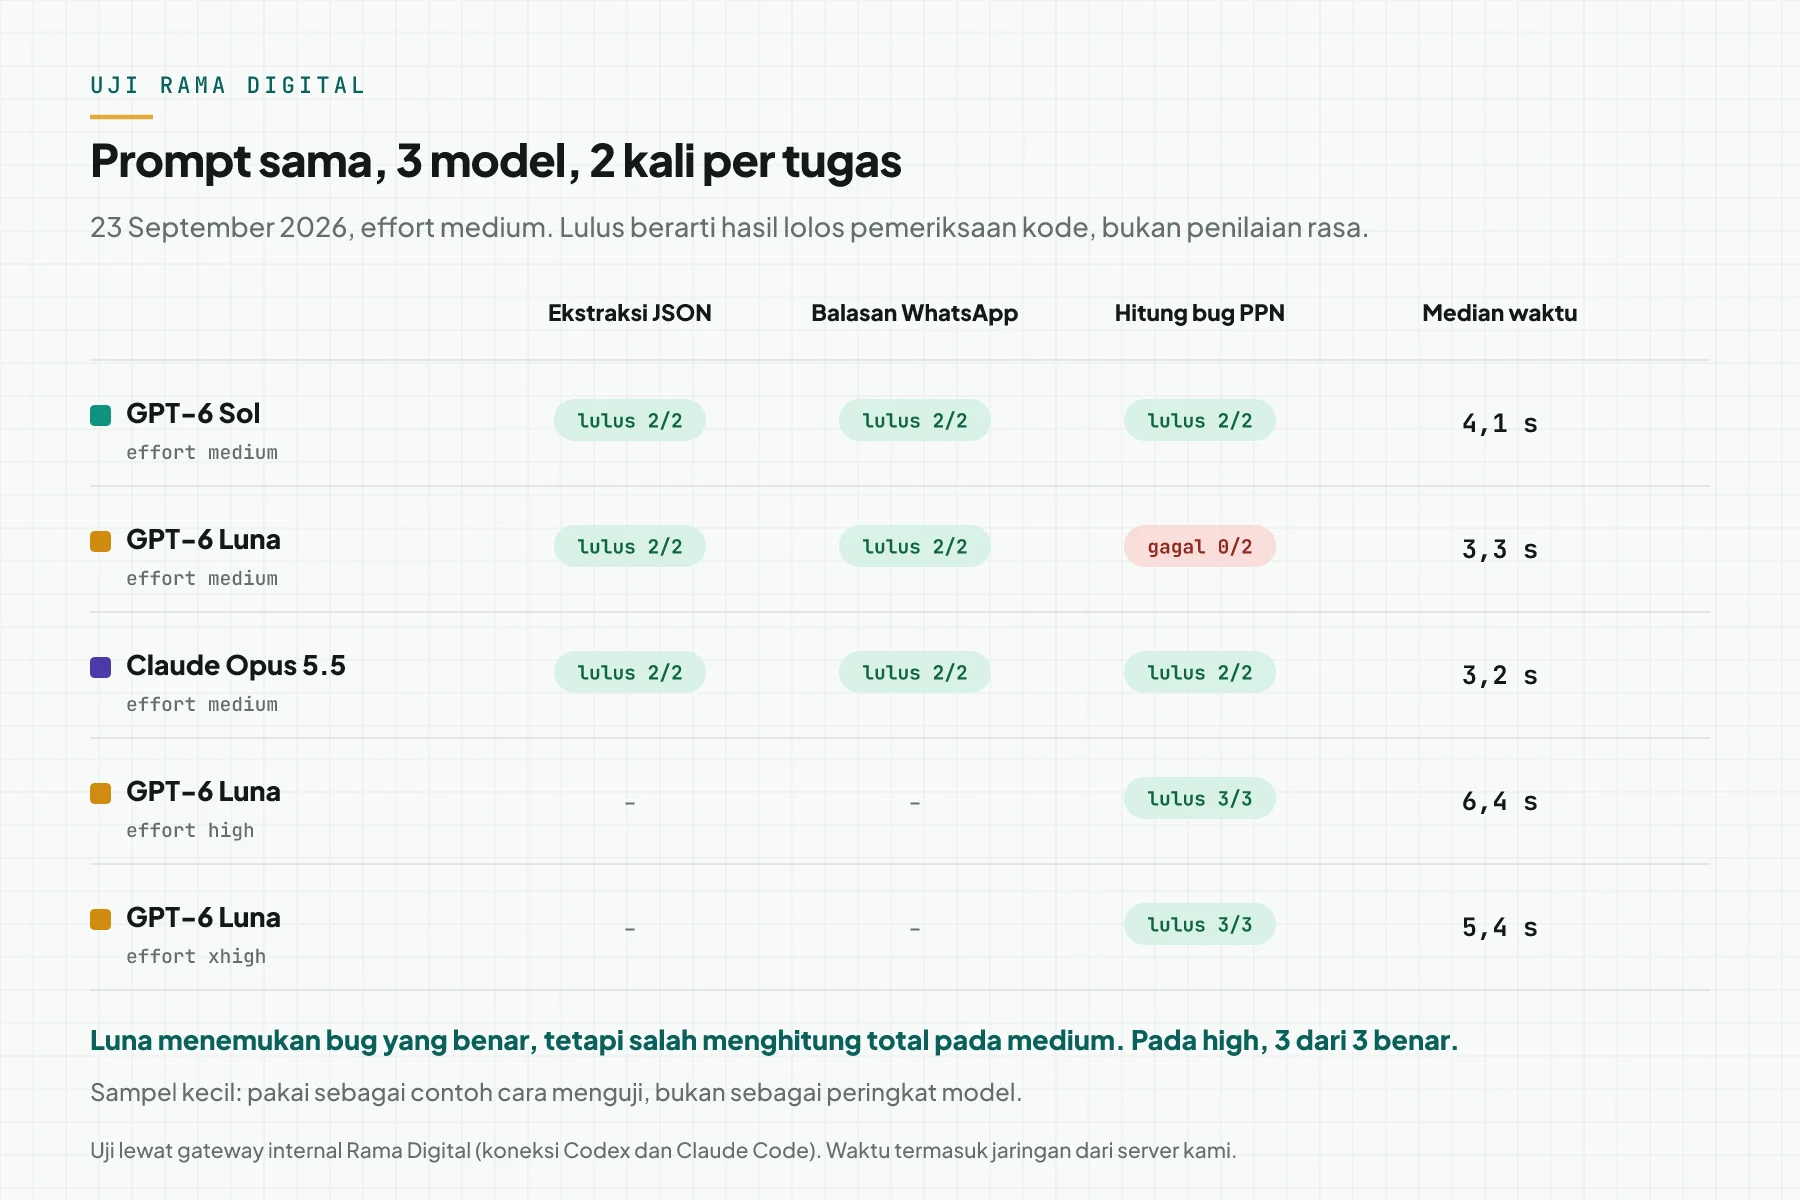
Pada uji kami, Sol dan Opus 5.5 lulus 6 dari 6. Luna lulus 4 dari 6. Luna menulis penyebab bug dengan benar, tetapi totalnya salah: 327.750 dan 379.450, padahal jawabannya 360.750.
Kami mengulang tugas hitung itu untuk Luna pada effort high dan xhigh, masing-masing 3 kali. Semuanya benar. Median waktunya 6,2 detik, naik dari 2,1 detik pada medium.
Satu catatan kualitas. Pada 1 dari 2 balasan pelanggan, Opus 5.5 menambahkan janji "sebelum pukul 17.00" yang tidak ada di instruksi. Periksa janji waktu dan janji tindakan pada setiap balasan otomatis.
Batas uji ini: kami memakai gateway internal yang tersambung lewat koneksi Codex dan Claude Code, bukan API berbayar. Waktu termasuk jaringan dari server kami, dan jumlah token termasuk instruksi harness, jadi kami tidak menghitung biaya API dari uji ini.
Langkah 3: Cocokkan hasil Anda dengan uji independen
Bandingkan hasil 20 tugas Anda dengan angka Artificial Analysis. Bila hasil Anda jauh berbeda dari arah uji independen, periksa prompt dan pemeriksa Anda lebih dahulu.
Tiga temuan independen yang mengubah keputusan:
- Tingkat halusinasi Sol turun dari 92% ke 60% di AA-Omniscience. Sol lebih sering menolak menjawab, jadi akurasinya turun dari 59% ke 54%.
- Sol dan Luna melemah di GDPval-AA v2.1, sekitar 100 dan 75 Elo. Artificial Analysis mengaitkannya dengan deliverable yang lebih pendek.
- Opus 5.5 memimpin AA-Briefcase dengan 1.822 Elo, 143 di atas Fable 5.1.
Rekomendasi Rama Digital: untuk laporan dan presentasi klien, uji Opus 5.5 lebih dahulu. Untuk koding dengan anggaran ketat, uji Sol lebih dahulu. Detail migrasi tiap model ada di panduan GPT-6 Sol dan Luna dan panduan Claude Opus 5.5.
Langkah 4: Pasang routing dengan pemeriksa
Pasang 1 pintu masuk yang memilih jalur, lalu 1 pemeriksa yang menilai hasil. Tugas yang gagal pemeriksa naik 1 jalur, dari Luna ke Sol, lalu ke Opus 5.5.
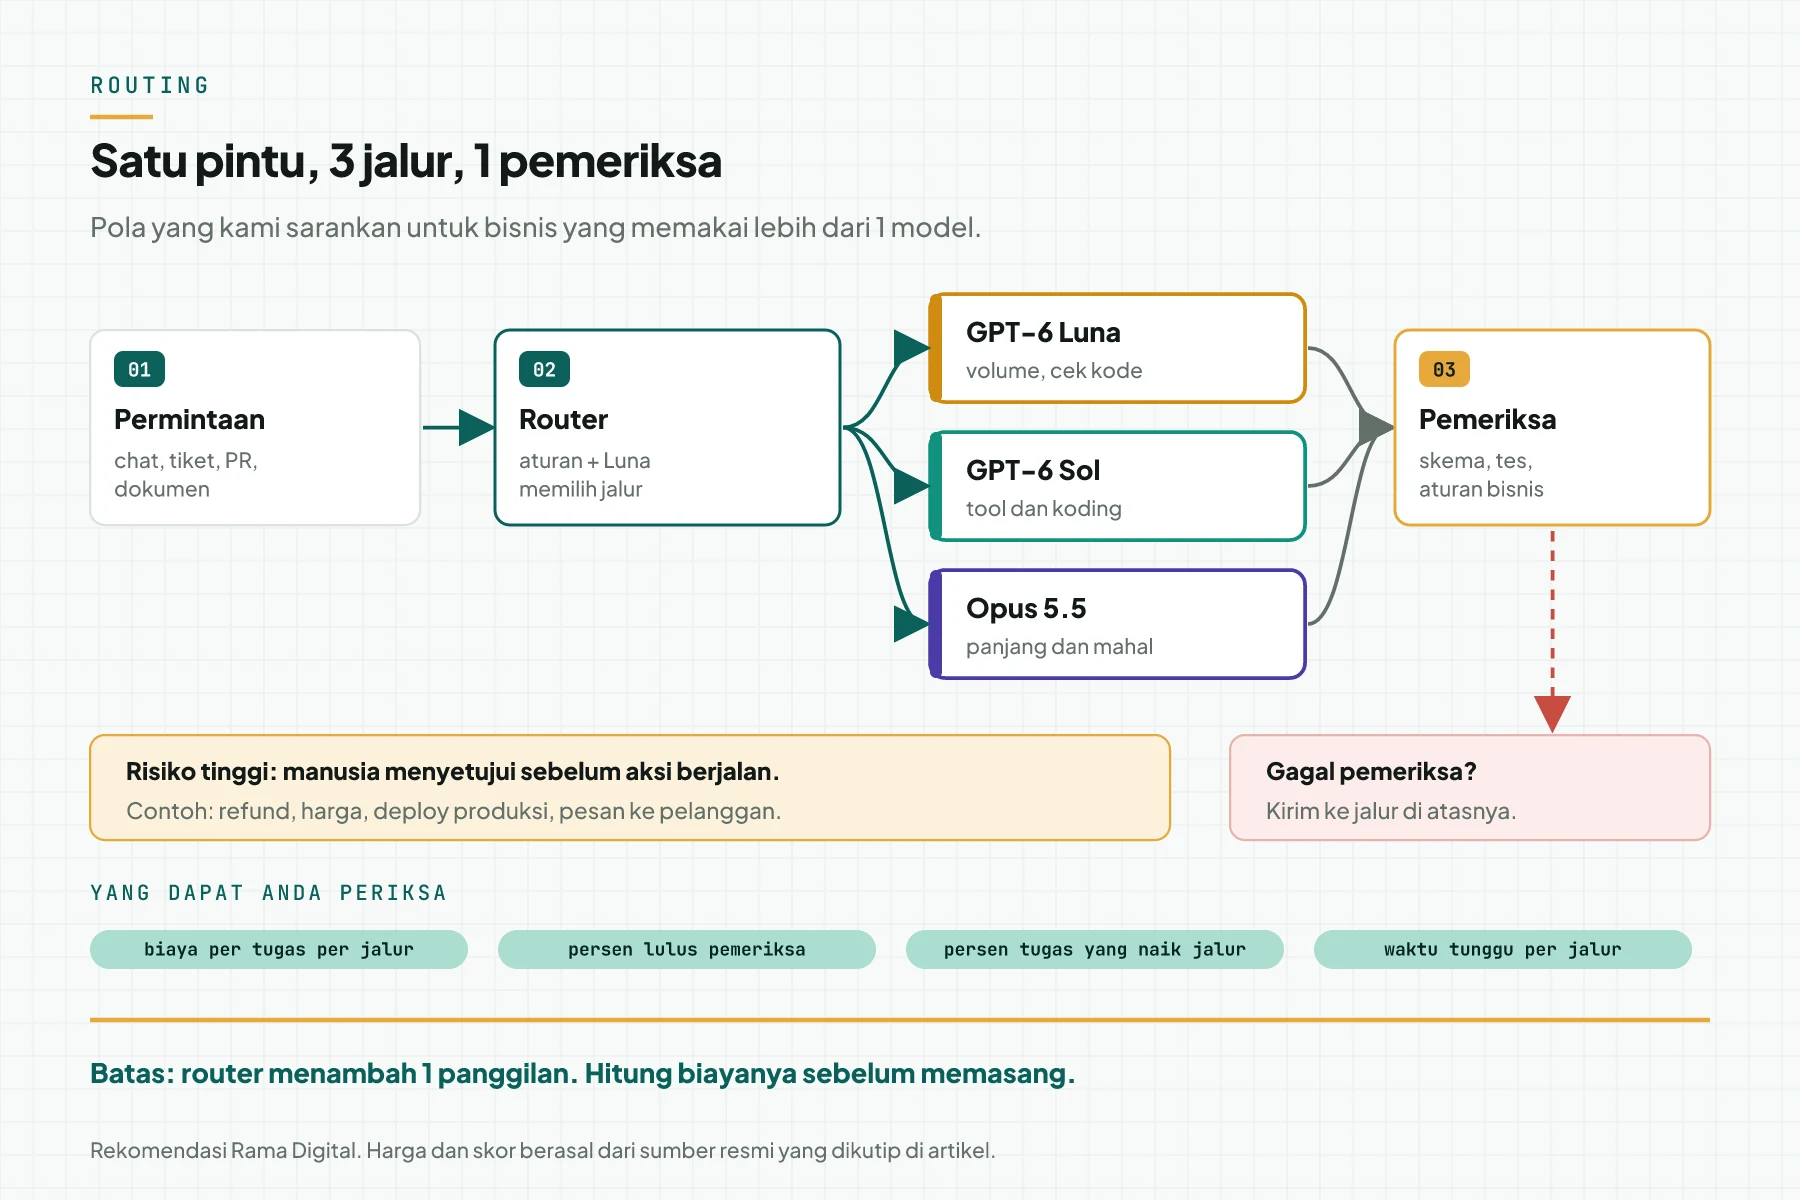
Atur effort per jalur, bukan per model. Mulai Luna di high untuk tugas yang memuat hitungan, Sol di medium, dan Opus 5.5 di medium. Naikkan effort hanya untuk tugas yang gagal.
Periksa: setelah 1 minggu, Anda dapat menjawab 3 pertanyaan dari log. Berapa biaya per tugas per jalur? Berapa persen tugas lulus pemeriksa? Berapa persen tugas naik jalur? Cara menghitung biaya ada di panduan hitung biaya API per tugas.
Contoh kerja: 1 hari di toko online dummy
Simulasi dengan data dummy. Toko online "Kopi Sleman" memakai 3 jalur pada 23 September 2026. Biaya koding dan laporan memakai biaya per tugas dari grafik vendor, bukan tagihan nyata.
| Waktu | Pekerjaan | Jalur dan effort | Hasil pemeriksa | Biaya |
|---|---|---|---|---|
| 09.00 | 1.200 pesan WhatsApp semalam diklasifikasi | Luna, high | 1.184 lolos skema, 16 gagal | $0,14 |
| 09.20 | 16 pesan gagal diklasifikasi ulang | Sol, medium | 16 lolos skema | $0,08 |
| 10.30 | Bug ongkir di checkout | Sol, medium lalu xhigh | Tes gagal 1 kali, lalu lulus | $2,17 |
| 13.00 | Laporan penjualan bulanan dan rekomendasi | Opus 5.5, medium | Manusia mengoreksi 1 angka | $0,86 |
| 16.00 | Rekap harian | - | 4 pekerjaan selesai | $3,25 atau Rp58.081 |
Pelajaran dari simulasi ini: jalur murah menangani volume, dan biaya terbesar datang dari 2 tugas saja. Bila bug fix langsung dikirim ke Opus 5.5 max, biaya tugas itu menjadi $6,19 menurut grafik FrontierCode Anthropic.
Checklist sebelum memindahkan trafik
- Tulis 20 tugas nyata beserta jawaban benar. Pemilik: kepala tim. Bukti: file daftar tugas.
- Buat 1 pemeriksa otomatis per jenis tugas. Pemilik: developer. Bukti: skrip pemeriksa di repo.
- Jalankan ketiga model pada effort default. Pemilik: developer. Bukti: log per permintaan.
- Ulang tugas yang gagal pada 1 effort lebih tinggi. Pemilik: developer. Bukti: tabel lulus per effort.
- Hitung biaya per tugas berhasil dalam rupiah. Pemilik: finance. Bukti: lembar hitung dengan kurs dan tanggal.
- Tandai tugas berisiko tinggi untuk persetujuan manusia. Pemilik: pemilik proses. Bukti: daftar aturan persetujuan.
- Pindahkan 10% trafik selama 7 hari. Pemilik: kepala tim. Bukti: laporan harian biaya dan lulus.
- Berhenti dan kembali ke model lama bila tingkat lulus turun lebih dari 5 poin atau biaya naik lebih dari 20%.
Rekomendasi per jenis pekerjaan
Rekomendasi Rama Digital berikut berlaku untuk tim yang sudah memakai API. Bila Anda hanya memakai aplikasi chat, pilih paket yang memuat model itu, lalu uji dengan tugas yang sama.
| Pekerjaan | Model pertama | Effort awal | Eskalasi | Dasar |
|---|---|---|---|---|
| Klasifikasi dan ekstraksi pesan | GPT-6 Luna | high bila ada hitungan | GPT-6 Sol | Uji kami dan DeepSWE per effort |
| Bug fix dan PR kecil | GPT-6 Sol | medium | Claude Opus 5.5 | FrontierCode dan Coding Agent Index |
| Migrasi dan audit codebase | Claude Opus 5.5 | medium | Claude Fable 5.1 | Terminal-Bench 4.0 dan klaim Anthropic |
| Laporan, analisis, presentasi | Claude Opus 5.5 | medium | GPT-6 Astra atau Fable 5.1 | GDPval-AA dan AA-Briefcase |
| Dokumen di atas 272.000 token | Claude Opus 5.5 atau Sol | medium | - | Premi konteks panjang GPT-6 |
Pilih Sol bila anggaran per tugas ketat dan pemeriksa otomatis Anda kuat. Pilih Opus 5.5 bila 1 kesalahan lebih mahal daripada selisih biaya per tugas.
Pertanyaan yang sering muncul
Mana yang lebih pintar, GPT-6 Sol atau Claude Opus 5.5? Pada uji independen Artificial Analysis, Opus 5.5 mencetak 58 dan Sol 48 pada Intelligence Index. Sol 5,6x lebih murah per tugas, jadi pilihan bergantung pada nilai 1 tugas Anda.
Apakah GPT-6 Luna layak untuk chatbot customer service? Luna lulus ekstraksi dan balasan pada uji kami. Luna salah menghitung pada effort medium, jadi pakai effort high untuk tugas yang memuat angka.
Apakah harga GPT-6 Sol dan Luna bersifat promo? Tidak. Juru bicara OpenAI mengonfirmasi kepada VentureBeat bahwa harga ini permanen. Pengumuman OpenAI menyebut penurunan 50% dibanding harga promo GPT-5.6.
Kenapa tagihan Opus 5.5 bisa lebih rendah padahal harga tokennya 2x Sol? Biaya ditentukan oleh token per tugas dan tingkat berhasil. Pada FrontierCode medium, keduanya tercatat $0,80 per tugas, tetapi skor Opus 5.5 lebih tinggi.
Apakah ketiga model sudah ada di ChatGPT dan Claude? Sol dan Luna ada di ChatGPT Work dan Codex untuk paket berbayar. Opus 5.5 ada di aplikasi Claude dan Claude Code.
Langkah berikutnya
Batas yang tetap berlaku: angka vendor dan uji independen hanya titik awal, karena alur kerja Anda punya prompt, data, dan risiko sendiri. Uji 20 tugas nyata sebelum Anda memindahkan trafik atau menandatangani anggaran.
Bila Anda ingin kami memetakan jalur model untuk bisnis Anda, buka Jasa Konsultan AI untuk Bisnis. Untuk membahasnya dulu, pilih jadwal Konsultasi Awal 30 menit.
Sumber
- OpenAI: Introducing GPT-6 Sol and Luna, 22 September 2026
- OpenAI: halaman model GPT-6 Sol
- OpenAI: halaman model GPT-6 Luna
- Anthropic: Introducing Claude Opus 5.5, 22 September 2026
- Anthropic: ringkasan model Claude
- Anthropic: harga Claude
- Artificial Analysis: Claude Opus 5.5
- Artificial Analysis: GPT-6 Sol and Luna
- GitHub Changelog: GPT-6 Sol dan Luna di Copilot
- Decrypt: waktu rilis OpenAI dan Anthropic
- Bank Indonesia: kurs JISDOR