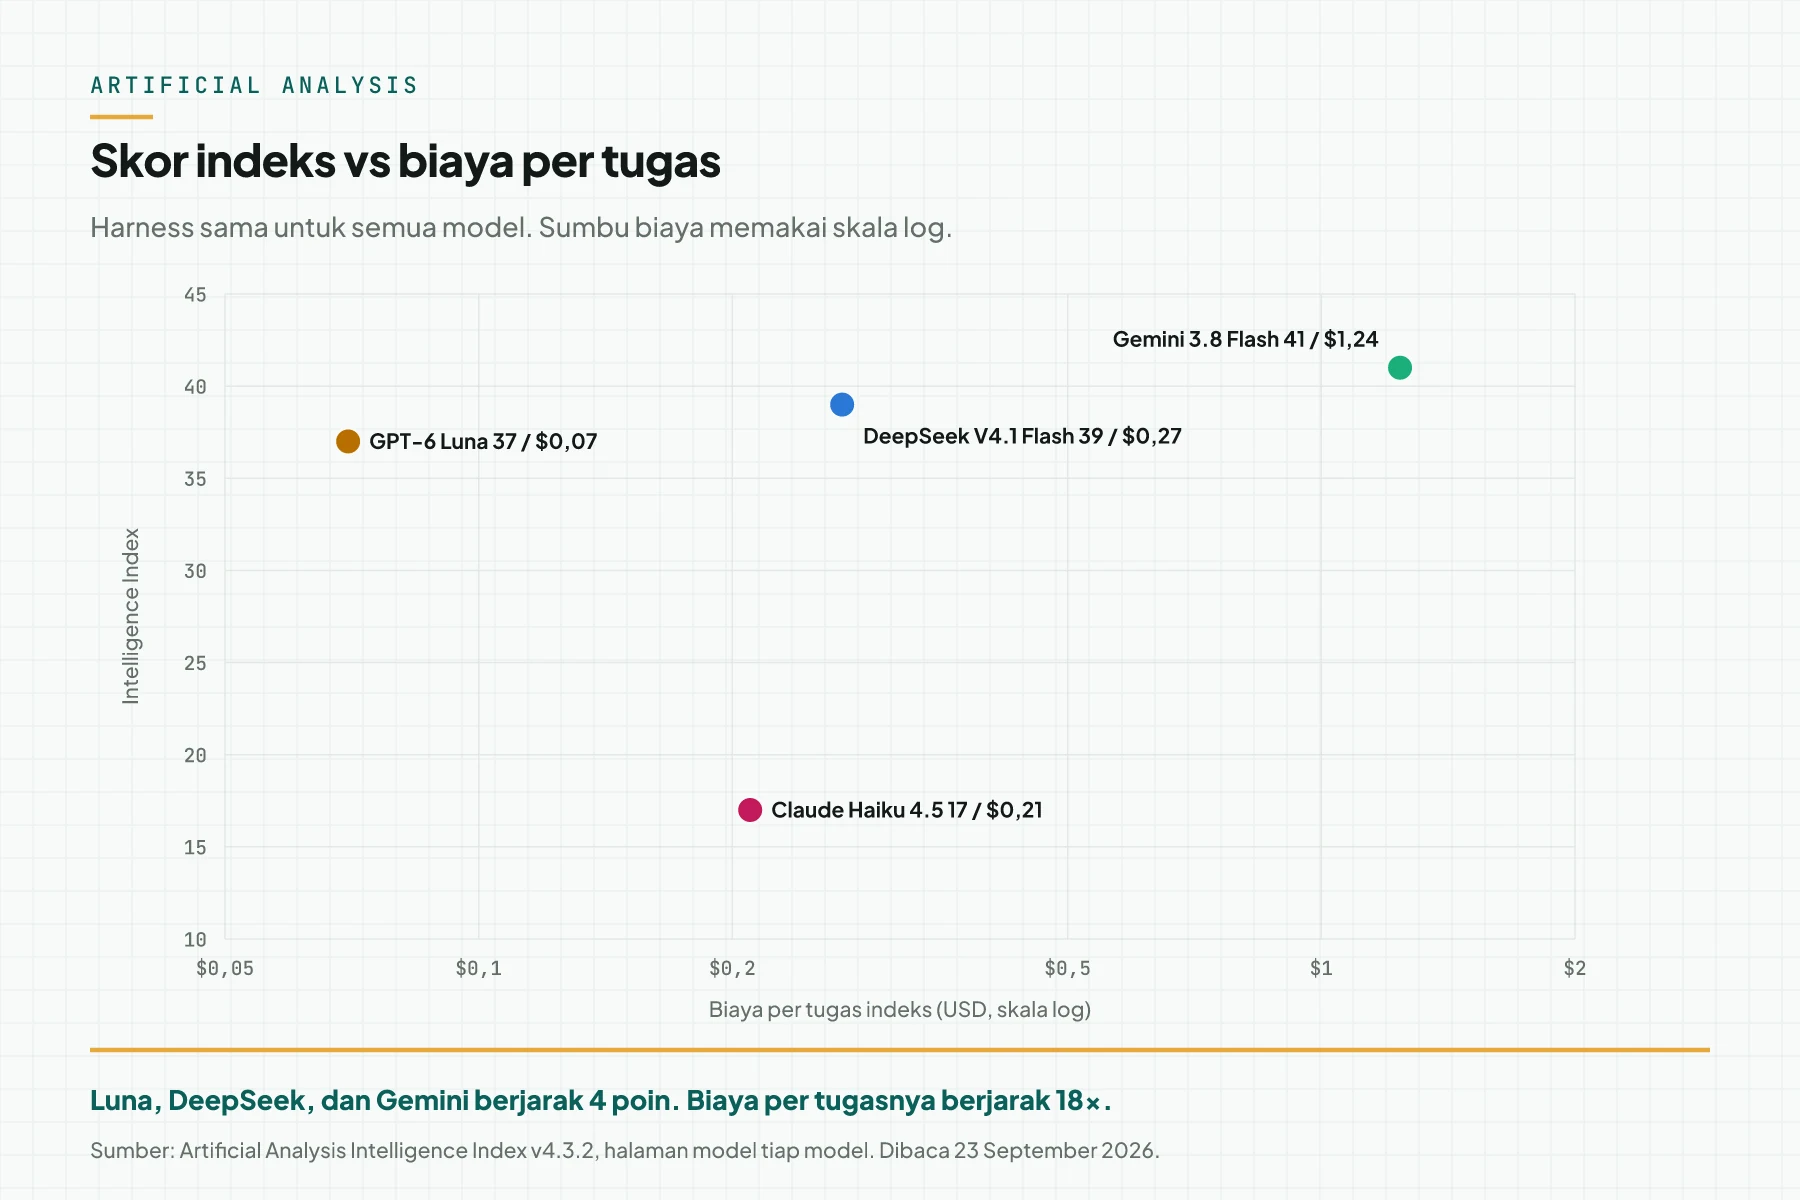
Jawaban langsung: pakai GPT-6 Luna untuk tugas bervolume tinggi yang dapat dicek kode, dan DeepSeek V4.1 Flash untuk agentAgent AIProgram AI yang mengerjakan langkah pekerjaan sendiri, misalnya membaca pesan, menyiapkan balasan, lalu mencatat hasilnya.Buka glosarium dengan tool. Pakai Gemini 3.8 Flash untuk gambar, audio, dan video, dan ClaudeClaude ProLangganan berbayar asisten AI Claude dari Anthropic. Langganan ini membuka connector ke alat luar.Buka glosarium Haiku 4.5 untuk jawaban pendek yang harus hati-hati. Luna, DeepSeek, dan Gemini hanya berjarak 4 poin pada skor indeks, tetapi biaya per tugasnya berjarak 18x.
Kondisi utama: pembagian ini berlaku bila Anda menghitung biaya per tugas yang berhasil dan menyalakan reasoning untuk hitungan. Pada uji kami, Luna, DeepSeek, dan Haiku gagal hitung invoice 0 dari 5 kali pada setelan bawaan, lalu lulus 3 dari 3 pada effort high. Batas: harga Gemini 3.8 Flash naik 2x pada 1 Januari 2027, dan kebijakan privasi DeepSeek menyebut penyimpanan data pribadi di Tiongkok.
Pada 23 September 2026 kami membaca halaman harga resmi OpenAI, DeepSeek, Google, dan Anthropic. Kami juga membaca 4 halaman model dan 9 halaman evaluasi Artificial Analysis. Pada hari yang sama kami menguji keempat model dengan prompt sama dan data dummy: 40 panggilan untuk 5 tugas, lalu 21 panggilan lanjutan.
Harga terlihat mirip, biaya nyata tidak
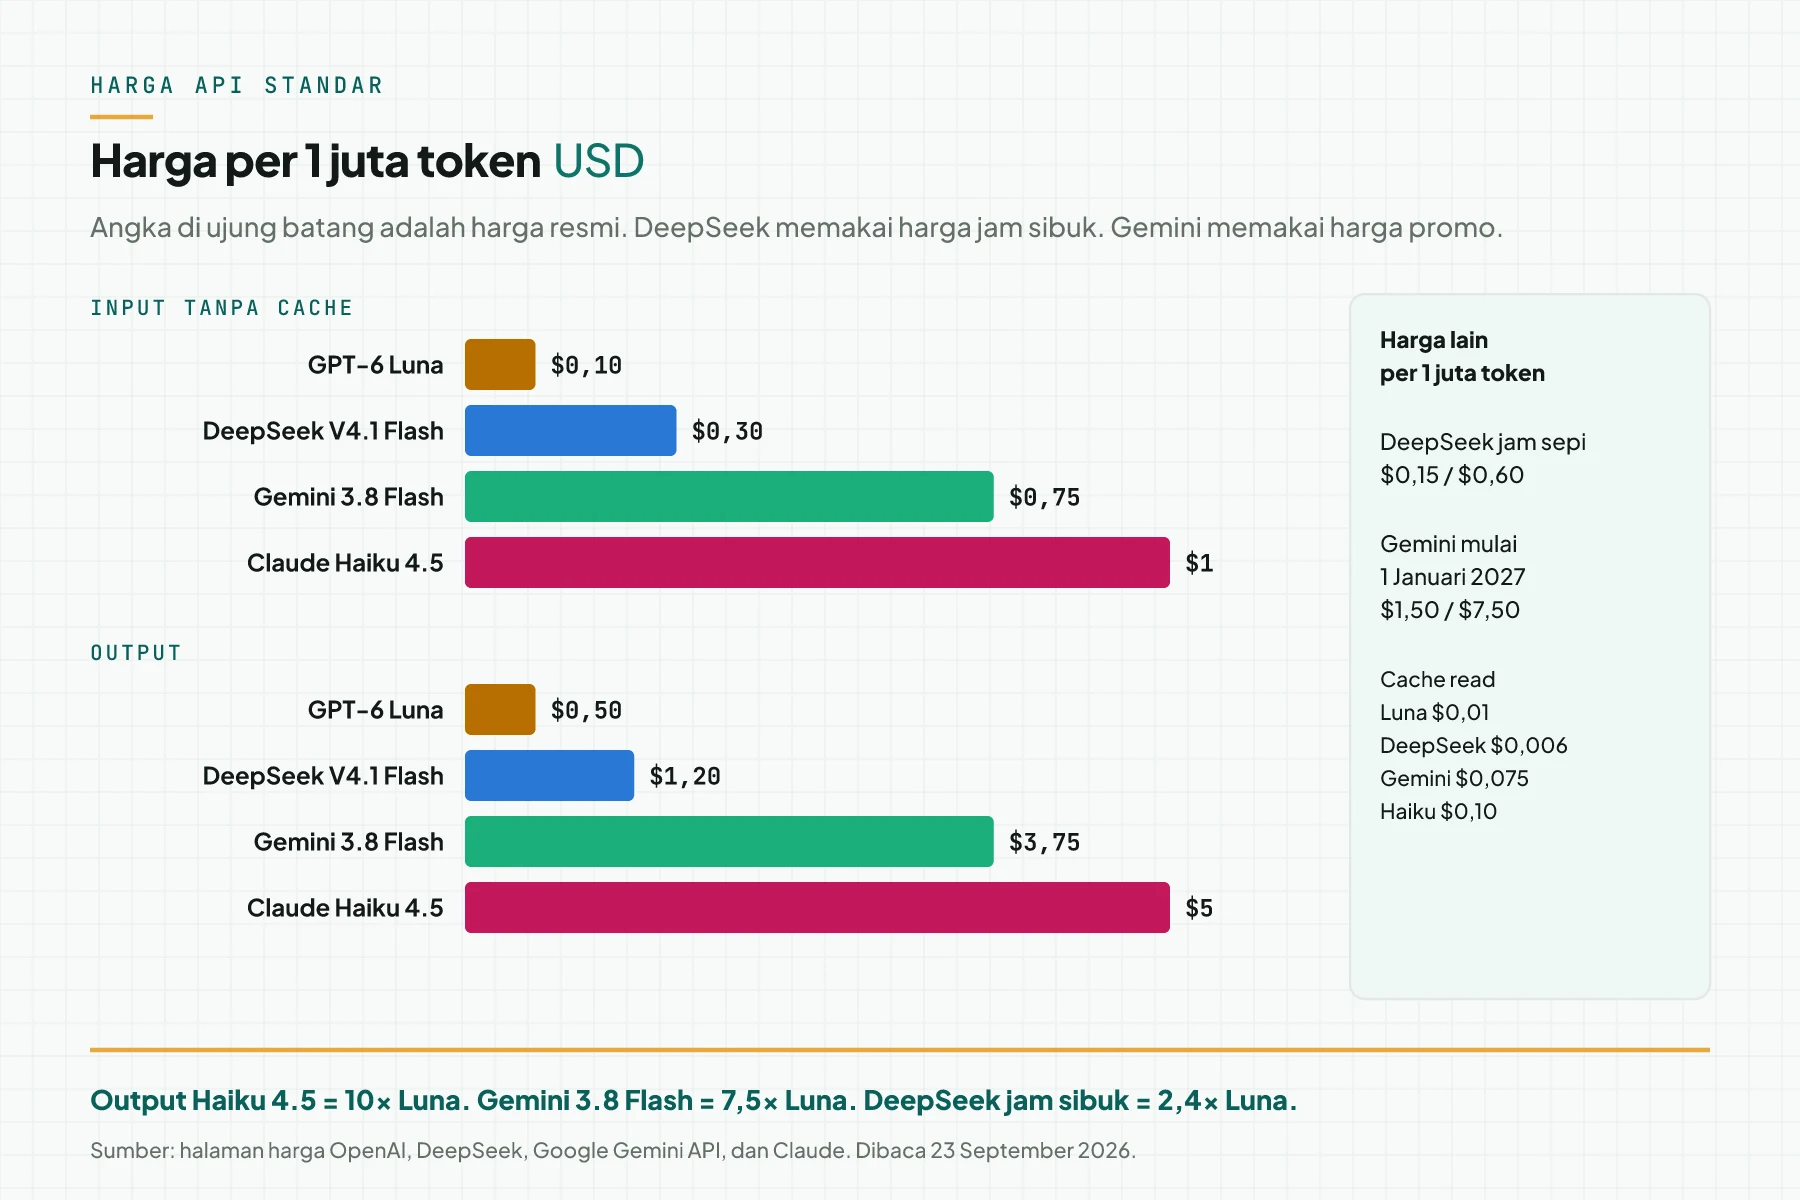
Keempat model ini sering masuk daftar "model murah". Harga output per 1 juta token berada antara $0,50 dan $5. Selisih 10x itu terlihat kecil sampai Anda mengalikannya dengan jutaan pesan per bulan.
Dari keluarga Claude, kami memilih Haiku 4.5 karena harganya paling dekat dengan 3 model lain. Claude Sonnet 5 berharga $2 input dan $10 output, jadi Sonnet 5 masuk kelas harga di atasnya.
Masalah kedua lebih halus. Model yang menulis banyak token reasoning dapat lebih mahal per tugas daripada model dengan harga token lebih tinggi. Karena itu kami membandingkan 3 hal: harga per token, biaya per tugas dari uji independen, dan hasil uji kami sendiri.
Untuk kelas di atasnya, baca perbandingan GPT-6 Sol, GPT-6 Luna, dan Claude Opus 5.5. Artikel ini membahas kelas volume: model yang Anda pakai untuk ribuan tugas per hari.
Cara tiap vendor menagih
Keempat vendor menagih per token, tetapi aturan tambahannya berbeda. Aturan tambahan inilah yang membuat 2 model dengan harga sama menghasilkan tagihan berbeda.
GPT-6 Luna
Halaman model GPT-6 Luna mencantumkan $0,10 input, $0,01 cached input, $0,125 cache write, dan $0,50 output per 1 juta token. Prompt di atas 272.000 token input berharga 2x untuk input dan 1,5x untuk output pada seluruh permintaan. Batch dan Flex berharga 50% dari harga standar.
Luna memiliki 6 level effort: none, low, medium, high, xhigh, dan max. Default-nya medium. Konteksnya 1.050.000 token, output maksimal 128.000 token, dan knowledge cutoff 18 Mei 2026.
DeepSeek V4.1 Flash
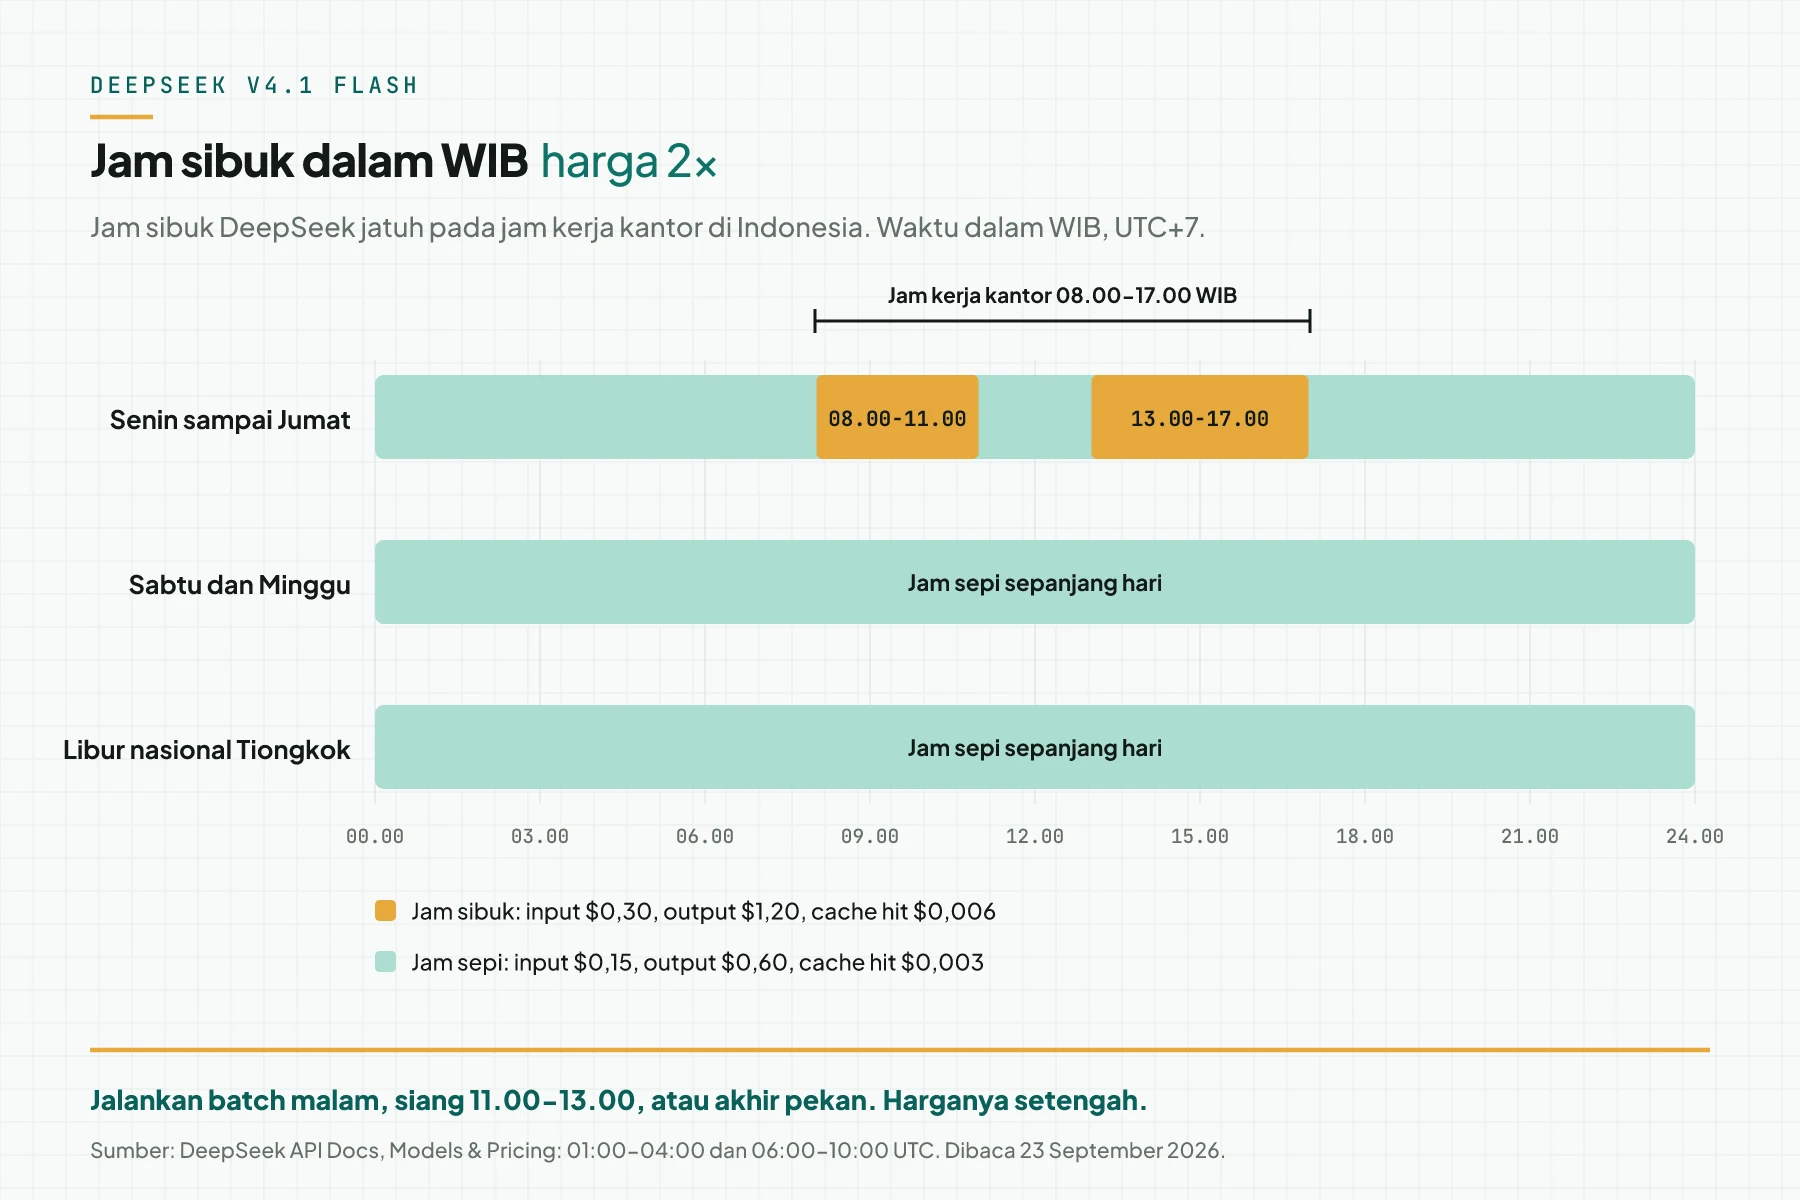
Halaman harga DeepSeek memakai nama model deepseek-flash untuk versi DeepSeek-V4.1-Flash. Harga jam sibuk adalah $0,30 input dan $1,20 output. Harga jam sepi adalah setengahnya: $0,15 dan $0,60.
Jam sibuk berlaku pukul 01:00 sampai 04:00 dan 06:00 sampai 10:00 UTC, Senin sampai Jumat. Dalam WIB, itu pukul 08.00 sampai 11.00 dan 13.00 sampai 17.00. Jadi jam sibuk DeepSeek jatuh tepat pada jam kerja kantor di Indonesia.
Nama lama deepseek-v4-flash masih diterima, tetapi modelnya sudah pensiun. DeepSeek melayani permintaan itu dengan V4.1 Flash dan menagih harga Flash. API DeepSeek menerima format OpenAI dan Anthropic, jadi Anda hanya mengganti base URL dan nama model.
Gemini 3.8 Flash
Halaman harga Gemini API mencantumkan $0,75 input dan $3,75 output sampai 31 Desember 2026. Mulai 1 Januari 2027, harganya menjadi $1,50 dan $7,50. Batch dan Flex berharga 50%, sedangkan Priority berharga 1,8x.
Halaman model Gemini 3.8 Flash mencantumkan input teks, gambar, video, audio, dan PDF, dengan batas 1.048.576 token input dan 65.536 token output. Thinking mendukung low, medium, dan high. Level minimal ditolak dengan error.
Gemini punya tier gratis untuk 3.8 Flash. Namun Google menulis bahwa konten pada tier gratis dipakai untuk memperbaiki produknya. Grounding Google Search memberi 5.000 permintaan gratis per bulan, lalu $14 per 1.000 permintaan.
Claude Haiku 4.5
Halaman harga Claude mencantumkan Haiku 4.5 pada $1 input dan $5 output per 1 juta token. Cache read berharga $0,10, atau 0,1x harga input, dan cache write 5 menit berharga 1,25x. Batch APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium memberi diskon 50%, jadi harga batch menjadi $0,50 dan $2,50.
Ringkasan model Claude mencatat konteks 200.000 token, output maksimal 64.000 token, dan reliable knowledge cutoff Februari 2025. Haiku 4.5 memakai extended thinking, bukan level effort. Web search Claude berharga $10 per 1.000 pencarian.
Spesifikasi dan harga berdampingan
Tabel ini memakai angka dari halaman resmi, dibaca 23 September 2026. Harga tertulis dalam USD per 1 juta token pada pemrosesan standar.
| Item | GPT-6 Luna | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Claude Haiku 4.5 |
|---|---|---|---|---|
| ID API | gpt-6-luna | deepseek-flash | gemini-3.8-flash | claude-haiku-4-5-20251001 |
| Input / output | $0,10 / $0,50 | $0,30 / $1,20 (jam sepi $0,15 / $0,60) | $0,75 / $3,75 (2027: $1,50 / $7,50) | $1 / $5 |
| Cache read | $0,01 | $0,006 (jam sepi $0,003) | $0,075 | $0,10 |
| Konteks / output maksimal | 1.050.000 / 128.000 | 1 juta / 384.000 | 1.048.576 / 65.536 | 200.000 / 64.000 |
| Input selain teks | Gambar | Gambar | Gambar, video, audio, PDF | Gambar |
| Reasoning | 6 level, default medium | Thinking dan non-thinking, default thinking | low, medium, high | Extended thinking |
| Diskon massal | Batch dan Flex 50% | Jam sepi 50% | Batch dan Flex 50% | Batch 50% |
| Bobot model | Tertutup | Terbuka, lisensi MIT | Tertutup | Tertutup |
Baris bobot model berasal dari halaman DeepSeek V4.1 Flash di Artificial Analysis: 552 miliar parameter total dan 16 miliar parameter aktif. Artinya Anda dapat menjalankan DeepSeek di server sendiri, tetapi ukuran itu butuh beberapa GPU besar.
Kemampuan: uji independen dengan harness yang sama
Angka benchmark vendor sulit dibandingkan karena metodenya berbeda. Jadi kami memakai Artificial Analysis, yang menguji semua model dengan harness yang sama. Varian yang diuji adalah Luna max, DeepSeek max, Gemini high, dan Haiku 4.5 reasoning.
Skor indeks dan biaya per tugas
Pada Intelligence Index v4.3.2, Gemini 3.8 Flash mencetak 41, DeepSeek 39, Luna 37, dan Haiku 4.5 17. Haiku 4.5 rilis pada Oktober 2025, jadi Haiku adalah model paling tua di tabel ini.
Biaya per tugas indeks jauh lebih lebar: Luna $0,07, Haiku $0,21, DeepSeek $0,27, dan Gemini $1,24. Haiku memakai token output paling sedikit, 78 juta untuk seluruh indeks, tetapi harga tokennya 10x Luna.
Profil per bidang
Skor indeks menyembunyikan perbedaan per bidang. Tabel berikut memuat 8 evaluasi yang paling dekat dengan pekerjaan bisnis. Angka dibaca dari halaman evaluasi Artificial Analysis pada 23 September 2026.
| Evaluasi | Luna | DeepSeek | Gemini | Haiku 4.5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 (koding agent) | 12,6% | 26,8% | 19,7% | 0,0% |
| GDPval-AA v2.1 (kerja nyata, Elo) | 1.367 | 1.600 | 1.412 | 719 |
| AutomationBench-AA (alur SaaS) | 53,2% | 68,9% | 59,9% | 3,2% |
| AA-LCR v1.1 (konteks panjang) | 83,3% | 84,0% | 81,3% | 74,3% |
| SciCode (kode ilmiah) | 54,6% | 51,9% | 56,6% | 42,2% |
| MMMU-Pro (gambar) | 76% | 77% | 86% | 59% |
| AA-Omniscience akurasi | 44% | 46% | 55% | 18% |
| Halusinasi saat tidak tahu (rendah = baik) | 77% | 96% | 55% | 27% |
| Kecepatan output (token per detik) | 157 | 227 | 276 | 109 |
| Waktu per tugas indeks (menit) | 5,3 | 4,9 | 4,1 | 2,2 |
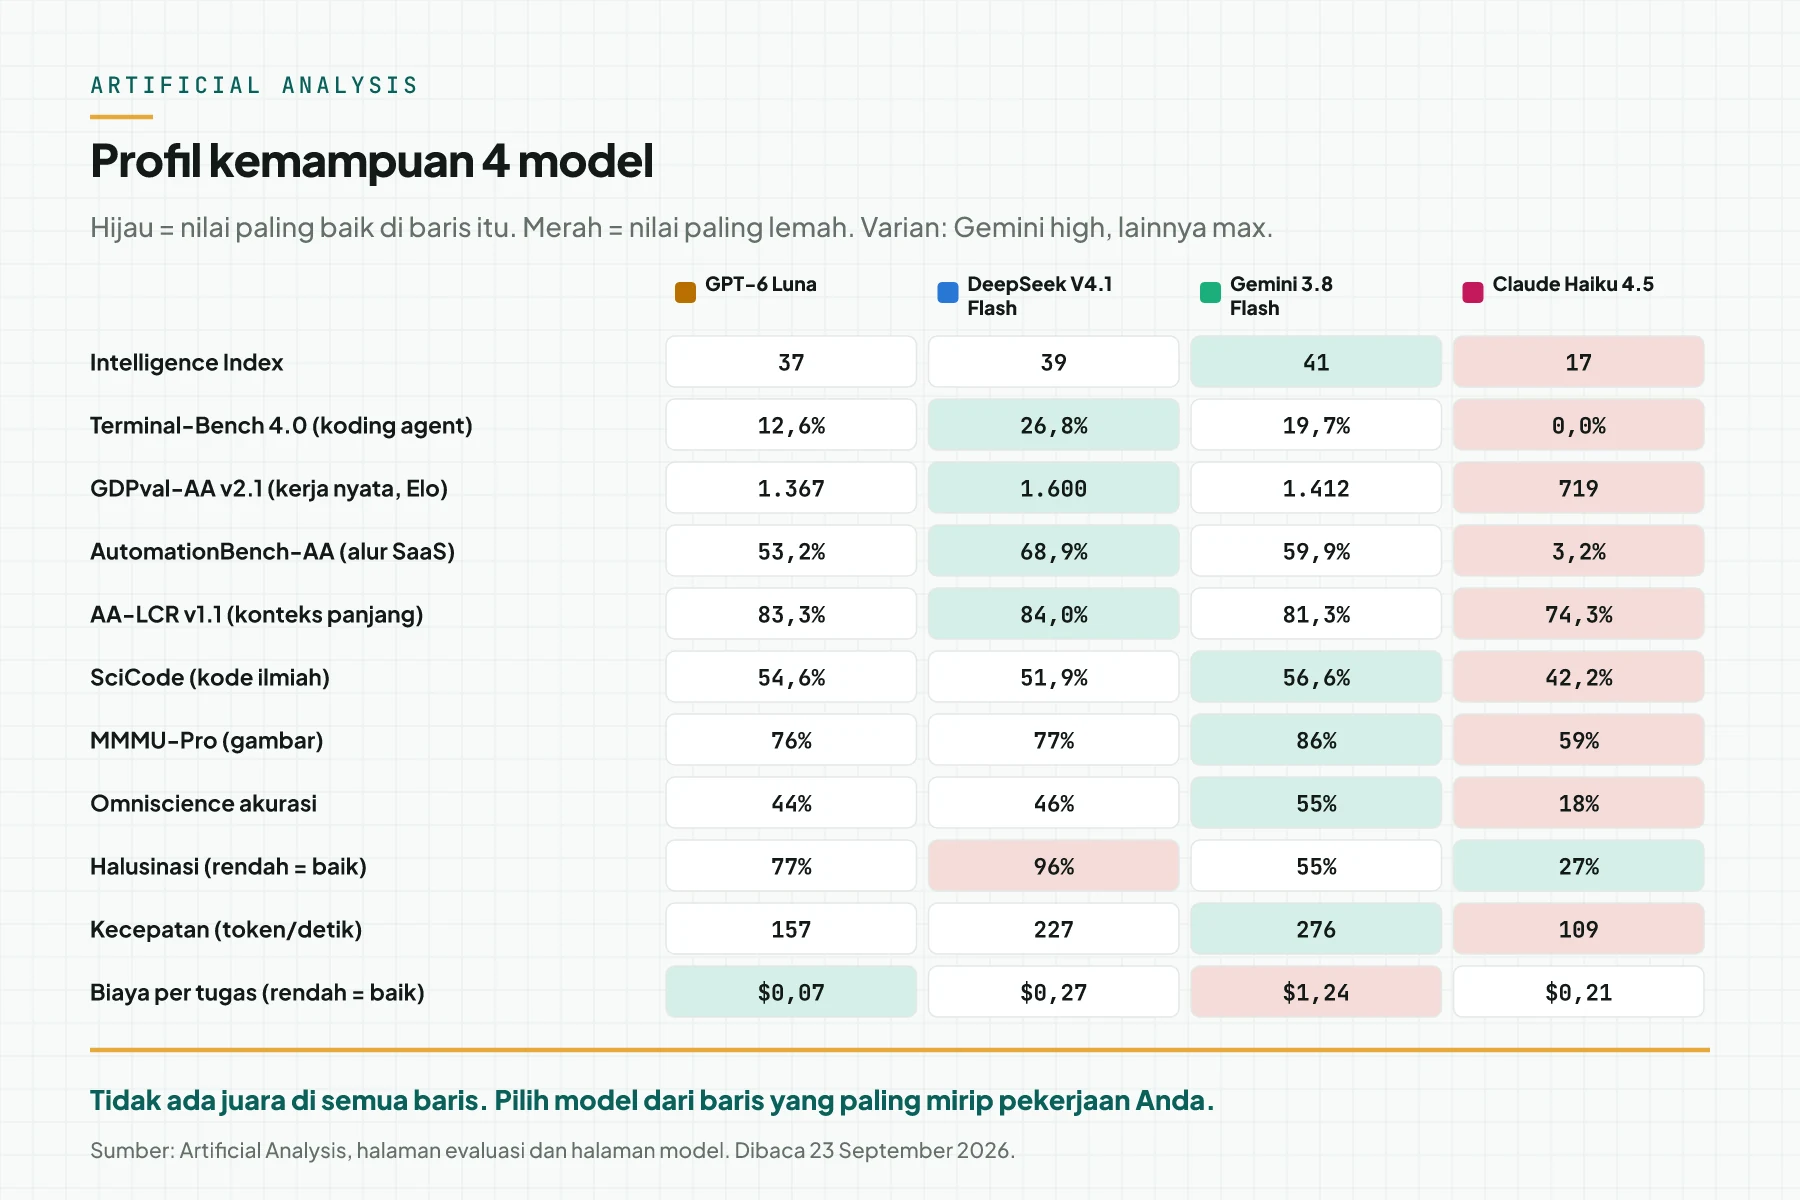
Untuk 𝜏³-Banking, yang menguji agent layanan pelanggan bank, Artificial Analysis baru mencatat 2 dari 4 model. Gemini 3.8 Flash mencetak 44,9%, dan Haiku 4.5 mencetak 9,3%.
Akurasi tidak sama dengan jujur
AA-Omniscience memisahkan 2 hal: berapa banyak jawaban yang benar, dan seberapa sering model menebak saat tidak tahu. DeepSeek benar pada 46% soal, tetapi menjawab salah pada 96% soal yang tidak ia ketahui. Haiku 4.5 hanya benar 18%, tetapi paling sering mengaku tidak tahu.
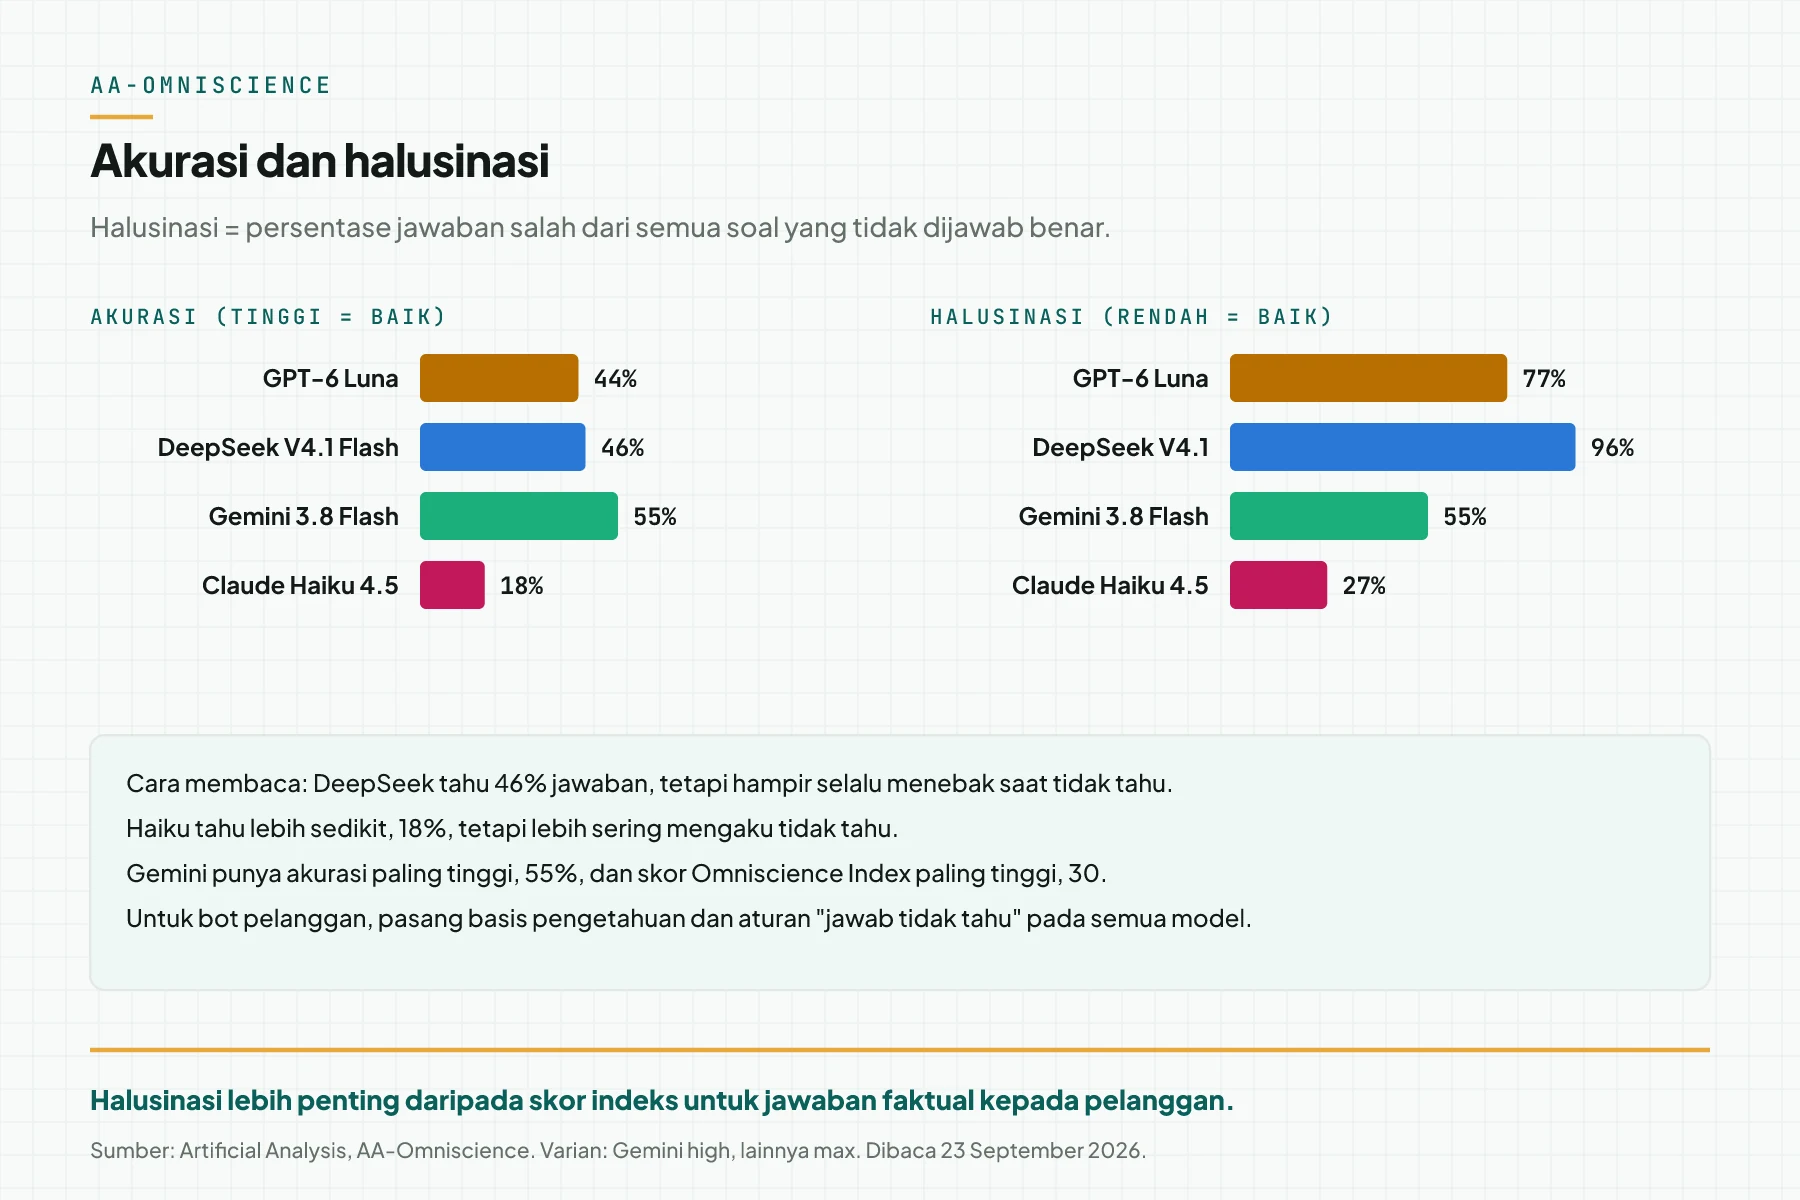
Untuk bot pelanggan, angka halusinasi lebih penting daripada skor indeks. Satu jawaban karangan tentang harga atau garansi dapat merugikan penjualan. Jadi pasang basis pengetahuan dan aturan "jawab tidak tahu" pada semua model, bukan hanya pada model yang lemah.
Yang perlu Anda siapkan
- Akses API ke minimal 2 vendor, atau 1 gateway yang meneruskan ke beberapa vendor.
- Daftar 20 tugas nyata dari 1 alur kerja, lengkap dengan jawaban yang benar.
- 1 validator kode per tugas: skema JSON, hitung ulang, atau daftar fakta yang boleh disebut.
- Log per panggilan yang menyimpan model, effort, token, waktu, hasil validator, dan biaya.
- Keputusan tertulis tentang data pribadi: data apa yang boleh keluar dari Indonesia, dan ke vendor mana.
- Kurs rupiah untuk laporan. Kami memakai JISDOR Bank Indonesia 22 September 2026: Rp17.883 per USD.
Langkah 1: Petakan setiap tugas ke 1 kandidat model
Mulai dari tugas, bukan dari model. Jawab 4 pertanyaan pada diagram dari atas, lalu berhenti pada jawaban "ya" pertama.
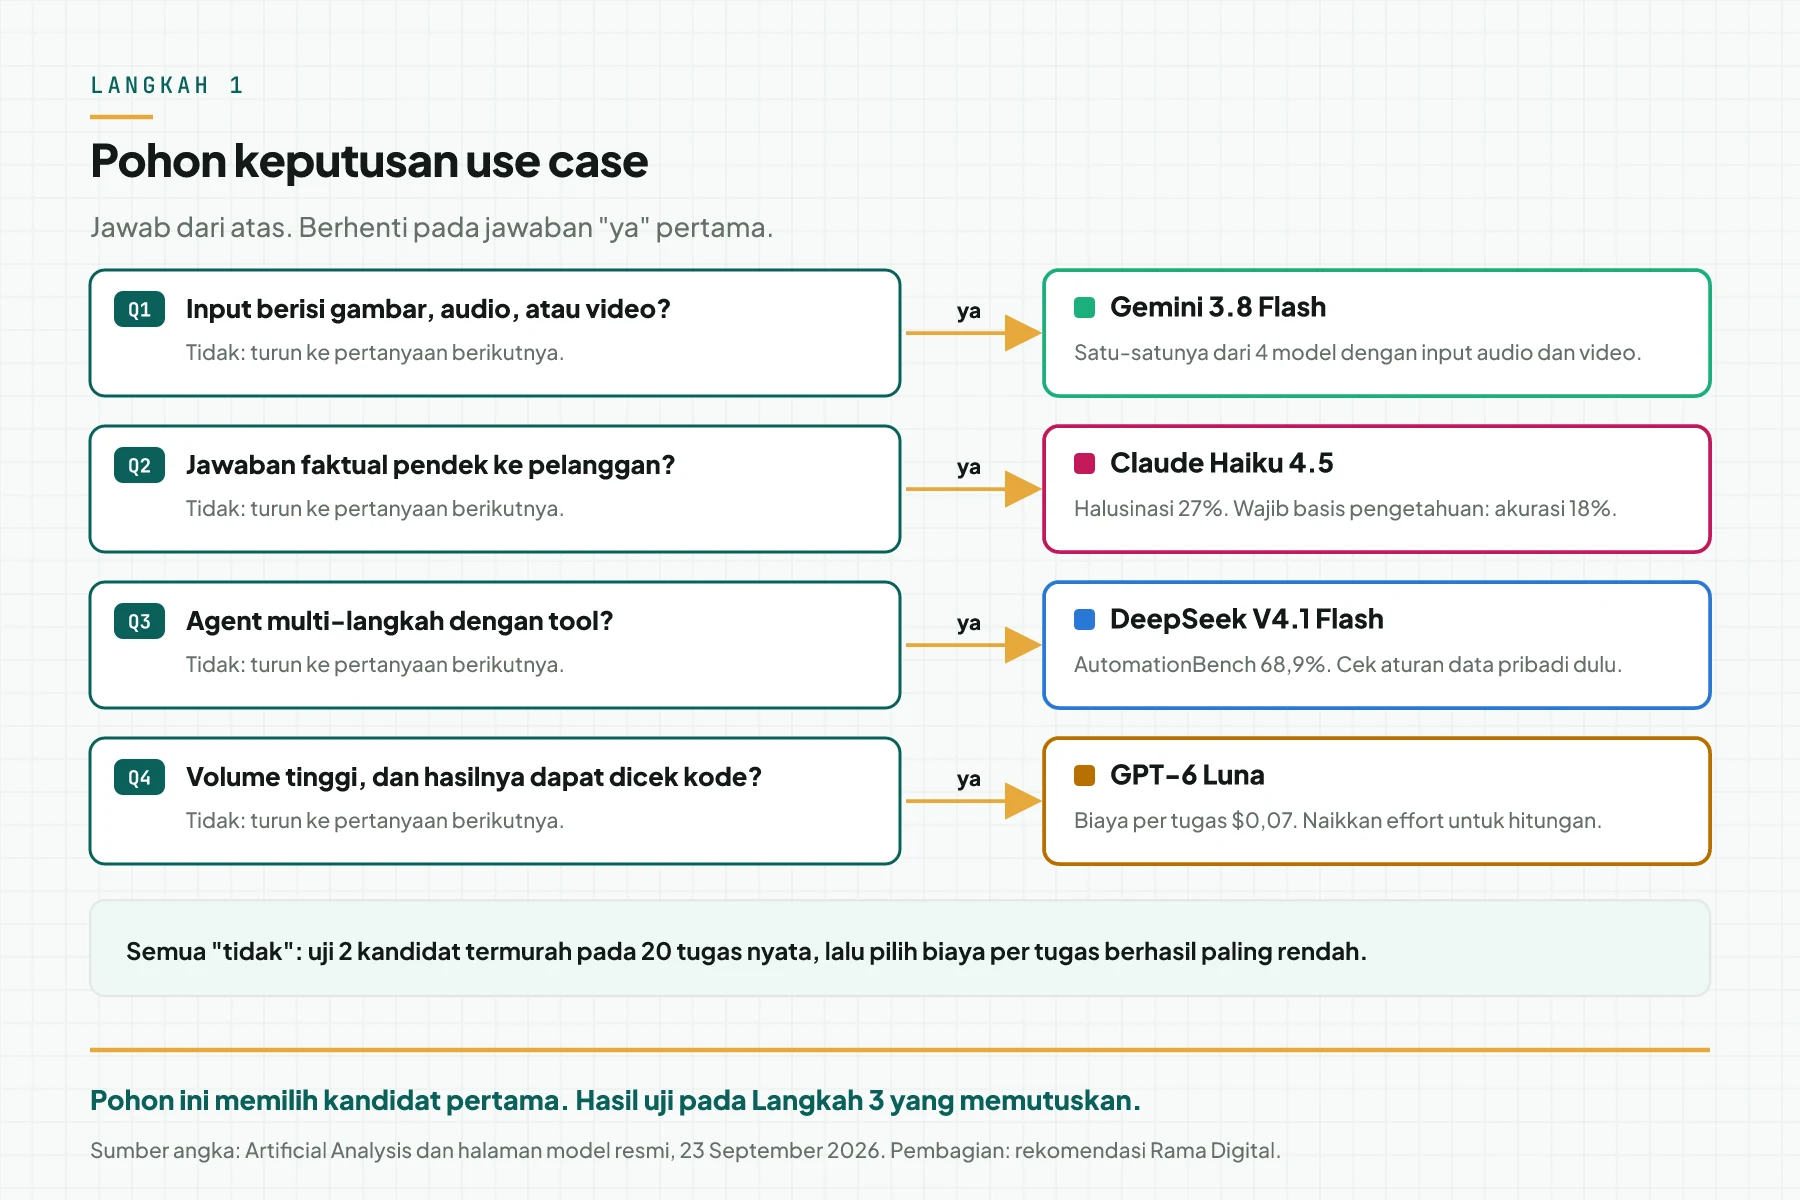
- Input berisi gambar, audio, atau video? Pilih Gemini 3.8 Flash. Dari 4 model ini, hanya Gemini yang menerima audio dan video menurut halaman model resmi.
- Jawaban faktual pendek ke pelanggan? Pilih Haiku 4.5. Halusinasinya paling rendah, 27%, tetapi akurasinya hanya 18%, jadi pasang basis pengetahuan.
- Agent multi-langkah dengan tool? Pilih DeepSeek V4.1 Flash bila data boleh diproses di luar negeri. Bila tidak boleh, pilih Gemini 3.8 Flash.
- Volume tinggi, dan hasilnya dapat dicek kode? Pilih Luna. Biaya per tugasnya paling rendah, $0,07.
Periksa: setiap tugas di daftar 20 tugas Anda mendapat 1 kandidat. Pembagian ini adalah rekomendasi Rama Digital yang berasal dari angka Artificial Analysis dan halaman resmi di atas.
Langkah 2: Hitung biaya per bulan dalam rupiah
Kalikan token per bulan dengan harga per token. Simulasi berikut memakai data dummy, token yang sama untuk semua model, tanpa cache, dan tanpa token reasoning. Tujuannya adalah melihat selisih harga daftar.
| Beban kerja per bulan | Luna | DeepSeek | Gemini | Haiku 4.5 |
|---|---|---|---|---|
| Balasan CS: 20.000 percakapan, 120 juta input, 20 juta output | Rp393.426 | Rp1.072.980 | Rp2.950.695 | Rp3.934.260 |
| Ekstraksi pesanan: 50.000 pesan, 40 juta input, 7,5 juta output | Rp138.593 | Rp375.543 | Rp1.039.449 | Rp1.385.933 |
| Ringkasan dokumen: 500 dokumen, 75 juta input, 1,5 juta output | Rp147.535 | Rp434.557 | Rp1.106.511 | Rp1.475.348 |
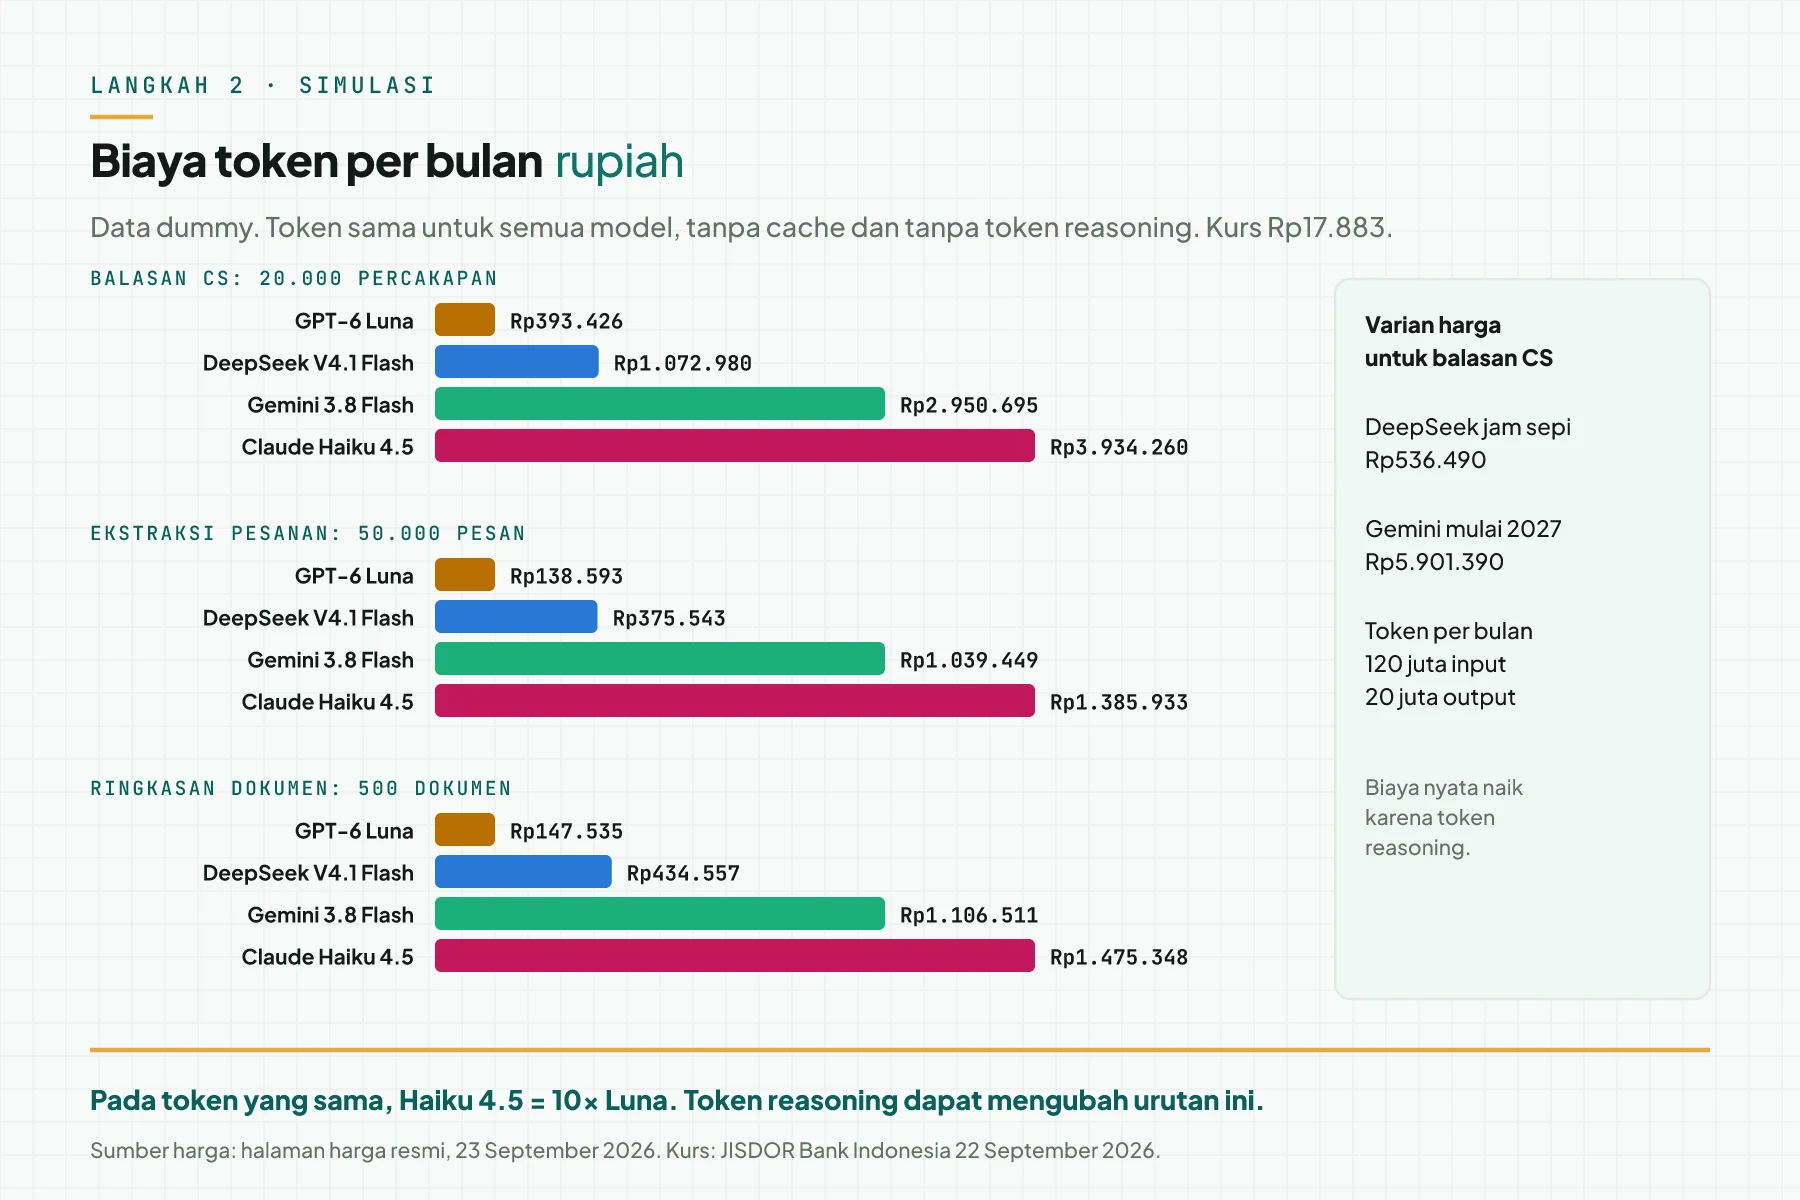
Dua varian mengubah tabel ini. Balasan CS di DeepSeek pada jam sepi turun menjadi Rp536.490. Balasan CS di Gemini dengan harga 2027 naik menjadi Rp5.901.390.
Periksa: angka Anda harus dihitung ulang dengan token reasoning dari log. Rumus lengkap dengan cache dan premi konteks panjang ada di panduan menghitung biaya API per tugas.
Langkah 3: Uji semua kandidat dengan prompt yang sama
Kirim prompt yang sama persis ke setiap kandidat, lalu nilai hasilnya dengan kode. Kami melakukannya pada 23 September 2026 lewat gateway internal dengan setelan bawaan setiap model. Setiap tugas berjalan 2 kali.
- Hitung invoice: 3 item, diskon untuk 1 item, PPN 11%, dan biaya admin di luar PPN. Jawaban benar: Rp7.249.250.
- Ekstraksi JSON: chat WhatsApp dengan ralat jumlah dari 24 menjadi 30 pcs.
- Balasan CS: maksimal 3 kalimat, harga persis, tanpa emoji, dan diakhiri 1 pertanyaan.
- Kode rupiah: fungsi
formatRupiahyang diuji dengan 7 kasus, termasuk angka negatif. - Fitur fiktif: pertanyaan tentang fitur Meta Business SuiteBusiness ManagerTempat Meta menyimpan aset iklan usaha Anda: akun iklan, Halaman, pixel, dan hak akses orang.Buka glosarium yang tidak ada. Model lulus bila menyatakan fitur itu tidak ada.
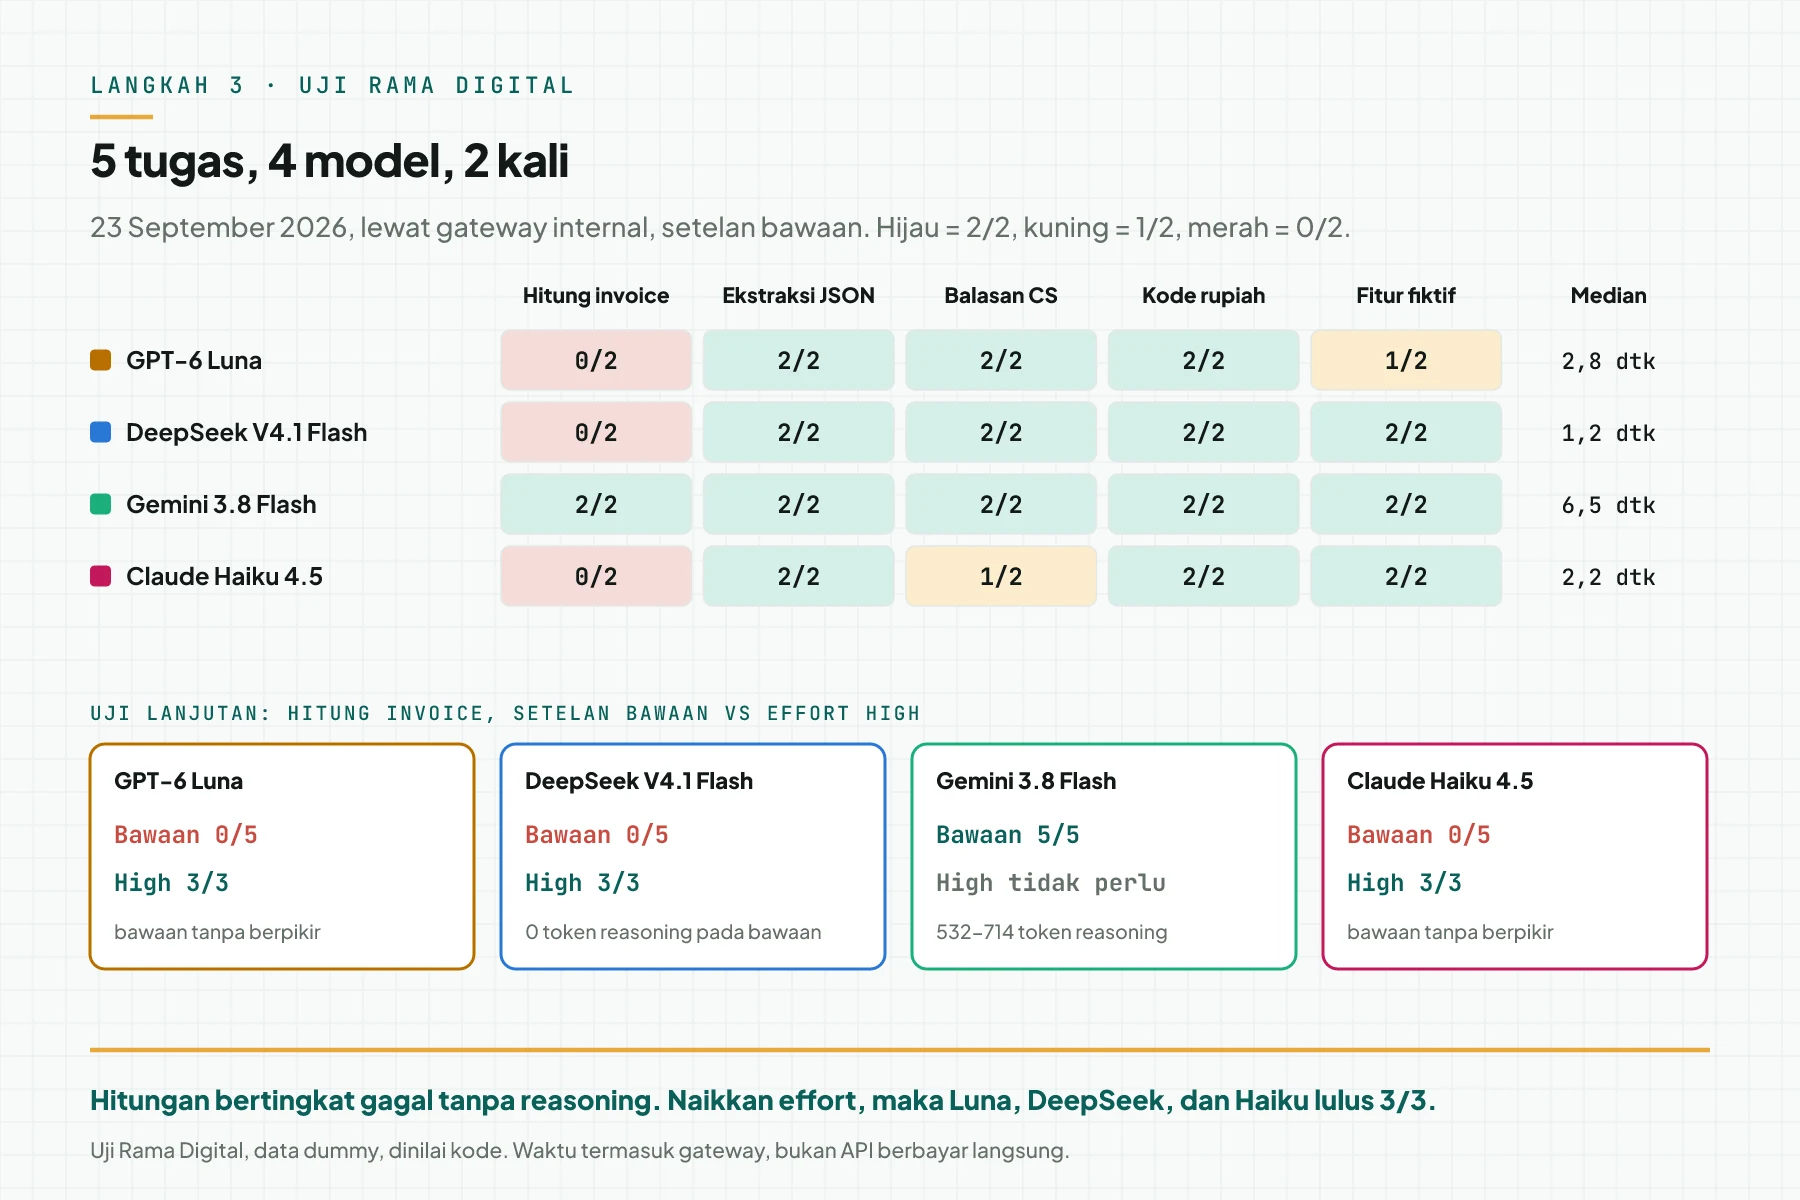
| Model | Invoice | JSON | Balasan CS | Kode | Fitur fiktif | Total | Median waktu |
|---|---|---|---|---|---|---|---|
| GPT-6 Luna | 0/2 | 2/2 | 2/2 | 2/2 | 1/2 | 7/10 | 2,8 detik |
| DeepSeek V4.1 Flash | 0/2 | 2/2 | 2/2 | 2/2 | 2/2 | 8/10 | 1,2 detik |
| Gemini 3.8 Flash | 2/2 | 2/2 | 2/2 | 2/2 | 2/2 | 10/10 | 6,5 detik |
| Claude Haiku 4.5 | 0/2 | 2/2 | 1/2 | 2/2 | 2/2 | 7/10 | 2,2 detik |
Temuan paling penting ada di tugas invoice. Pada setelan bawaan, DeepSeek berjalan dengan 0 token reasoning dan menjawab dengan angka acak antara Rp8,9 juta dan Rp14 juta. Dengan reasoning_effort: "high", DeepSeek memakai 192 sampai 277 token reasoning dan lulus 3 dari 3.
Luna dan Haiku menunjukkan pola yang sama: 0 dari 5 pada setelan bawaan, 3 dari 3 pada effort high. Gemini berpikir secara bawaan dengan 532 sampai 714 token reasoning, jadi Gemini lulus 5 dari 5 tanpa perubahan setelan.
Dua catatan kecil. Haiku gagal 1 balasan CS karena sapaan "Halo kak!" menjadi kalimat ke-4. Luna mengarang langkah untuk fitur fiktif pada 1 dari 2 percobaan, sedangkan 3 model lain menolak kedua kalinya.
Batas uji ini: gateway kami memakai koneksi langganan, bukan API berbayar langsung, jadi waktu respons termasuk jeda gateway. Blok kode dari Haiku tidak ditutup lewat gateway, dan kami menilai isi kodenya. Kami menduga ini efek gateway, bukan model.
Langkah 4: Pasang routing dan fallback
Satu model untuk semua tugas selalu terlalu mahal atau terlalu lemah. Pasang router aturan yang membaca kelas tugas dari Langkah 1, lalu validator yang memutuskan kapan tugas naik kelas.
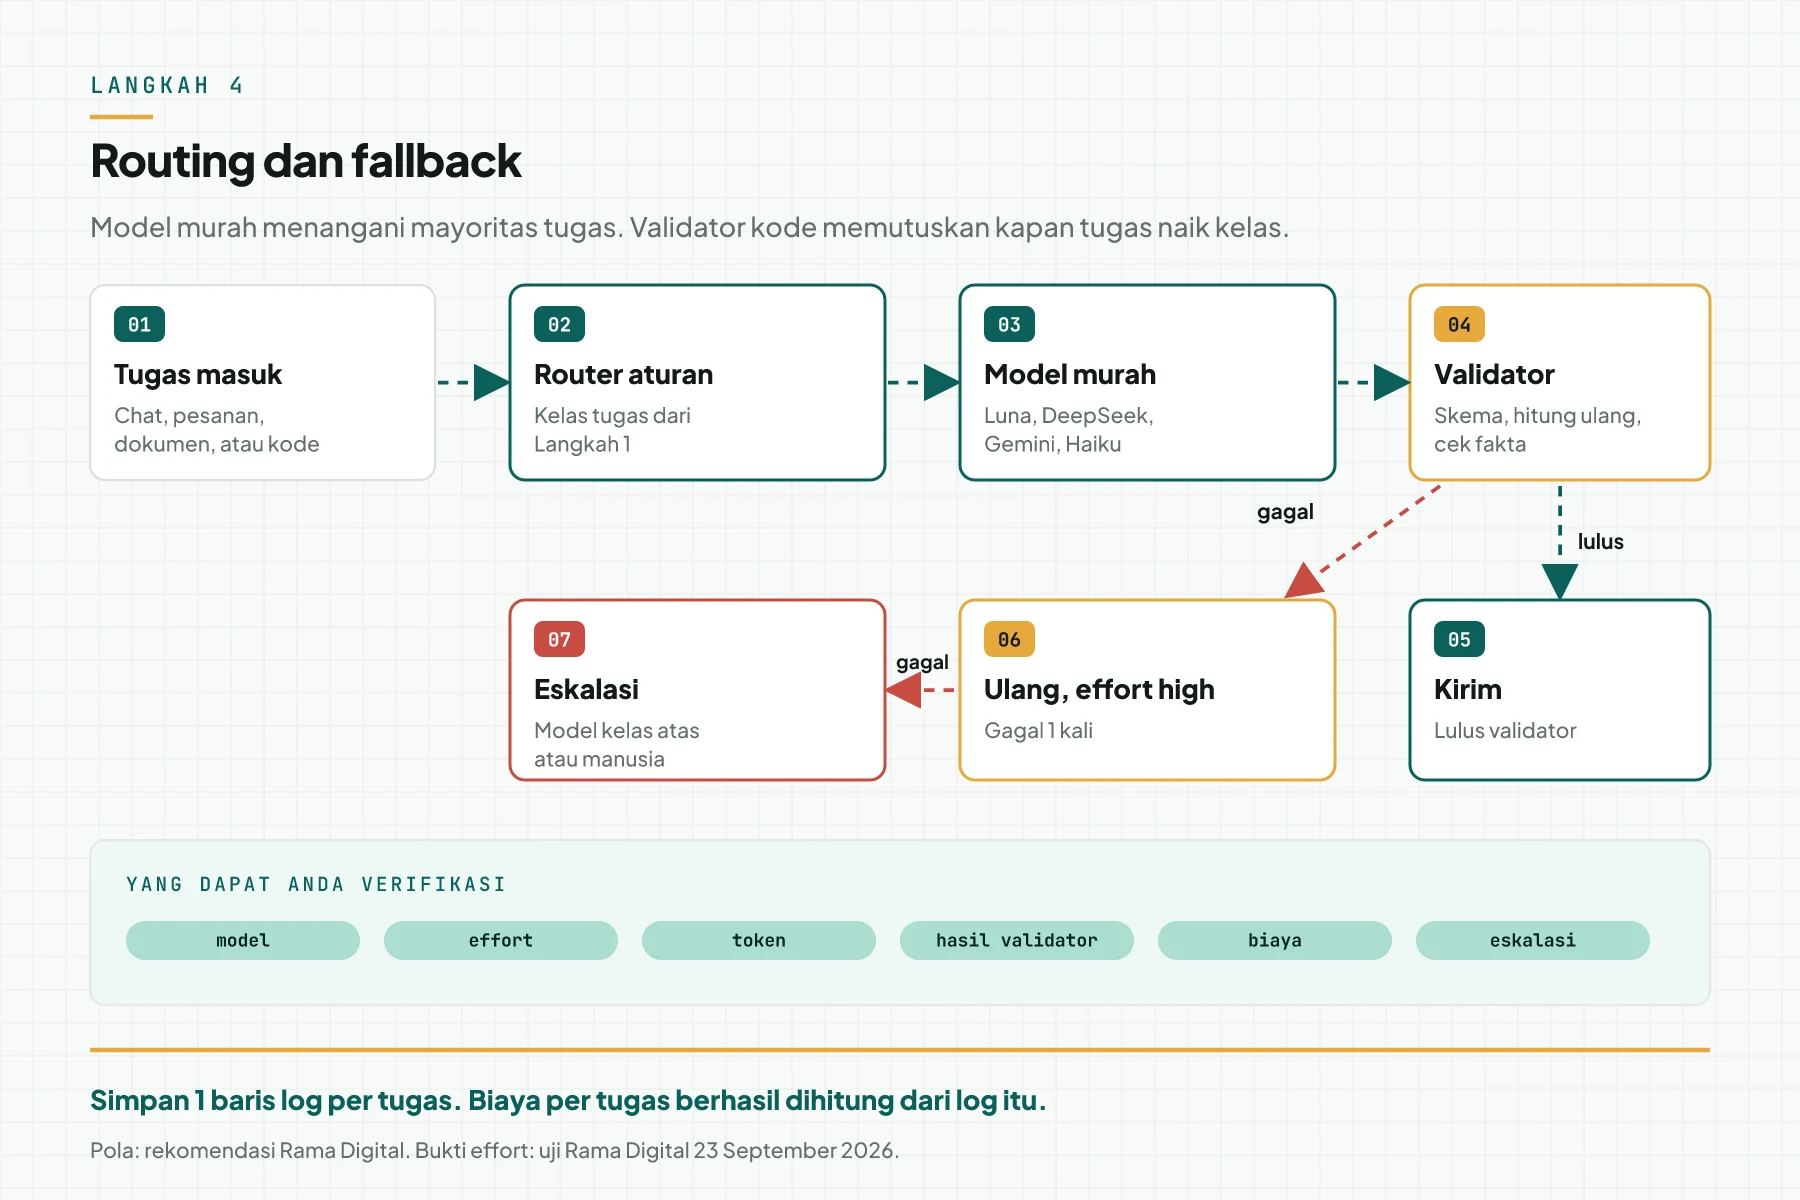
- Kirim tugas ke kandidat dari Langkah 1 dengan effort bawaan.
- Jalankan validator. Bila lulus, kirim hasilnya.
- Bila gagal, ulang 1 kali dengan effort high. Uji kami menunjukkan langkah ini memperbaiki semua kegagalan hitung invoice.
- Bila gagal lagi, eskalasi ke model kelas atas atau ke manusia.
Periksa: log menunjukkan persentase tugas yang naik kelas. Bila lebih dari 10% tugas naik kelas, kandidat murah itu salah untuk kelas tugas tersebut. Ambang 10% adalah rekomendasi Rama Digital, bukan angka vendor.
Langkah 5 (opsional): Jadwalkan ulang harga dan versi
Harga model murah berubah lebih cepat daripada harga model besar. Tandai tanggal pada diagram di kalender tim, lalu hitung ulang Langkah 2 setiap kali tanggal itu lewat.
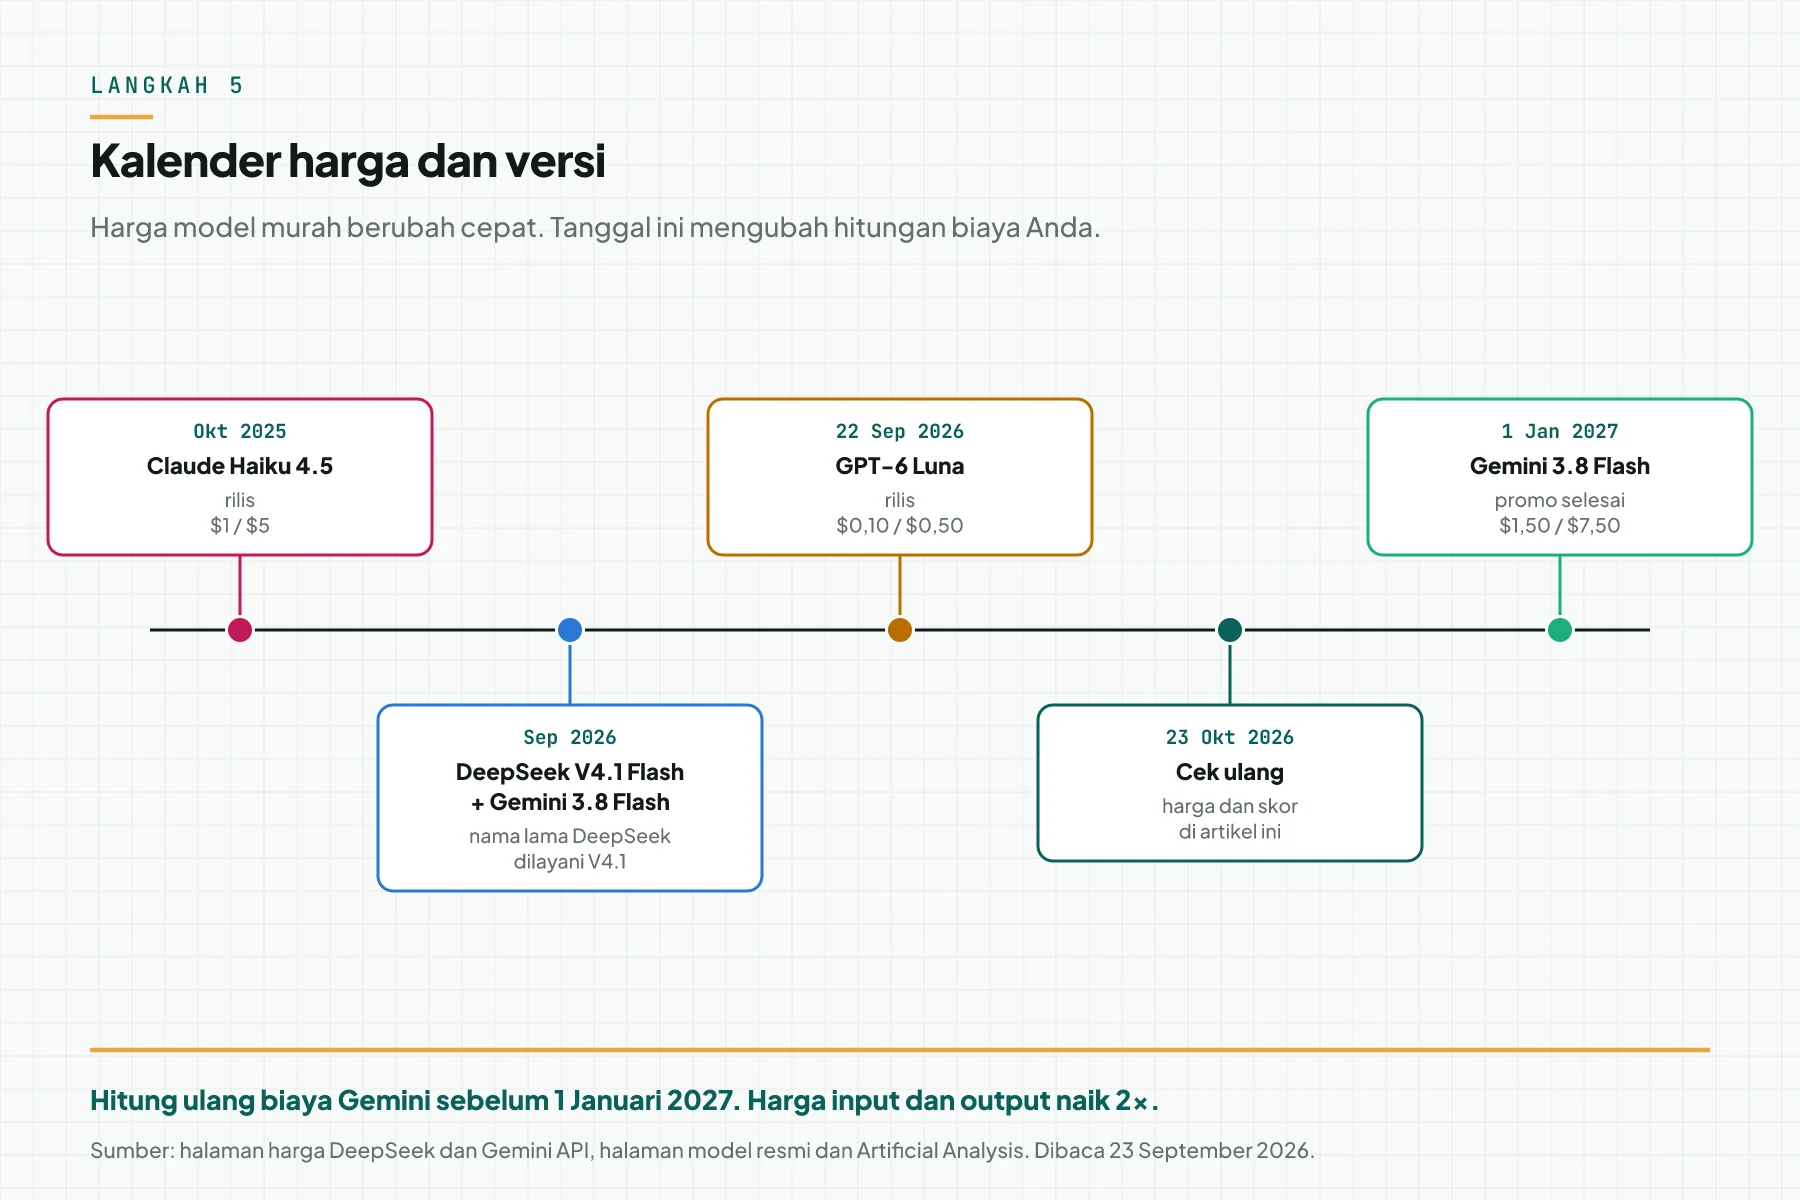
Periksa: pengingat 1 Desember 2026 ada di kalender, sehingga Anda punya 1 bulan untuk memindahkan trafik Gemini bila perlu. Detail rilis Luna ada di catatan harga dan spesifikasi GPT-6 Luna.
Contoh kerja: 1 hari di toko kaos dummy
Simulasi dengan data dummy. Toko kaos fiktif menerima 6 tugas pada Kamis, 1 Oktober 2026. Token adalah asumsi, dan biaya memakai harga standar dengan kurs Rp17.883.
| Waktu WIB | Tugas masuk | Keputusan router | Yang dicatat log | Hasil dan biaya |
|---|---|---|---|---|
| 08.15 | Pesanan WhatsApp: 30 kaos polo navy, kirim ke Sleman | Ekstraksi, GPT-6 Luna, effort bawaan | 800 token input, 150 token output, JSON lulus skema | Pesanan masuk sistem, Rp2,77 |
| 09.40 | Pertanyaan: "bisa COD?" | CS faktual, Haiku 4.5 dengan basis pengetahuan | 1.500 input, 250 output, harga cocok katalog | Balasan terkirim, Rp49,18 |
| 10.05 | Hitung invoice 3 item dan PPN 11% | Hitungan, GPT-6 Luna, effort high | 300 input, 400 output termasuk reasoning, hitung ulang cocok | Invoice terkirim, Rp4,11 |
| 13.30 | Foto bukti transfer | Gambar, Gemini 3.8 Flash | 1.500 input, 200 output, nominal cocok invoice | Pembayaran tercatat, Rp33,53 |
| 14.10 | Komplain ukuran salah | CS berisiko, Haiku 4.5 dengan basis pengetahuan | Haiku menjanjikan refund di luar aturan, validator menolak, tugas naik ke admin | Admin membalas, Rp53,65 untuk 1 panggilan |
| 22.00 | Batch 500 deskripsi produk | Volume tinggi tanpa data pribadi, DeepSeek jam sepi | 200.000 input, 150.000 output, 8 deskripsi diulang | 500 deskripsi siap, Rp2.146 |
Total biaya token hari itu adalah Rp2.289. Keputusan paling hemat adalah memindahkan batch ke pukul 22.00, karena harga DeepSeek pada jam sepi hanya setengah. Keputusan paling aman adalah menyerahkan komplain ke admin setelah validator menolak janji refund.
Checklist sebelum memindahkan trafik
- Tulis 20 tugas nyata per alur kerja dengan jawaban benar. Pemilik: pemilik proses. Bukti: berkas tugas bertanggal.
- Tulis 1 validator kode per tugas. Pemilik: developer. Bukti: tes validator yang lulus.
- Uji setiap kandidat dengan prompt sama pada effort bawaan dan high. Pemilik: developer. Bukti: log per panggilan.
- Hitung biaya per tugas berhasil dalam rupiah dari log. Pemilik: tim keuangan. Bukti: lembar biaya.
- Putuskan data apa yang boleh dikirim ke API DeepSeek. Pemilik: pemilik bisnis. Bukti: catatan keputusan UU PDP.
- Pasang routing, 1 ulang dengan effort high, dan eskalasi. Pemilik: developer. Bukti: konfigurasi router.
- Jadwalkan batch DeepSeek di luar jam sibuk WIB. Pemilik: tim operasional. Bukti: jadwal cron.
- Pasang pengingat harga 23 Oktober dan 1 Desember 2026. Pemilik: tim operasional. Bukti: undangan kalender.
- Berhenti menguji bila 1 kandidat lulus 19 dari 20 tugas dengan biaya per tugas berhasil paling rendah. Bila tidak ada kandidat yang lulus 18 dari 20, pakai model kelas atas untuk kelas tugas itu.
Kapan memilih model yang mana
Tabel ini merangkum fakta di atas per model. Setiap sel "pilih" dan "hindari" berasal dari angka yang sudah kami sebut beserta sumbernya.
| Model | Pilih bila | Hindari bila | Fakta pendukung |
|---|---|---|---|
| GPT-6 Luna | Volume tinggi, hasil dapat dicek kode, konteks di bawah 272.000 token | Hitungan pada effort bawaan, atau jawaban faktual tanpa basis pengetahuan | Biaya per tugas $0,07, AA-LCR 83,3%, halusinasi 77% |
| DeepSeek V4.1 Flash | Agent dan alur SaaS, batch di jam sepi, atau Anda butuh bobot terbuka | Data pribadi lewat API, atau jawaban faktual tanpa basis pengetahuan | AutomationBench 68,9%, GDPval 1.600, halusinasi 96%, lisensi MIT |
| Gemini 3.8 Flash | Gambar, audio, video, pengetahuan umum, dan kecepatan | Anggaran ketat setelah 1 Januari 2027 | Indeks 41, MMMU-Pro 86%, 276 token per detik, biaya per tugas $1,24 |
| Claude Haiku 4.5 | Jawaban pendek yang harus hati-hati, dengan basis pengetahuan | Agent multi-langkah, hitungan tanpa extended thinking, atau konteks di atas 200.000 token | Halusinasi 27%, akurasi 18%, 2,2 menit per tugas, AutomationBench 3,2% |
Kebijakan privasi DeepSeek menulis bahwa DeepSeek memproses dan menyimpan data pribadi di Republik Rakyat Tiongkok. Bila aturan internal Anda melarang itu, jalankan bobot terbuka DeepSeek di server sendiri atau pakai model lain untuk data pelanggan.
Rekomendasi Rama Digital: jadikan Luna jalur bawaan untuk tugas yang dapat dicek kode, Gemini 3.8 Flash jalur multimodal, dan Haiku 4.5 jalur jawaban pelanggan. Rekomendasi ini berlaku bila Anda punya validator kode dan basis pengetahuan. Pilih DeepSeek bila tugas Anda adalah agent tanpa data pribadi, terutama pada jam sepi.
Pertanyaan yang sering muncul
Model mana yang paling murah per tugas? GPT-6 Luna. Artificial Analysis mencatat $0,07 per tugas indeks untuk Luna, $0,21 untuk Haiku 4.5, dan $0,27 untuk DeepSeek. Harga token Luna juga paling rendah, $0,10 input dan $0,50 output.
Kenapa Claude Sonnet 5 tidak masuk perbandingan ini? Sonnet 5 berharga $2 input dan $10 output, 2x harga Haiku 4.5 dan 20x harga output Luna. Haiku 4.5 adalah model Claude dengan harga paling dekat dengan 3 model lain, jadi Sonnet 5 masuk kelas harga di atasnya.
Apakah DeepSeek Flash aman untuk data pelanggan? Kebijakan privasi DeepSeek menyatakan data pribadi diproses dan disimpan di Republik Rakyat Tiongkok. Periksa aturan UU PDP dan kontrak Anda. Alternatifnya adalah bobot terbuka DeepSeek di server sendiri.
Kenapa model murah gagal menghitung invoice? Pada setelan bawaan, Luna, DeepSeek, dan Haiku menjawab tanpa reasoning yang memadai untuk hitungan bertingkat. Pada uji kami, effort high memperbaiki ketiganya menjadi 3 dari 3.
Apakah harga Gemini 3.8 Flash akan naik? Ya. Halaman harga Gemini API mencantumkan $0,75 input dan $3,75 output sampai 31 Desember 2026, lalu $1,50 dan $7,50 mulai 1 Januari 2027.
Apakah Claude Haiku 4.5 masih layak dipakai? Ya, untuk jawaban pendek yang harus hati-hati dan cepat. Haiku 4.5 memiliki halusinasi 27%, paling rendah dari 4 model, dan waktu 2,2 menit per tugas indeks. Untuk agent multi-langkah, pilih DeepSeek atau Gemini, karena AutomationBench Haiku hanya 3,2%.
Langkah berikutnya
Batas yang tetap berlaku: skor independen dan uji kami hanya titik awal, karena prompt, data, dan risiko Anda berbeda. Uji 20 tugas nyata sebelum Anda memindahkan trafik atau menandatangani anggaran.
Bila Anda ingin kami memetakan jalur model untuk alur kerja Anda, buka AI Workflow Audit. Untuk berdiskusi dahulu, pilih jadwal konsultasi awal 30 menit.
Sumber
- OpenAI: halaman model GPT-6 Luna
- DeepSeek API Docs: Models & Pricing
- DeepSeek: Privacy Policy
- Google: Gemini Developer API pricing
- Google: halaman model Gemini 3.8 Flash
- Anthropic: harga Claude
- Anthropic: ringkasan model Claude
- Artificial Analysis: Intelligence Index v4.3.2
- Artificial Analysis: GPT-6 Luna, DeepSeek V4.1 Flash, Gemini 3.8 Flash, Claude 4.5 Haiku
- Bank Indonesia: kurs JISDOR