Jawaban langsung: Biaya chatbot AI naik karena setiap chat memanggil model, dan setiap panggilan membawa token. Untuk menekan biaya, jangan jawab semua chat dengan model mahal. Saring chat dulu, pilih model yang sesuai, pangkas konteks, dan batasi hasil tool.
Kondisi utama: cara ini berlaku untuk chatbot WhatsApp yang memakai model bahasa berbayar per token. Batas: hasil tiap bisnis berbeda. Angka di artikel ini berasal dari 1 kasus klien dan dari chatbot Rama Digital sendiri.
Sumber data: tagihan harian 1 klien B2B (distributor suku cadang industri) pada 15-24 September 2026, dan audit chatbot Wulan dengan JevJevModel AI kecil dari TypeSafe yang memutuskan nasib tiap chat: balas, lewati, tandai untuk tim, atau keluarkan dari follow-up. Jev tidak menulis balasan.Cara Jev memilih chat yang dijawab pada 20 September 2026. Kami menyamarkan identitas klien.
Kenapa biaya AI naik saat chat WhatsApp naik
Banyak pemilik bisnis melihat pola yang sama. Iklan Click-to-WhatsAppCTWAIklan Click-to-WhatsApp. Iklan ini membawa orang dari Facebook atau Instagram langsung ke percakapan WhatsApp Anda.Cara tracking iklan CTWA berjalan, chat masuk naik, lalu tagihan AI ikut naik. Kadang tagihan naik lebih cepat dari jumlah chat.
Rumus sederhananya seperti ini:
Biaya = jumlah pesan × token per balasan × tarif per token
Setiap faktor bisa membengkak sendiri:
- Jumlah pesan naik karena semua pesan dijawab, termasuk stiker dan "makasih".
- Token per balasan naik karena bot membaca ulang seluruh riwayat chat setiap kali menjawab.
- Tarif tinggi karena bot memakai model mahal untuk tugas yang ringan.
Kalau ketiga faktor naik bersama, biaya naik berlipat. Karena itu, penghematan juga harus menyentuh ketiga faktor. Bila Anda belum yakin chatbot Anda termasuk chatbot biasa atau agenticAgenticCara kerja saat tugas rutin dikerjakan agent AI, lalu staf atau owner memeriksa dan menyetujui hasilnya.Buka glosarium CRM, baca dulu perbedaan agentic CRM dan chatbot AI biasa.
Mulai 1 Oktober 2026, setiap balasan juga punya tarif Meta
Mulai 1 Oktober 2026, Meta menagih pesan layanan per pesan terkirim. Pesan layanan adalah balasan non-template di jendela 24 jam, termasuk balasan chatbot. Setiap nomor bisnis mendapat 1.000 pesan layanan gratis per bulan. Pesan ke-1.001 dan seterusnya ditagih Rp356,65 per pesan untuk penerima Indonesia.
Jadi chatbot yang membalas setiap pesan membayar 2 kali: biaya model AI dan tarif Meta. Contoh: 10.000 balasan per bulan berarti 9.000 pesan berbayar, atau sekitar Rp3,2 jt ke Meta saja. Rincian aturannya ada di artikel perubahan biaya WhatsApp 1 Oktober 2026.
3 sebab boros yang paling sering kami temukan
Pada kasus klien, kami menemukan 3 sebab utama:
- Bot mengirim ulang seluruh riwayat chat. Semakin panjang percakapan, semakin banyak token yang dibaca untuk 1 balasan. Satu percakapan membaca 516 ribu token masuk.
- Mode berpikir tinggi dihitung dengan tarif keluaran. Model "berpikir" sebelum menjawab. Pikiran itu dibayar dengan tarif keluaran, yang lebih mahal dari tarif masuk.
- Tool pencarian mengembalikan terlalu banyak data. Tool mengembalikan ratusan produk dengan semua kolom. Satu balasan tool berisi 368 produk, dengan ukuran 121 KB.
Dalam 7 hari sebelum perubahan, percakapan dengan konteks di atas 100 ribu token memakan 69% biaya. Pesan bergambar atau suara rata-rata berbiaya $0,435 per percakapan. Pesan teks rata-rata berbiaya $0,059.
4 lapis penghematan chatbot AI
Setiap lapis menekan 1 faktor dalam rumus. Pasang lapis dari atas ke bawah.
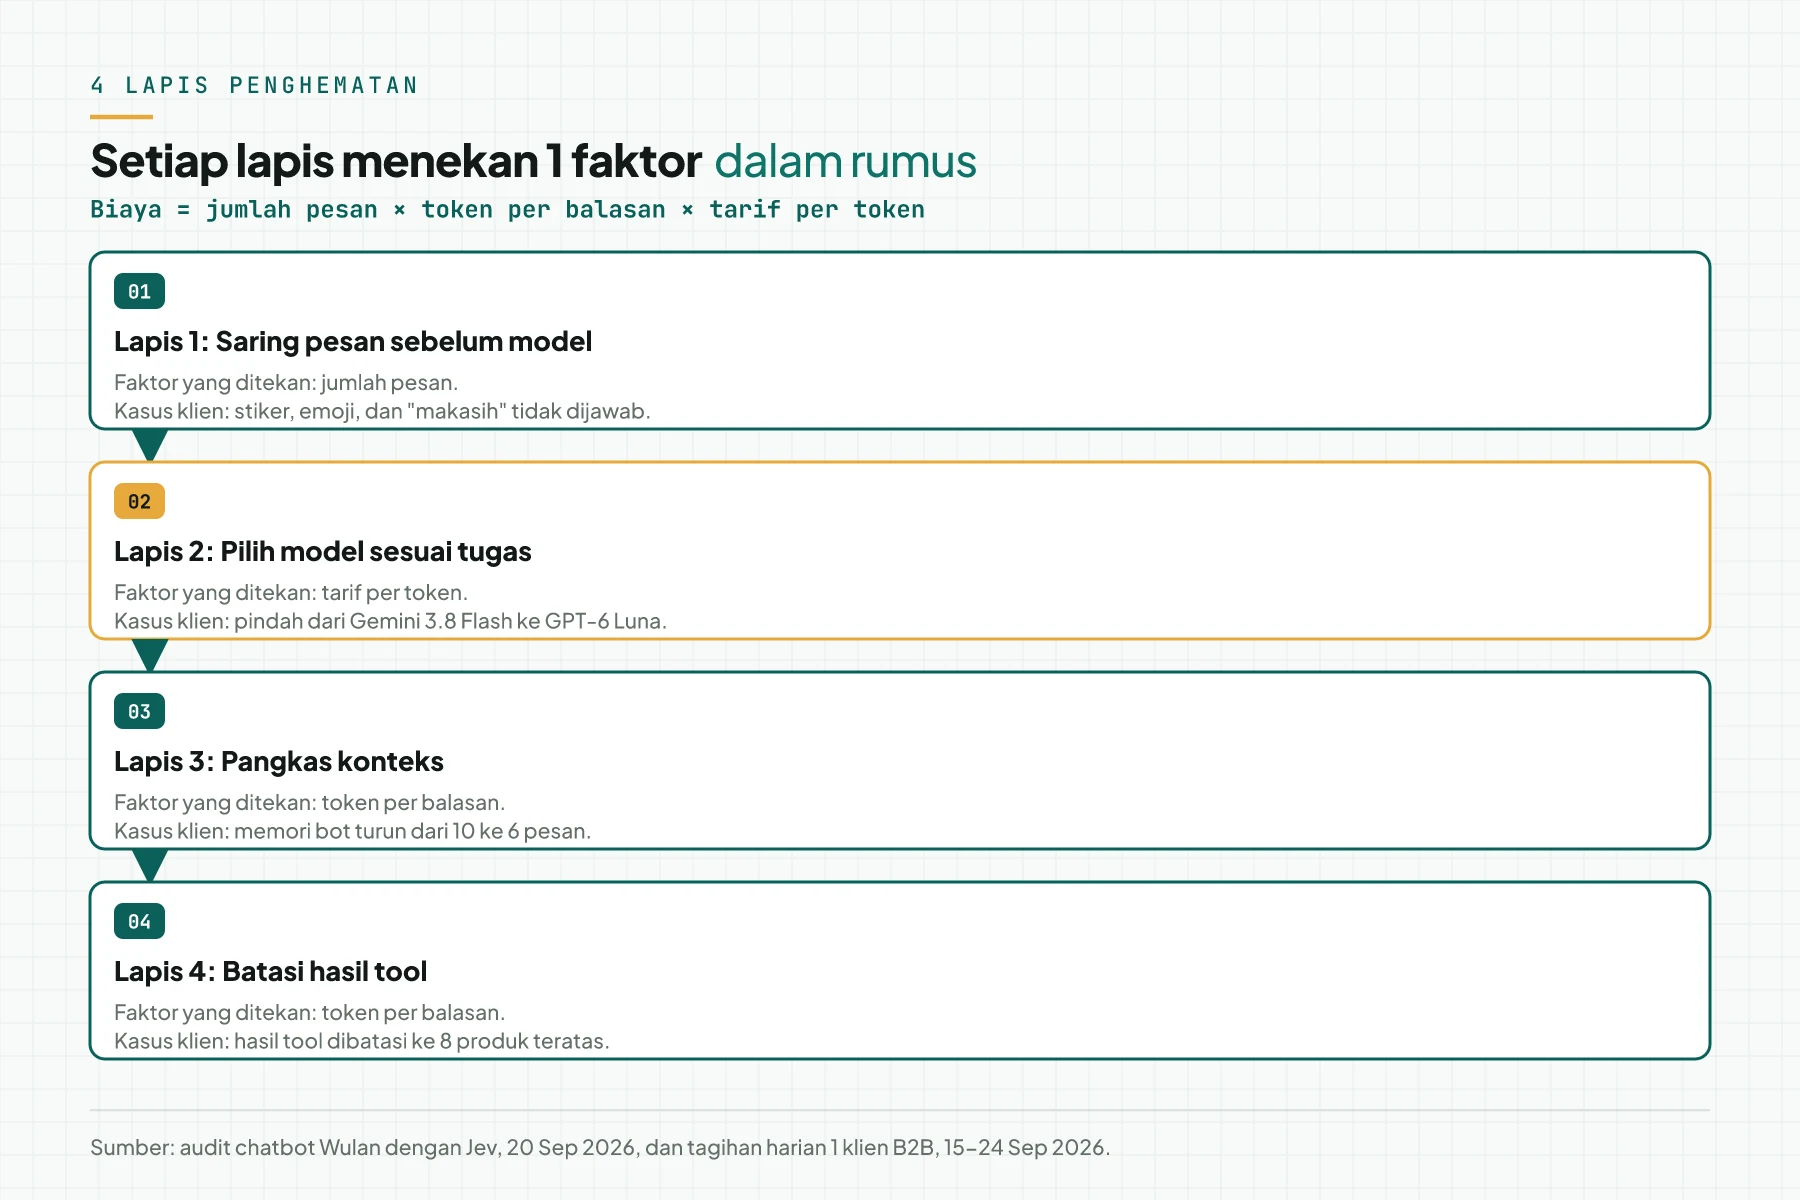
| Lapis | Faktor yang ditekan | Apa yang dilakukan | Contoh pada kasus klien |
|---|---|---|---|
| 1. Saring | Jumlah pesan | Tentukan pesan mana yang perlu dijawab model | Stiker, emoji, dan "makasih" tidak dijawab. Foto pribadi dilewati. |
| 2. Pilih model | Tarif | Pakai model murah untuk chat harian | Pindah ke GPT-6 Luna |
| 3. Pangkas konteks | Token per balasan | Kirim riwayat pendek saja | Memori turun dari 10 ke 6 pesan |
| 4. Batasi tool | Token per balasan | Kirim hasil tool yang relevan saja | Hasil tool dibatasi 8 teratas |
Lapis 1: saring pesan sebelum model
Saringan membaca pesan sebelum model chat bekerja. Pesan yang tidak butuh jawaban tidak memanggil model. Hasilnya, jumlah pesan yang dibayar turun.
Saringan juga harus tahu batasnya. Pada uji 70 foto di kasus klien, saringan melewati ±34 foto pribadi. Semua foto produk dan foto nota tetap dijawab.
Contoh sederhana: pelanggan menulis "oke, makasih ya" setelah menerima harga. Tanpa saringan, bot membaca seluruh riwayat dan menulis balasan baru. Dengan saringan, bot hanya mengirim reaksi 🙏.
Lapis 2: pilih model sesuai tugas
Model mahal tidak selalu menjawab lebih baik untuk chat harian. Bandingkan tarif per 1 juta token:
| Model | Token masuk | Token keluar | Token cache |
|---|---|---|---|
| Gemini 3.8 Flash | $0,75 | $3,75 | $0,075 |
| GPT-6 Luna | $0,10 | $0,50 | $0,01 |
Untuk data harga dan hitungan unit economics yang lebih lengkap, baca ulasan GPT-5.6 Sol, Terra, dan Luna.
Lapis 3: pangkas konteks
Bot tidak perlu membaca seluruh riwayat untuk menjawab pesan terbaru. Pada kasus klien, memori bot turun dari 10 ke 6 pesan. Token per balasan ikut turun.
Lapis 4: batasi hasil tool
Tool pencarian produk hanya perlu mengirim produk yang paling relevan. Pada kasus klien, hasil tool dibatasi ke 8 teratas. Balasan tool 368 produk tidak terjadi lagi.
Jev: lapisan keputusan sebelum model chat
Lapis 1 butuh keputusan cepat dan murah. Di chatbot Rama Digital sendiri, Wulan, keputusan ini dibuat oleh Jev sejak 24 September 2026.
Jev adalah model keputusan dari TypeSafe System One. Jev tidak menulis teks. Jev menjawab pertanyaan bertipe, seperti ya/tidak, pilihan, atau skor, dan menyertakan tingkat keyakinan.
Kenapa Jev murah
- Jev menjawab banyak pertanyaan dalam 1 panggilan.
- Harga Jev 0,042 USD per 1 juta token masuk. Token keluaran gratis.
- Di Wulan, biaya Jev ±0,27 USD per 30 hari.
- Pada audit 20 September 2026, Jev menjawab 1.100 pertanyaan dalam 287 panggilan. Waktu totalnya 20,8 detik, dengan biaya 0,0094 USD.
Kenapa keputusan tidak butuh model chat
Model chat dibuat untuk menulis jawaban panjang. Tugas itu mahal, karena model membaca konteks dan menulis banyak token keluaran.
Keputusan "jawab atau lewati" tidak butuh tulisan. Keputusan itu hanya butuh 1 jawaban pendek dan 1 angka keyakinan. Karena itu, model keputusan dapat bekerja dengan biaya kecil.
Pemisahan ini juga membuat bot lebih mudah diaudit. Setiap keputusan punya jawaban dan keyakinan yang tercatat. Tim Anda dapat membaca kenapa sebuah chat dilewati atau diserahkan ke manusia.
Jenis chat dan keputusan Jev
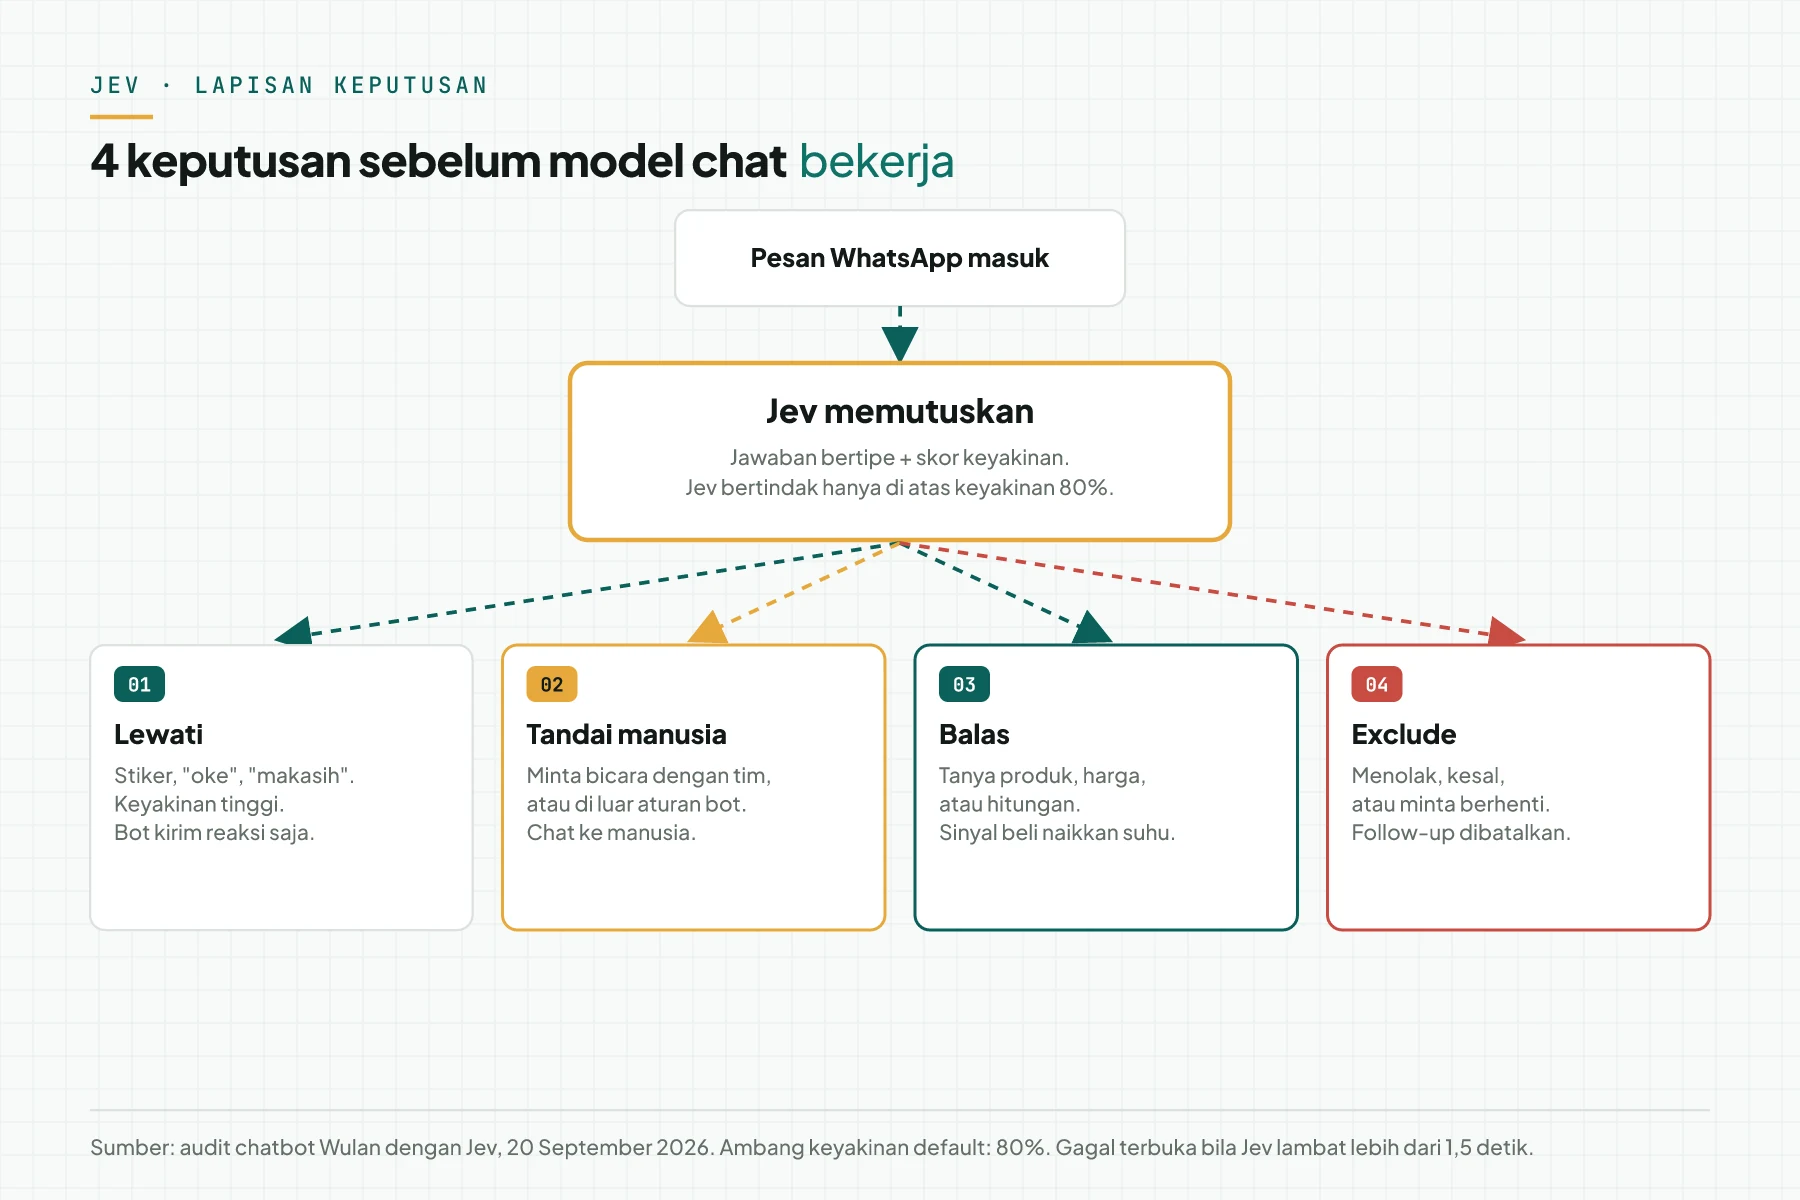
| Jenis chat | Keputusan | Apa yang terjadi |
|---|---|---|
| Hanya "makasih", "oke", atau "nanti", dengan keyakinan tinggi | Lewati | Bot mengirim reaksi 🙏 tanpa memanggil model chat |
| Orang meminta bicara dengan manusia | Tandai manusia | Bot menyerahkan chat ke tim |
| Pertanyaan butuh hitungan | Balas | Bot memakai mode nalar yang lebih kuat |
| Ada sinyal beli | Balas dan tandai | Suhu lead naik. Data ini tidak dikirim ke Meta |
| Orang menolak, minta tunggu, sudah selesai, atau kesal | Exclude | Follow-up dan nudge otomatis dibatalkan |
| Orang meminta berhenti | Exclude dan catat | Permintaan dicatat untuk audit |
| Pertanyaan biasa tentang produk atau harga | Balas | Model chat menjawab seperti biasa |
Jev hanya bertindak bila keyakinannya tinggi, misalnya di atas ambang keyakinan 80%. Di bawah ambang, bot berjalan seperti biasa.
Konsep exclude
Orang yang meminta berhenti atau kesal dikeluarkan dari follow-up. Mereka juga dikeluarkan dari audiens iklan ulang. Dengan cara ini, budget iklan tidak terbakar ke orang yang sudah menolak.
Gagal terbuka dan data pribadi
Bila Jev gagal atau lambat lebih dari 1,5 detik, bot berjalan seperti biasa. Kami menyebut ini gagal terbuka. Chat pelanggan tetap dijawab.
Sebelum dikirim ke Jev, teks dianonimkan. Nama, email, dan nomor telepon dihapus dari teks.
Kasus klien: biaya per balasan turun ±30x
Klien kami adalah 1 perusahaan B2B, distributor suku cadang industri. Chat WhatsApp mereka banyak berisi foto produk dan foto nota.
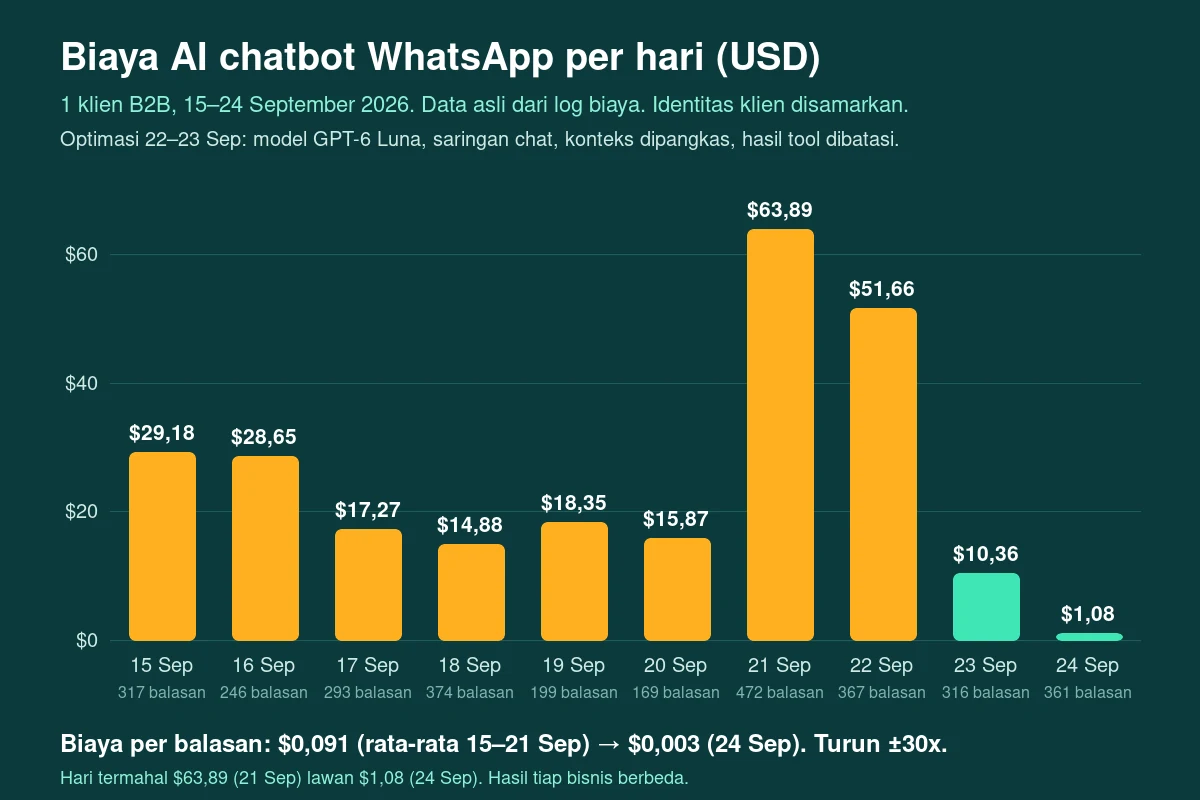
| Ukuran | Sebelum | Sesudah |
|---|---|---|
| Biaya per balasan AI | $0,091 (rata-rata 15-21 Sep 2026) | $0,003 (24 Sep 2026) |
| Biaya 1 hari | $63,89 (21 Sep, 472 balasan AI) | $1,08 (24 Sep, 361 balasan AI) |
| Rata-rata biaya per hari | ±$26,87 | — |
Perubahan yang kami pasang:
- Saringan pesan sebelum model.
- Pindah model dari Gemini 3.8 Flash ke GPT-6 Luna.
- Memori bot turun dari 10 ke 6 pesan.
- Hasil tool dibatasi 8 teratas.
Catatan jujur: pada kasus klien, saringan memakai model kecil yang murah, bukan Jev. Jev adalah lapisan keputusan yang kami pakai di chatbot sendiri. Kami juga memasang Jev di layanan optimasi chatbot.
2 pelajaran dari uji ulang
Ganti model tanpa mengubah aturan itu berisiko. Pada uji ulang, model baru meneruskan chat ke admin 27 kali dari 35 giliran. Model lama hanya 4 kali. Kami menambah 2 aturan perintah, dan angkanya turun ke 0.
Periksa batas permintaan penyedia model. Akun baru OpenRouter dibatasi 20 permintaan per menit untuk Luna. Produksi klien pernah menerima 25 chat per menit. Karena itu, kami memasang model cadangan.
Langkah 1: Ambil tagihan AI harian 7 hari terakhir
Buka log biaya AI Anda dan salin angka per hari untuk 7 hari terakhir. Simpan file tagihan per hari sebagai bukti. Pemilik langkah ini adalah pemilik bisnis.
Verifikasi: Anda punya 1 file atau 1 tabel dengan 7 baris, 1 baris per hari.
Langkah 2: Hitung biaya per balasan AI
Bagi biaya harian dengan jumlah balasan AI hari itu. Simpan tabel biaya per balasan sebagai bukti. Pemilik langkah ini adalah tim teknis.
Verifikasi: setiap hari pada tabel Langkah 1 punya 1 angka biaya per balasan.
Langkah 3: Pisahkan biaya chat teks dan chat bergambar atau suara
Tandai setiap balasan sebagai teks, gambar, atau suara. Hitung rata-rata biaya untuk tiap jenis. Simpan tabel biaya per jenis pesan sebagai bukti. Pemilik langkah ini adalah tim teknis.
Verifikasi: tabel menunjukkan 1 angka rata-rata biaya untuk tiap jenis pesan.
Langkah 4: Cari percakapan dengan konteks terpanjang
Urutkan percakapan dari token masuk terbesar ke terkecil. Catat 10 percakapan teratas sebagai daftar percakapan termahal. Pemilik langkah ini adalah tim teknis.
Verifikasi: daftar itu memuat nomor percakapan, jumlah token, dan biaya.
Langkah 5: Pasang saringan untuk stiker, emoji, dan "makasih"
Buat aturan yang mengenali pesan tanpa isi baru, seperti stiker, emoji, dan "makasih". Kirim reaksi untuk pesan itu, tanpa memanggil model chat. Simpan contoh pesan yang dilewati sebagai bukti. Pemilik langkah ini adalah tim teknis.
Verifikasi: Anda punya minimal 5 contoh pesan yang lolos saringan dengan benar.
Langkah 6: Uji model baru dengan chat lama sebelum pindah
Jalankan model baru pada chat lama yang sudah punya jawaban benar. Hitung jumlah chat yang diteruskan ke admin. Simpan angka itu sebagai bukti. Pemilik langkah ini adalah tim teknis.
Verifikasi: Anda tahu jumlah chat yang diteruskan ke admin, model lama dibanding model baru.
Langkah 7: Hentikan perubahan bila chat penting ikut terlewat
Periksa setiap chat yang dilewati saringan. Bila saringan melewati foto produk atau nota, kembalikan aturan lama. Simpan contoh chat yang salah dilewati sebagai bukti. Pemilik langkah ini adalah pemilik bisnis.
Ini adalah kriteria berhenti untuk seluruh checklist. Verifikasi: tidak ada chat penting yang salah dilewati pada 20 chat terakhir.
Kapan Anda perlu CRM agentic dari 0
Optimasi cocok bila chatbot Anda sudah menjawab dengan benar, tetapi biayanya terlalu tinggi. Kasus klien di atas termasuk jenis ini.
Bangun CRM agentic dari 0 bila chatbot Anda belum mencatat lead, belum tahu tahap penjualan, atau belum terhubung ke tim. Untuk kebutuhan ini, lihat OpenClaw CRM Operating System.
Pertanyaan yang sering diajukan
Kenapa biaya chatbot AI naik lebih cepat dari jumlah chat? Karena setiap balasan membaca riwayat chat. Percakapan yang panjang membawa lebih banyak token, jadi biaya per balasan ikut naik.
Apakah semua chat WhatsApp harus dijawab oleh AI? Tidak. Stiker, emoji, dan pesan "makasih" tidak butuh jawaban model. Saringan dapat mengirim reaksi saja dan menghemat panggilan model.
Apa itu Jev? Jev adalah model keputusan dari TypeSafe System One. Jev tidak menulis teks. Jev menjawab pertanyaan bertipe dengan tingkat keyakinan, dengan harga 0,042 USD per 1 juta token masuk.
Apakah saringan bisa melewatkan chat penting? Bisa, bila aturannya salah. Karena itu, uji saringan dengan chat lama. Pada kasus klien, semua foto produk dan nota tetap dijawab.
Apa yang terjadi bila Jev gagal atau lambat? Bot berjalan seperti biasa. Bila Jev gagal atau lambat lebih dari 1,5 detik, model chat tetap menjawab pelanggan.
Apakah ganti ke model murah saja dapat menekan biaya? Tidak selalu. Pada uji ulang, model baru tanpa aturan tambahan meneruskan 27 dari 35 giliran ke admin. Ubah aturan perintah bersama modelnya.
Langkah berikutnya
Hasil tiap bisnis berbeda, dan angka di atas berasal dari 1 kasus klien. Untuk tahu di mana biaya chatbot Anda bocor, mulai dari data tagihan Anda sendiri.
Pilih paket Optimasi Rp 6,9 jt, harga tetap, 1–2 minggu lewat Jasa Optimasi Chatbot AI. Kami membaca log biaya 14 hari, menemukan sebab boros, lalu memasang 4 lapis penghematan. Paket Custom mulai Rp 17 jt untuk lebih dari 1 bot atau channel. Mulai dari Konsultasi Awal 30 menit.