Jawaban langsung: pakai model keputusan seperti Jev bila hasil yang Anda butuhkan adalah keputusan yang dibaca kode, misalnya memilih 1 jalur, menilai 1 balasan, atau menahan 1 aksi. Pakai LLM generatif bila hasil yang Anda butuhkan adalah kalimat untuk dibaca manusia. Pada sistem nyata keduanya berjalan bersama, dan Jev berada di depan serta di belakang LLM.
Kondisi utama: perbandingan ini memakai jev-1.13 dan harga resmi pada 21 September 2026. Batas: kami tidak membandingkan ketepatan pada tolok ukur publik, karena angka itu berubah tiap rilis dan bergantung pada tugasnya.
Kami menulis banding ini dari dokumentasi resmi TypeSafe dan pemakaian sendiri pada 20 dan 21 September 2026.
Beda pertama: bentuk keluarannya
LLM generatif mengembalikan teks. Anda meminta jawaban tertutup, lalu kode Anda menebak maksud kalimatnya. Langkah menebak inilah yang pecah pada kasus tepi.
# Jalur LLM: jawaban teks, lalu ditebak kode
balasan = llm("Klasifikasikan tiket ini. Jawab billing, teknis, atau sales.")
tim = balasan.strip().lower()          # "Billing." -> gagal cocok
if tim not in {"billing", "teknis", "sales"}:
    tim = "lainnya"                    # jatuh ke keranjang sampah

# Jalur model keputusan: jawaban sudah bertipe
tim = hasil["answers"]["tim"]["choice"]          # "billing"
yakin = hasil["answers"]["tim"]["confidence"]    # 0.98
Model keputusan menghapus langkah menebak. Ruang jawaban Anda tulis sendiri, dan yang kembali sudah berbentuk data beserta peluang dan keyakinannya.
Beda kedua: yang menentukan ruang jawaban
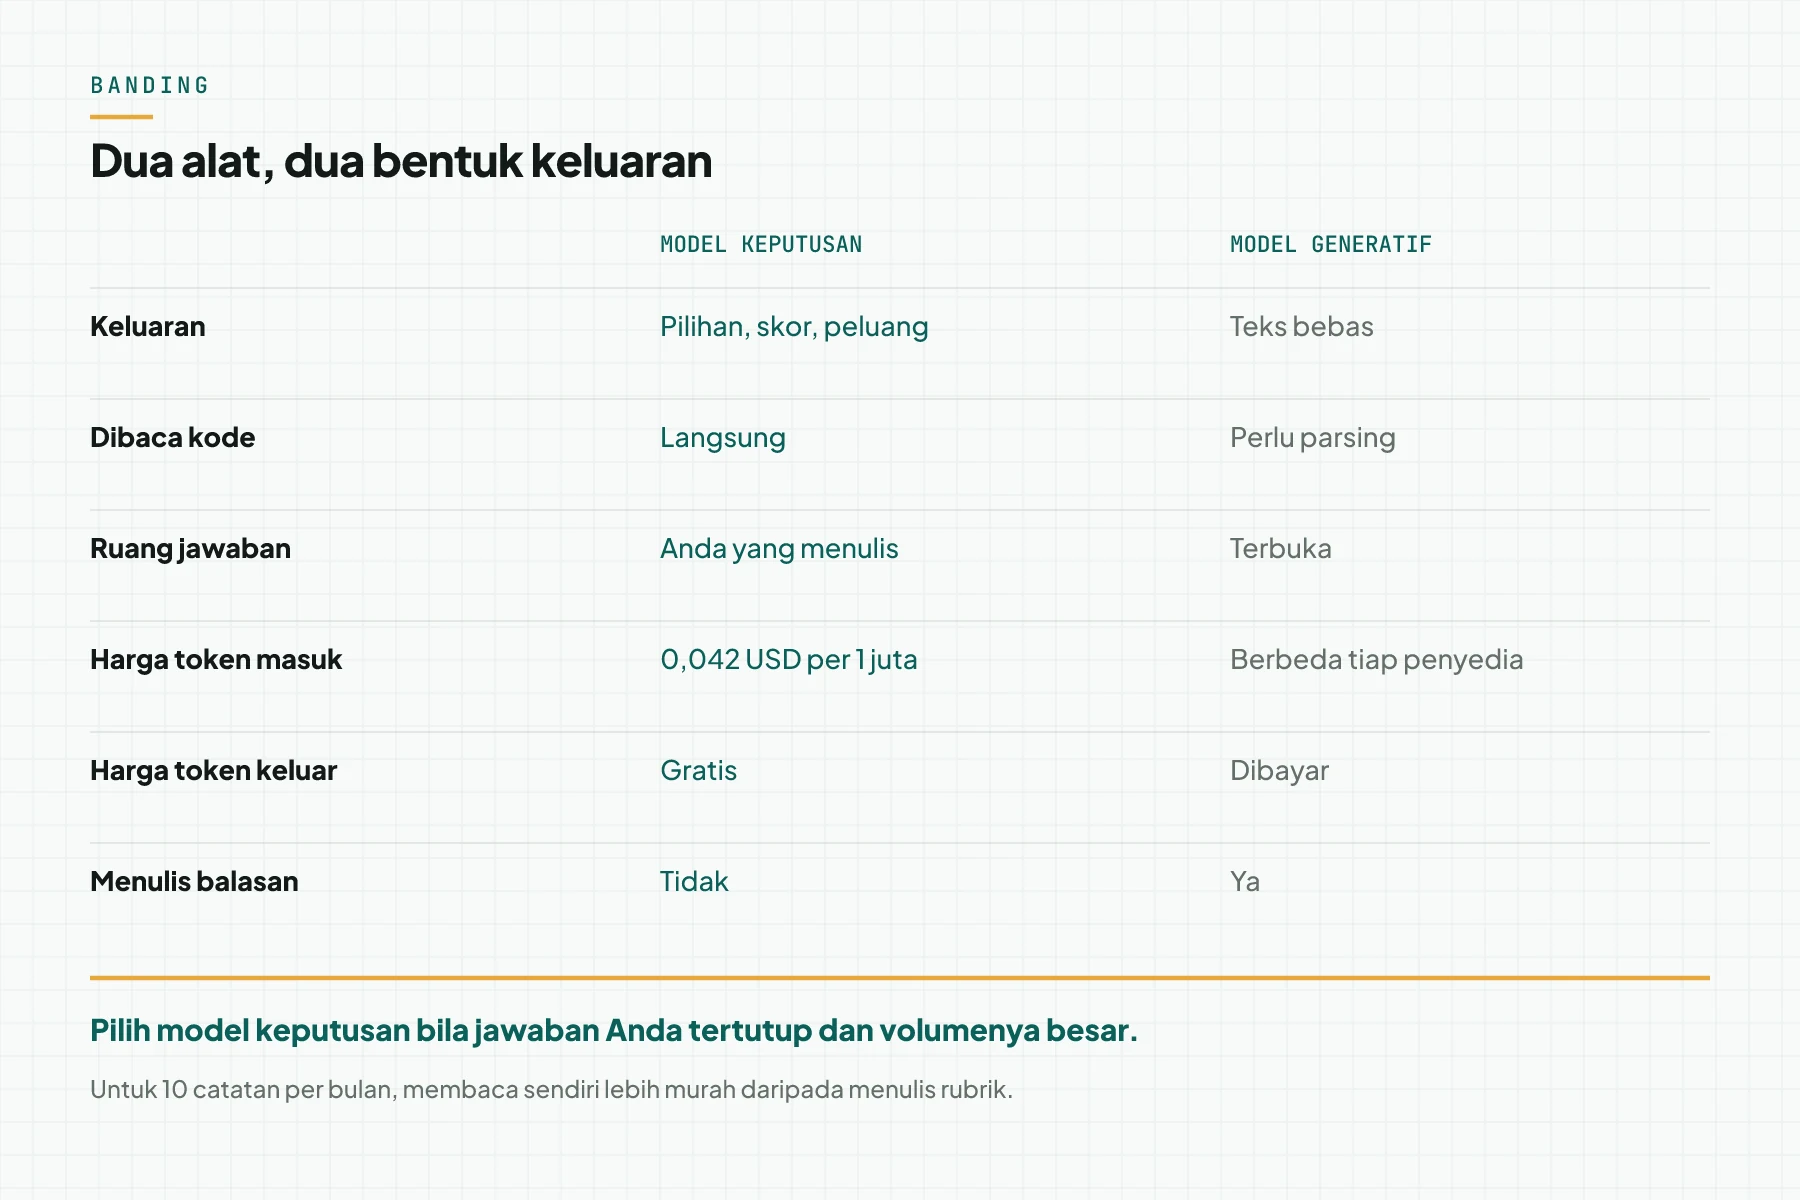
Pada LLM, ruang jawaban terbuka. Anda membatasinya lewat kalimat perintah, dan model dapat keluar dari batas itu.
Pada model keputusan, ruang jawaban adalah bagian permintaan. Choice memuat daftar opsi, Score memuat tangga, dan Noul hanya memiliki 2 kutub. Model tidak memiliki cara untuk menjawab di luar ruang itu.
Akibatnya jelas pada kode. Anda tidak perlu penjagaan format, tidak perlu percobaan ulang karena JSON rusak, dan tidak perlu keranjang "lainnya".
Beda ketiga: biaya dan waktu
| Ukuran | Model keputusan (Jev) | LLM generatif |
|---|---|---|
| Harga token masuk | 0,042 USD per 1 juta | Berbeda tiap penyedia, umumnya jauh di atas itu |
| Harga token keluar | Gratis | Dibayar, sering lebih mahal daripada token masuk |
| Banyak pertanyaan sekaligus | Dinilai paralel pada 1 permintaan | Menambah token keluar untuk tiap jawaban |
| Waktu pada uji kami | Median 760 ms untuk 1 pertanyaan dari Jakarta | Bergantung panjang jawaban yang ditulis |
Perbedaan biaya inilah yang mengubah keputusan arsitektur. Penjaga seharga 0,00003 USD per giliran dapat dipasang pada tiap giliran. Penjaga yang berharga 100 kali lipat hanya dipasang pada giliran tertentu.
Beda keempat: keyakinan sebagai gerbang
LLM dapat diminta menyebut tingkat keyakinannya, tetapi angka itu ditulis sebagai teks dan tidak terkalibrasi.
Jev mengembalikan keyakinan sebagai kolom terpisah. TypeSafe mengukurnya pada kelompok jawaban, sehingga ambang Anda memiliki arti operasional. Sumber: halaman confidence TypeSafe.
Pada audit kami, tidak ada 1 pun skor tindak lanjut melewati 0,80. Karena itu seluruh aksi otomatis tertahan, dan antrean manusia yang memegang pekerjaannya. Tanpa kolom keyakinan, kami tidak akan pernah tahu itu.
Keduanya bekerja bersama, bukan bergantian
Pertanyaan yang benar bukan "mana yang lebih baik". Pertanyaan yang benar adalah "bagian mana yang dikerjakan siapa".
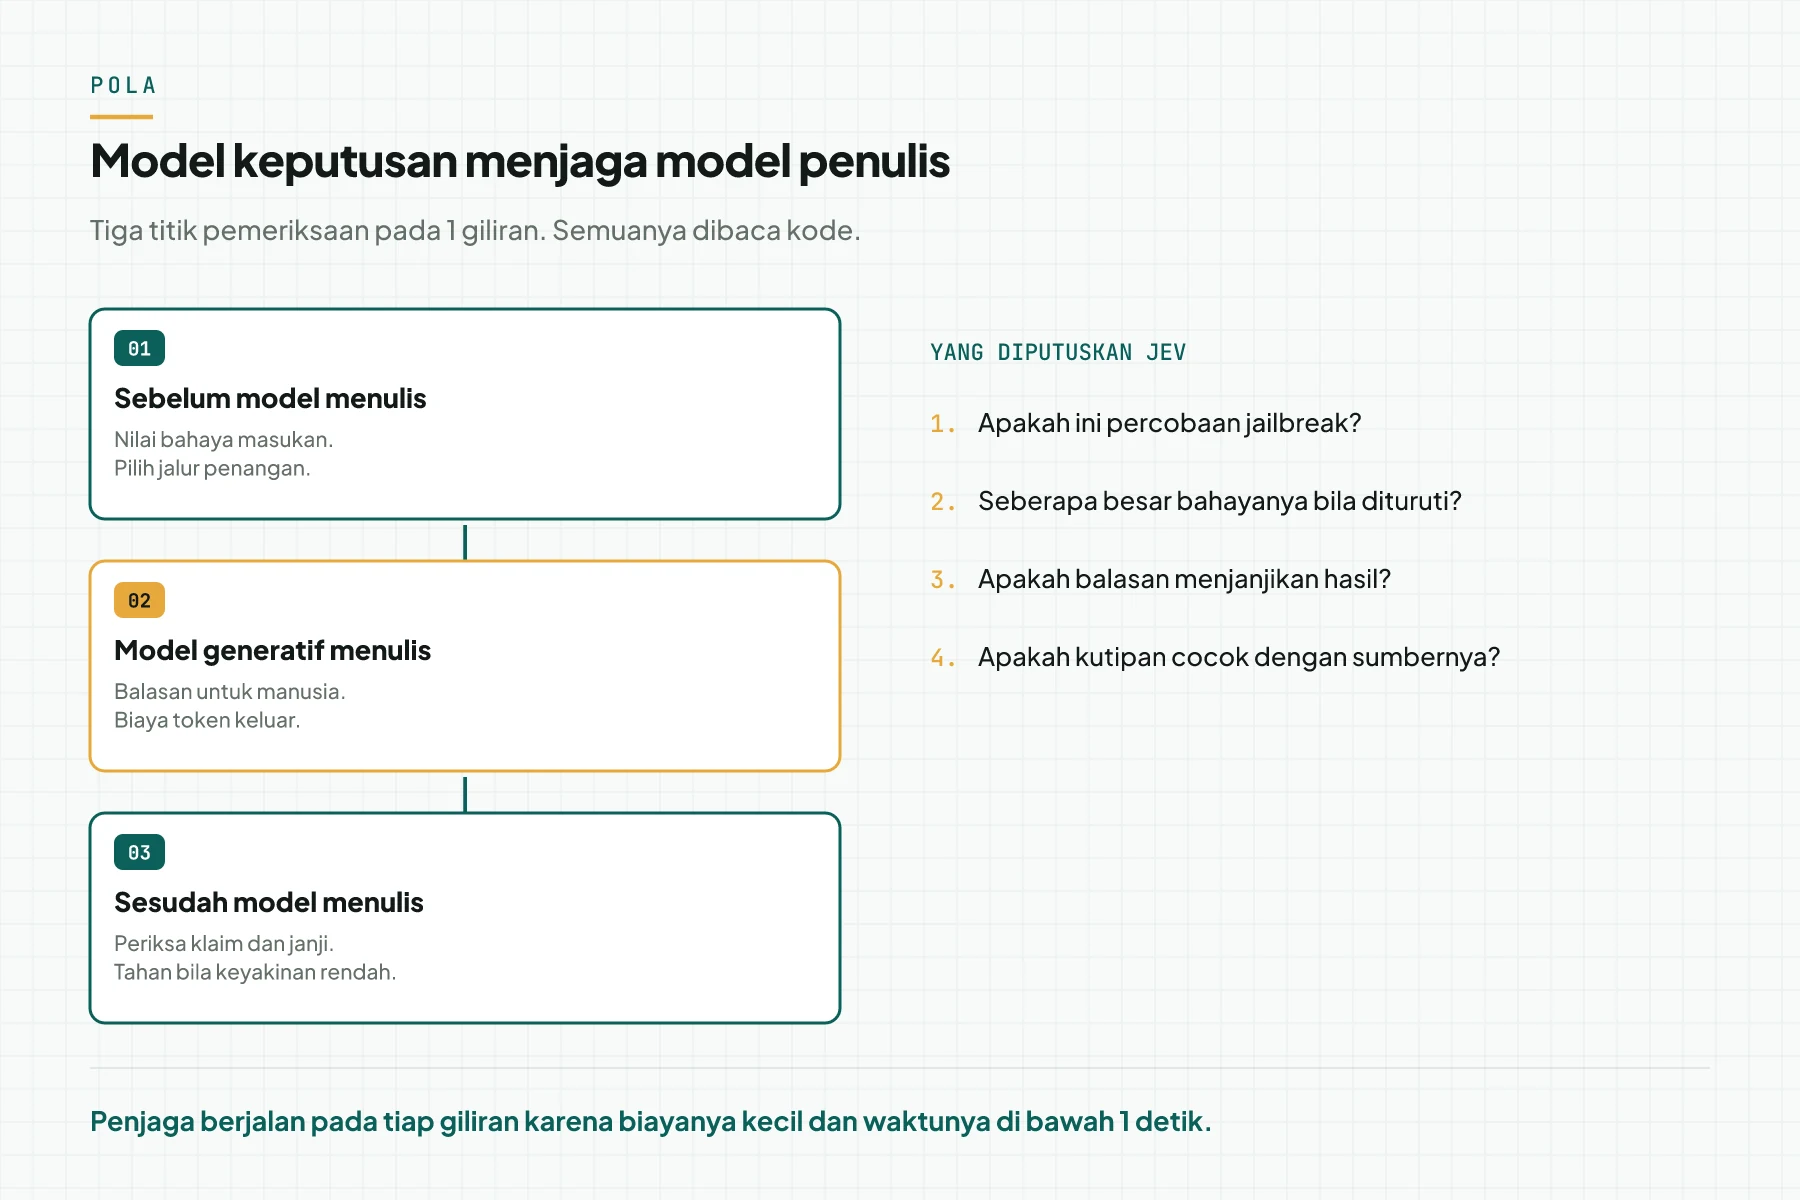
Pola ini disebut guardrail. Sebelum model menulis, 1 permintaan menilai bahaya masukan dan memilih jalur. Sesudah model menulis, 1 permintaan memeriksa klaim dan janji pada teksnya. Sumber: cookbook guardrail TypeSafe.
Pola kedua yang sering dipakai adalah pemilih jalur. Satu pertanyaan Choice memilih penangan: kode deterministik, LLM, atau manusia. Jalur murah menangani sebagian besar pesan, dan LLM hanya menangani yang berat. Sumber: pola intent routing.
Enam pertanyaan untuk memilih alat
- Apakah jawabannya dapat saya tulis sebagai daftar? Bila ya, model keputusan cocok.
- Apakah hasilnya dibaca manusia atau dibaca kode? Dibaca kode berarti model keputusan.
- Apakah keputusan ini berulang ribuan kali? Volume besar menguatkan model keputusan.
- Apakah saya butuh kalimat yang enak dibaca? Bila ya, Anda butuh model generatif.
- Apakah saya perlu tahu kapan harus ragu? Kolom keyakinan hanya ada pada model keputusan.
- Apakah jawabannya butuh hitungan? Bila ya, taruh hitungannya pada kode, bukan pada model mana pun.
Bila 3 jawaban pertama mengarah ke model keputusan, mulai dari sana. Anda dapat menambahkan model generatif belakangan tanpa membongkar alurnya.
Yang tidak dapat dikerjakan model keputusan
TypeSafe menerbitkan sendiri daftar sisi lemah jev-1.13, ditinjau 17 September 2026. Daftar itu menahan Anda dari pemakaian yang salah.
| Kebutuhan | Alat yang tepat |
|---|---|
| Menulis balasan, ringkasan, atau kode | Model generatif |
| Menghitung total, selisih, atau persentase | Kode biasa |
| Membandingkan 2 tanggal | Kode biasa, setelah komponennya diambil |
| Menghitung jumlah kemunculan kata | Kode biasa |
| Memilih 1 jalur dari daftar tertutup | Model keputusan |
Sumber: halaman jaggedness jev-1.13. Kami memakai daftar itu sebagai penyaring sebelum menulis rubrik.
Contoh nyata dari sistem kami
Asisten CRM kami memakai model generatif untuk menulis balasan. Model itu ramah dan informatif, dan tidak ada 1 angka pun yang memberi tahu apakah balasannya menjual.
Kami menilai 43 balasan dengan model keputusan. Hasilnya: 19 balasan memberi harga, 8 mendiagnosis, 6 mengedukasi, dan hanya 2 yang meminta order. Cerita lengkapnya ada pada panduan audit percakapan dengan Jev.
Rekomendasi Rama Digital: jangan mengganti model penulis Anda. Tambahkan lapisan keputusan di depan dan di belakangnya, lalu ukur perubahannya dengan rubrik yang sama.
Bagaimana perpindahan ini terlihat pada kode
Perbedaan terbesar bukan pada model, melainkan pada jumlah kode penjagaan yang hilang. Tiga hal berikut biasanya menghilang setelah keputusan dipindah ke model bertipe.
- Penjaga format. Tidak ada lagi pemeriksaan JSON rusak, tanda kutip bengkok, atau jawaban yang membawa penjelasan tambahan.
- Percobaan ulang. Tidak ada lagi panggilan kedua hanya karena jawaban pertama tidak dapat dibaca.
- Keranjang lainnya. Tidak ada lagi nilai asing yang harus ditampung karena model menjawab di luar daftar.
Yang menggantikannya adalah 1 pekerjaan baru: menulis rubrik. Pekerjaan itu berpindah dari kode ke bahasa, dan hasilnya dapat dibaca orang non teknis pada tim Anda.
Perpindahan ini juga mengubah cara tim berdebat. Perdebatan lama berbunyi "kenapa parsernya gagal". Perdebatan baru berbunyi "apakah opsi ini sudah kita definisikan dengan benar", dan pertanyaan kedua jauh lebih berguna.
Pertanyaan yang sering muncul
Apakah Jev lebih pintar daripada GPT atau Claude? Pertanyaannya tidak setara. Jev tidak menulis teks, jadi keduanya tidak mengerjakan tugas yang sama.
Apakah saya bisa memakai LLM untuk pekerjaan yang sama? Bisa, dan banyak tim melakukannya. Bedanya ada pada biaya, kecepatan, dan jumlah kode penjagaan yang harus Anda tulis.
Apakah model keputusan bisa halusinasi? Model tetap dapat memilih opsi yang salah. Bedanya, jawaban itu selalu berada di dalam daftar Anda, jadi sistem tidak menerima nilai yang tidak dikenal.
Mana yang lebih cepat? Pada uji kami, 1 pertanyaan Jev dari Jakarta selesai dalam median 760 milidetik. Model generatif bergantung panjang jawaban yang ditulis.
Apakah perlu mengganti arsitektur untuk mencoba? Tidak. Mulailah dari 1 panggilan tambahan pada 1 titik keputusan, lalu ukur hasilnya sebelum menambah titik lain.
Langkah berikutnya
Batas yang tersisa: memilih alat tidak menyelesaikan rubrik. Rubrik yang kabur menghasilkan keputusan yang kabur pada alat mana pun. Kami menulis kebiasaan menguji sistem sendiri pada Chaos engineering untuk vibe coder.
Bila Anda ingin kami memetakan bagian mana yang layak diserahkan ke mesin, buka AI Diagnostic. Untuk membahasnya lebih dulu, pilih jadwal sesi AI Diagnostic.