Jawaban langsung: Chaos engineering adalah disiplin bereksperimen pada sistem, untuk membangun keyakinan bahwa sistem tahan kondisi bergolak di produksi (Principles of Chaos Engineering, diperbarui Maret 2019). Untuk vibe coder, pakai pola 1 + 6. Agent AIAgent AIProgram AI yang mengerjakan langkah pekerjaan sendiri, misalnya membaca pesan, menyiapkan balasan, lalu mencatat hasilnya.Buka glosarium membangun fitur Hari 1. Hari 2-7 memetakan kegagalan, menyuntik kegagalan dependensi, data, dan beban, memasang observability, menguji keamanan dengan workflow multi-agent, dan menutup dengan game day.
Kondisi utama: berlaku untuk fitur dengan dependensi luar (APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium, webhookWebhookPesan otomatis yang sebuah sistem kirim ke sistem lain tepat saat sesuatu terjadi, misalnya pesan WhatsApp masuk.Buka glosarium, database, antrean), staging atau feature flag, backup teruji, dan 3 metrik dasar. Eksperimen di produksi hanya berjalan dengan blast radius kecil, aturan stop, dan izin pemilik sistem. Batas: chaos engineering tidak menggantikan unit test, integration test, atau pentest. Hasilnya keyakinan terukur pada 1 fitur, bukan jaminan bebas insiden; premis "7 hari jadi 1 hari" adalah skenario pembaca, bukan data.
Sumber dibaca 14 September 2026: principlesofchaos.org, Netflix, AWS, Azure, DORA, dan METR. Contoh adalah simulasi data dummy; tidak ada eksperimen yang dijalankan untuk artikel ini.
Ringkasan 30 detik
- Premis "7 hari jadi 1 hari" adalah skenario pembaca. DORA 2024: tiap kenaikan adopsi AI 25% berkaitan dengan perkiraan penurunan throughput 1,5% dan stabilitas 7,2% (DORA 2024, lebih dari 39.000 responden).
- METR, 10 Juli 2025: 16 developer 19% lebih lambat dengan alat AI, padahal mengira 20% lebih cepat (metr.org).
- Stack Overflow 2025: 84% memakai alat AI, tetapi 46% tidak percaya akurasinya (survey.stackoverflow.co).
- Chaos engineering memakai 4 langkah dan 5 prinsip (principlesofchaos.org, 2019); Netflix memulainya 2011, Google DiRT tiap tahun (ACM Queue, 2012).
- Alat gratis: Toxiproxy (GitHub), Chaos Mesh (CNCF) dan LitmusChaos (CNCF); Claude Code menjalankan sampai 16 agent serentak (code.claude.com).
Fitur jadi dalam 1 hari: 6 hari sisanya untuk chaos engineering
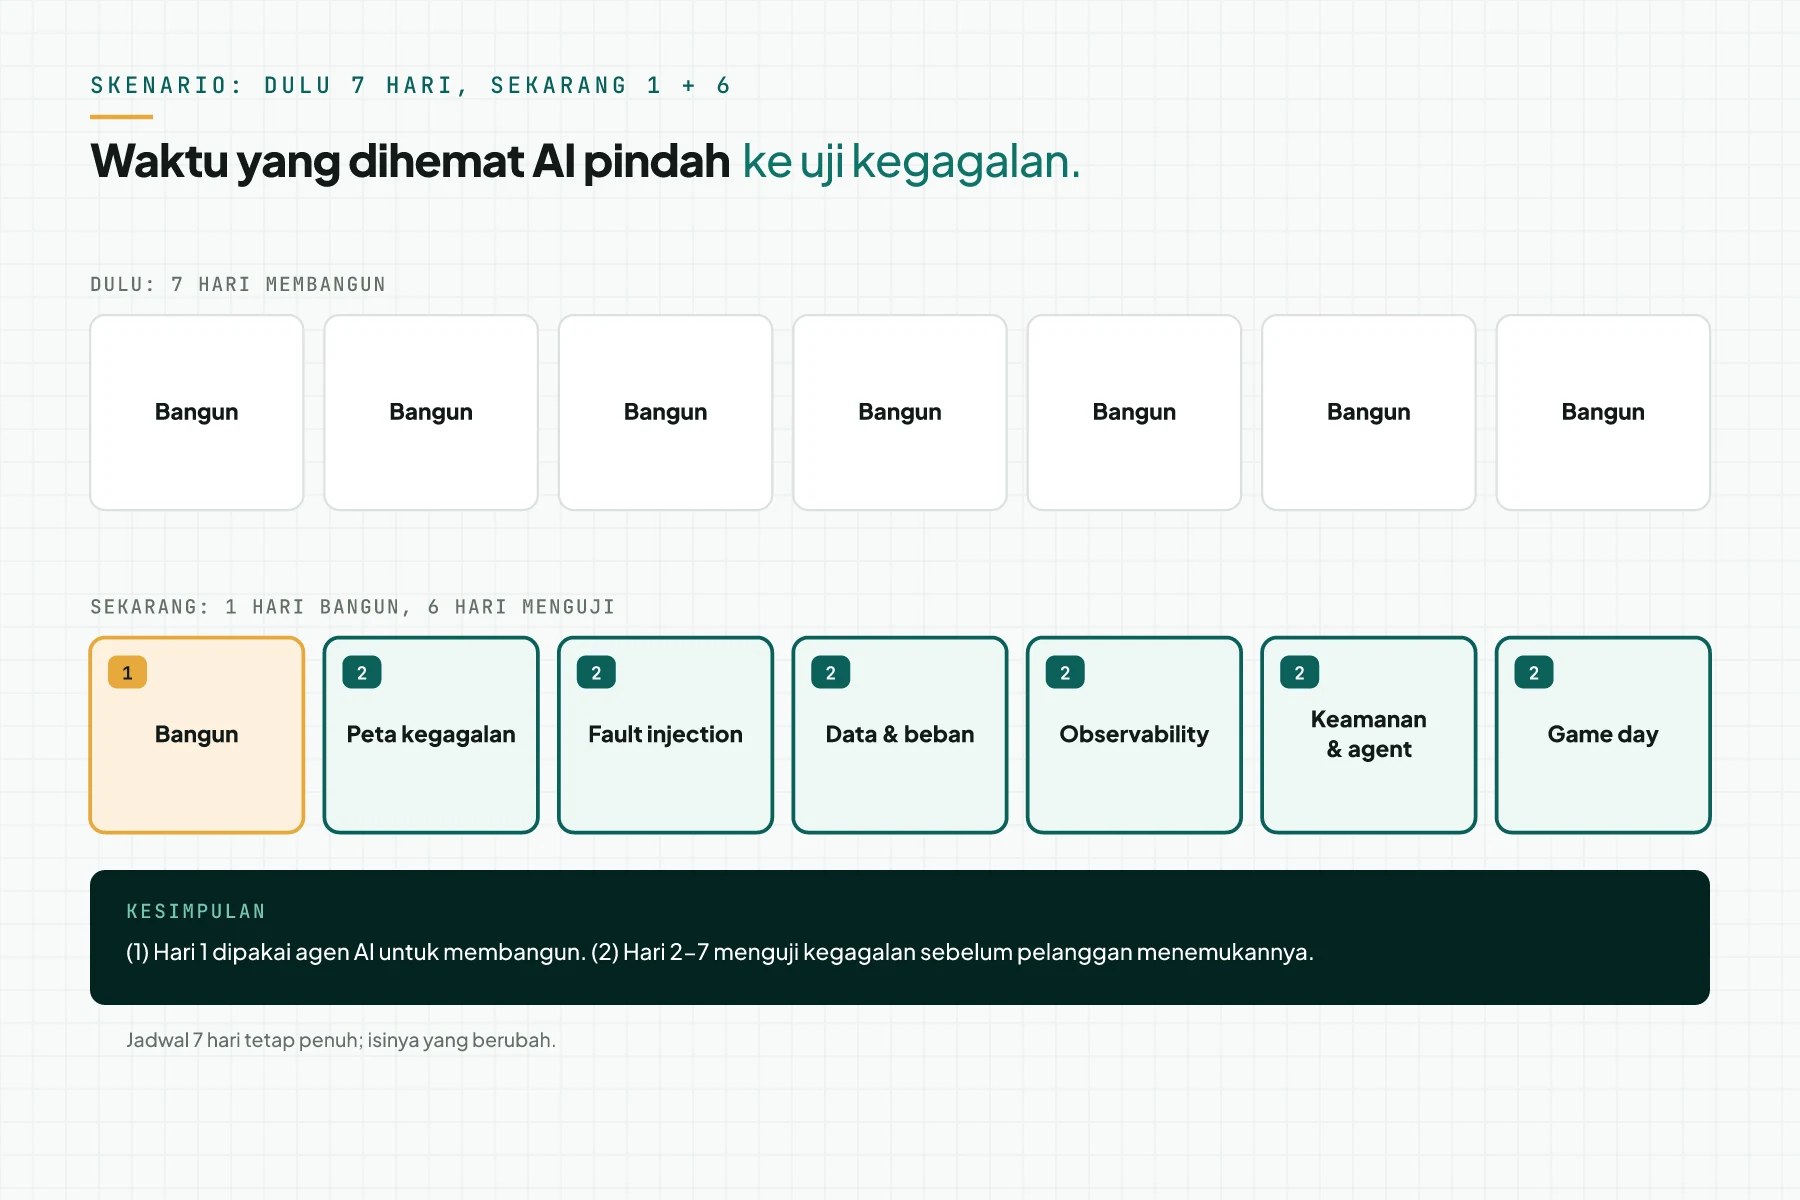
Anggap sebuah fitur yang dulu perlu 7 hari kini selesai 1 hari, dibangun oleh agent AI seperti Claude Code, Codex, OpenClaw, atau Hermes. Ini skenario pembaca, bukan data terukur. Sesudahnya, tim sering santai atau lompat ke fitur berikutnya; keduanya menumpuk fitur yang belum gagal terkendali.
Cara kerja ini disebut vibe coding: menulis kode agak longgar, dibantu AI (Merriam-Webster, diperbarui 4 Juni 2026), istilah dari Andrej Karpathy pada 2025. "Vibe coder" di sini adalah sebutan netral.
DORA 2024: 75,9% mengandalkan AI harian; adopsi naik 25% berkaitan dengan throughput turun 1,5% dan stabilitas turun 7,2% (DORA 2024). DORA 2025: 90% memakai AI, lebih dari 80% merasa lebih produktif. Namun stabilitas tetap turun (Google Cloud, 24 September 2025): "AI doesn't fix a team; it amplifies what's already there."
METR: 16 developer berpengalaman 19% lebih lambat pada 246 tugas nyata, padahal sesudah studi masih mengira 20% lebih cepat (METR, 10 Juli 2025). Stack Overflow 2025: 84% memakai alat AI, namun 46% tidak percaya akurasinya dan 66% frustrasi dengan solusi "hampir benar, tapi tidak tepat" (Stack Overflow 2025).
Kesimpulannya: waktu yang dihemat AI paling masuk akal dipakai membuat fitur gagal secara sengaja, sebelum pelanggan menemukannya. Hari 1 yang rapi memakai pola workflow Spec ke Task ke Checklist; baca RED dalam TDD sebab test hijau belum membuktikan fitur benar.
Apa itu chaos engineering: definisi, 5 prinsip, dan sejarahnya
Chaos engineering memakai 4 langkah: tetapkan steady state, buat hipotesis, suntik variabel dunia nyata, lalu bantah hipotesis itu (principlesofchaos.org, diperbarui Maret 2019). Gremlin menyebutnya cara menemukan kegagalan sebelum jadi gangguan layanan, klaim vendor 2023 (Gremlin).
Prinsip 1: bangun hipotesis di sekitar steady state
Steady state memakai output terukur, bukan atribut internal; Netflix memakai SPS, stream start per detik (Basiri, IEEE Software 2016), dan AWS memberi template hipotesis berbasis fault dan metrik (AWS REL12-BP04).
Prinsip 2: variasikan kejadian dunia nyata
Prioritaskan variabel berdasar dampak atau frekuensi, bukan tebakan (principlesofchaos.org); AWS memilih fault dari analisis pasca-insiden (AWS REL12-BP04).
Prinsip 3: jalankan di produksi
Chaos engineering menyukai produksi, tetapi AWS menyarankan non-produksi dulu (AWS REL12-BP04); Gremlin mencatat 34% bereksperimen di produksi, klaim vendor 2021 (Gremlin 2021).
Prinsip 4: otomatiskan agar berjalan terus
Eksperimen manual tidak bertahan lama; Netflix menjalankan Chaos Monkey tiap hari kerja (Basiri dan tim, 2016).
Prinsip 5: minimalkan blast radius
Blast radius adalah bagian sistem yang terdampak; magnitude adalah separah apa eksperimen itu (glosarium Gremlin); AWS FIS membatasi 5 aturan stop per template (AWS FIS).
Sejarah singkat: Netflix 2011, Google 2012, dan IEEE 2016
Netflix menulis soal Chaos Monkey 19 Juli 2011 (Netflix Tech Blog), open source sejak 2012, kini wajib Spinnaker (repo GitHub). Google DiRT mulai kecil (Krishnan 2012); Basiri dan tim menamai disiplin ini pada 2016 (IEEE Software 2016).
Peta 6 hari: di mana tiap prinsip dipakai
Hari 2 memakai Prinsip 1-2; Hari 3-4 memakai Prinsip 2 dan 5; Hari 5 observability untuk Prinsip 1. Hari 6 memakai Prinsip 4 lewat agent; Hari 7 game day.
Unit test, integration test, chaos experiment, game day, dan pentest: apa bedanya
Kelima jenis uji ini saling melengkapi. Chaos experiment menguji perilaku sistem saat 1 komponen gagal, bukan kebenaran fungsi (principlesofchaos.org; glosarium Gremlin; AWS REL12-BP05).
| Jenis uji | Tujuan | Kapan | Blast radius | Alat |
|---|---|---|---|---|
| Unit test | Fungsi benar untuk input diketahui. | Hari 1, tiap commit. | Tidak ada. | Vitest, Jest, pytest. |
| Integration test | Komponen bekerja bersama pada jalur normal. | Hari 1, tiap PR. | Tidak ada; staging. | Test runner, database uji. |
| Chaos experiment | Bantah hipotesis steady state saat 1 dependensi gagal. | Hari 2-6, lalu berkala. | Kecil; staging dulu, produksi dengan aturan stop. | Toxiproxy, Chaos Mesh, LitmusChaos, AWS FIS, Azure Chaos Studio. |
| Game day | Latih tim dan runbook pada beberapa kegagalan. | Hari 7, lalu berkala. | Sedang; mirip produksi. | Alat chaos yang sama, ditambah runbook. |
| Pentest | Temukan celah keamanan yang bisa dieksploitasi. | Sebelum rilis, sesudah ubah auth. | Terbatas pada cakupan disetujui. | Metodologi OWASP API Top 10. |
Rekomendasi Rama Digital: unit test dan RED dalam TDD Hari 1. Chaos experiment Hari 2-6, game day Hari 7, dan pentest API aplikasi modern sebelum rilis publik (OWASP API Top 10 2023).
Prasyarat sebelum Hari 2
Siapkan 8 hal ini sebelum mulai menyuntik kegagalan.
- 3 metrik dasar dalam 1 dashboard: latensi, traffic, error rate, dari 4 golden signals SRE (Google SRE Book).
- Staging mirip produksi, atau feature flag yang mematikan fitur dalam 1 menit.
- Backup yang pernah di-restore, bukan hanya dijadwalkan (Krishnan 2012).
- Izin tertulis pemilik sistem dan pemberitahuan ke tim terdampak (AWS REL12-BP05).
- 1 akun uji dan data dummy; tanpa data pelanggan di staging.
- 1 fitur target dengan daftar dependensi: webhook, API, database, layanan PDF, antrean.
- Alat fault injection: Toxiproxy (v2.12.0); Chaos Mesh atau LitmusChaos di Kubernetes (CNCF; CNCF); AWS FIS atau Azure Chaos Studio di cloud itu (dokumentasi; dokumentasi).
- Aturan stop, misalnya error rate di atas 5% selama 2 menit.
Langkah 1: Hari 2 — Petakan mode kegagalan dan tetapkan steady state
Langkah ini menetapkan angka normal fitur, lalu memetakan cara fitur bisa gagal. Steady state contoh: 120 pesan per jam, p95 4 detik, error di bawah 1% (simulasi). Buat tabel mode kegagalan, 1 baris per dependensi dan fault; kembangkan ke 10 baris atau lebih.
| Dependensi | Jenis fault | Prioritas | Hipotesis |
|---|---|---|---|
| Webhook Meta | Duplikat | Tinggi | 1 pesanan tetap 1 invoice. |
| Database | Mati 30 detik | Tinggi | Pesan tersimpan di antrean, tidak hilang. |
| Token WhatsApp | Kedaluwarsa | Tinggi | Alert 5 menit; tidak ada invoice ganda. |
Tulis 1 hipotesis yang bisa dibantah per baris, template AWS (AWS REL12-BP04). Minta agent AI membaca kode dan mengeluarkan daftar ini terstruktur (Claude Code Workflows); manusia memberi prioritas akhir. Siklus berulang sampai Hari 6 (principlesofchaos.org).
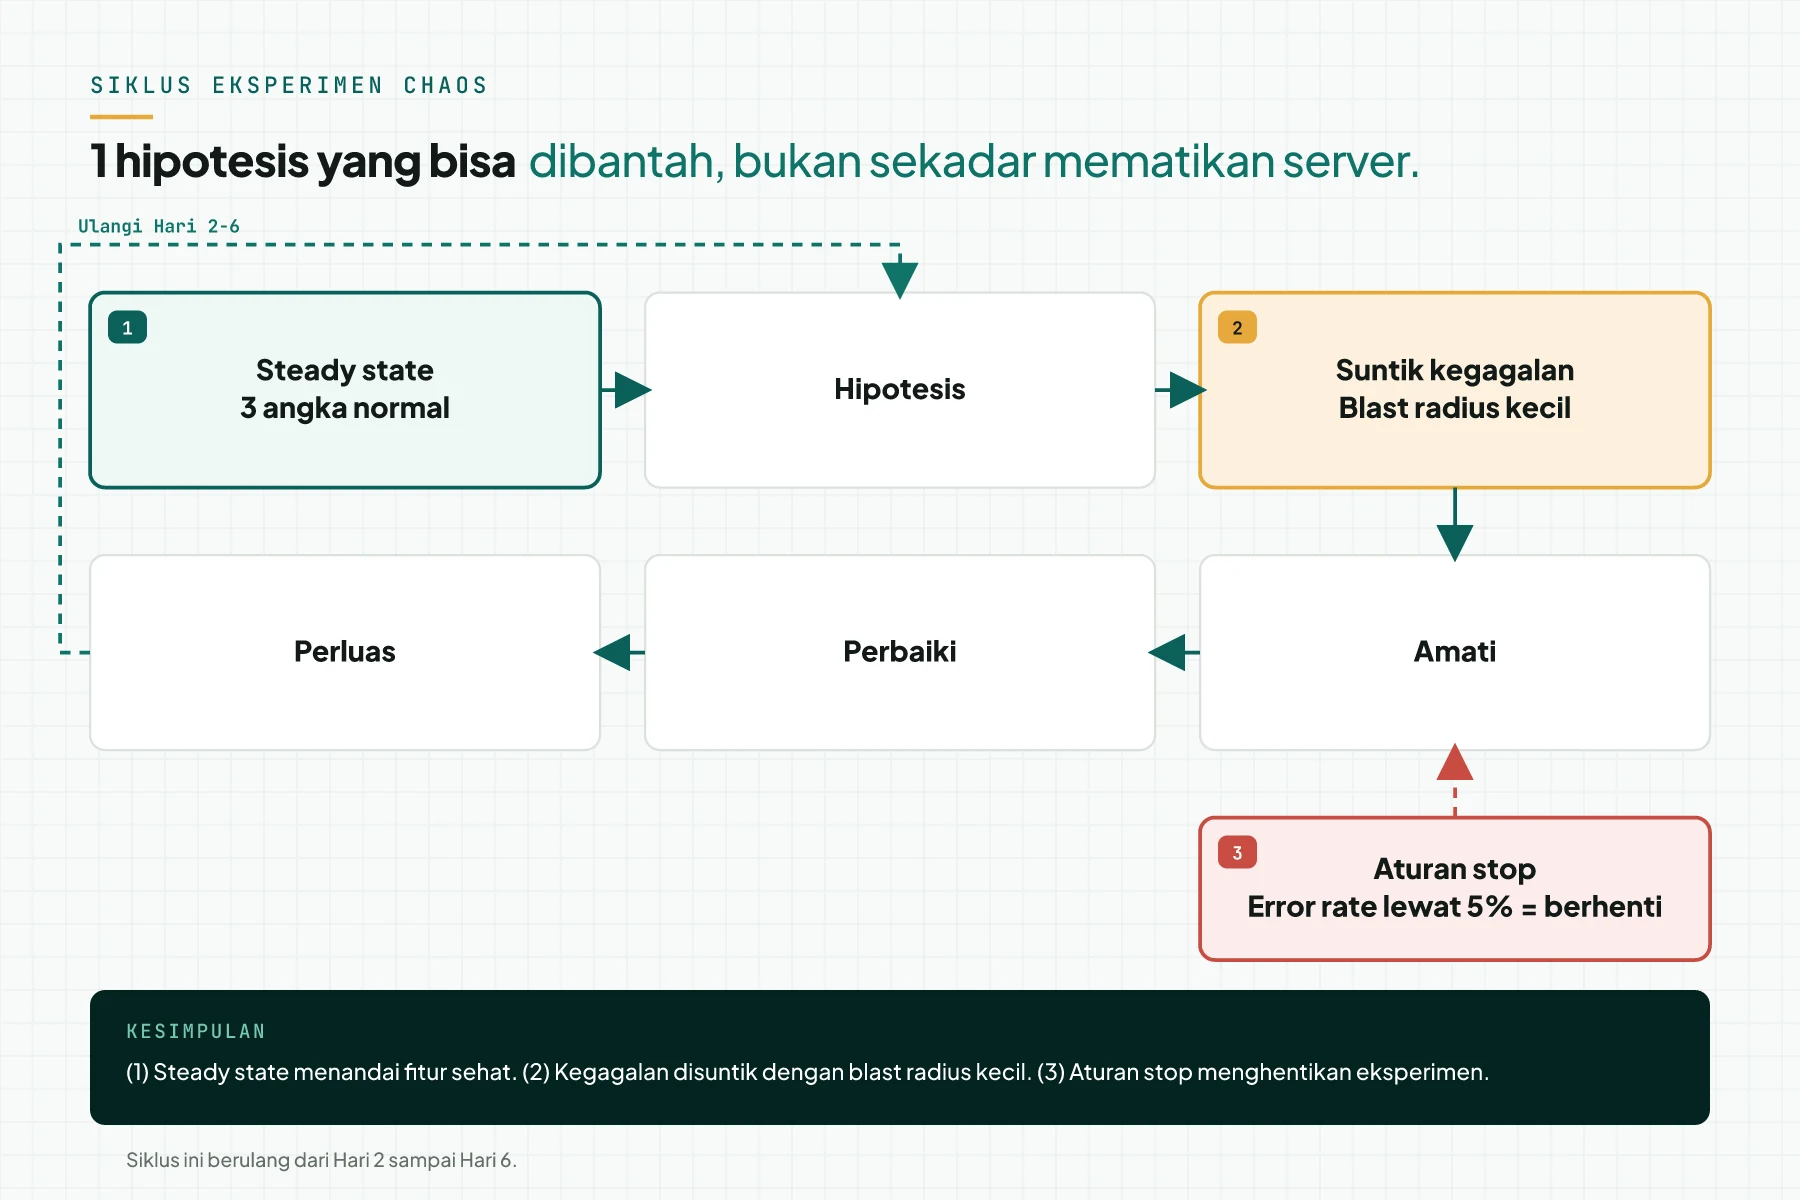
Verifikasi: dashboard menampilkan 3 metrik steady state 1 jam normal, tiap baris hipotesis punya metrik diamati.
Langkah 2: Hari 3 — Suntik kegagalan dependensi: latensi, timeout, 500, dan database mati
Langkah ini menyuntik 1 kegagalan pada 1 dependensi dengan blast radius terkecil, di staging, dengan aturan stop yang sudah siap.
Toxiproxy mengarahkan koneksi lewat proxy; tambahkan toxic latency, lalu timeout, lalu down (Toxiproxy v2.12.0, 18 Maret 2025). Di Kubernetes pakai NetworkChaos Chaos Mesh (Chaos Mesh); di cloud pakai AWS FIS (AWS FIS), atau Azure Chaos Studio klasik, karena Workspaces masih public preview (Azure Chaos Studio, 5 September 2026).
Amati timeout, fallback, antrean, dan log dengan ID request. Kode buatan AI sering tanpa timeout, atau retry tanpa backoff; retry gagal memakai lebih banyak waktu server saat overload (Marc Brooker, AWS).
Perbaikan: timeout eksplisit, backoff dengan jitter, fallback sederhana, dan pesan jelas ke pengguna. Verifikasi: ulangi eksperimen sesudah perbaikan; hipotesis harus bertahan.
Langkah 3: Hari 4 — Rusak data dan beban: input rusak, payload besar, lonjakan, dan duplikat
Langkah ini menguji fitur dengan data rusak dan beban di luar kebiasaan. Kirim payload dengan field hilang, tipe salah, atau 2 MB; fitur harus menjawab 400 jelas, bukan 500 bocor stack trace.
Kirim webhook sama 2 kali, karena Meta mengulang sampai 36 jam (Meta Webhooks); perbaikan memakai idempotency key, pola Stripe (Stripe API). Matikan 1 dependensi 30 detik lalu hidupkan; amati retry serentak, perbaiki dengan backoff. Kirim traffic 10 kali normal 5 menit; amati saturation (Google SRE Book).
1 agent membuat generator payload rusak; agent lain menulis test yang gagal lebih dulu, pola RED dalam TDD, sebelum perbaikan. Verifikasi: test masuk suite otomatis, lulus.
Langkah 4: Hari 5 — Pasang observability, alert, runbook, dan latih rollback
Langkah ini memasang cara melihat kegagalan, lalu melatih tim memulihkannya. Pasang 4 golden signals: latensi, traffic, error rate, saturation (Google SRE Book); minimal 1 dashboard, 1 log dengan ID request, dan alert error rate serta p95.
Runbook adalah proses terdokumentasi untuk 1 hasil tertentu (AWS OPS07-BP03): tujuan, alat, izin, langkah, dan eskalasi, disimpan di repo dan divalidasi orang lain.
Latih rollback: deploy versi rusak ke staging, jalankan runbook, catat waktunya. Agent menulis draf runbook; manusia memvalidasinya. Pakai /loop untuk memantau alert selama eksperimen berjalan.
Verifikasi: alert berbunyi saat uji, rollback selesai orang lain dengan waktu tercatat.
Langkah 5: Hari 6 — Uji kegagalan izin dan keamanan dengan workflow multi-agent
Langkah ini menyuntik kegagalan izin dan keamanan, lalu memverifikasinya dengan banyak agent. Fault: token kedaluwarsa senyap, rate limit 429, webhook tanpa tanda tangan, secret dirotasi, berbasis OWASP API2 dan API4 (OWASP API Top 10 2023). Meta mewajibkan tanda tangan X-Hub-Signature-256 lewat App Secret (Meta Webhooks).
Contoh hipotesis: "Jika token WhatsApp kedaluwarsa, fitur menandai pesan gagal, memberi alert dalam 5 menit, dan tidak membuat invoice ganda saat token diperbarui."
Pola multi-agent memakai orchestrator-workers dan evaluator-optimizer (Anthropic, Building Effective Agents). Susunannya: 1 orkestrator, 1 agent hipotesis, dan 3 agent perusak paralel (dependensi; data dan beban; izin dan keamanan), hanya di staging. Lalu 1 agent verifikasi mencoba membantah tiap temuan dan menguji perbaikannya. Ulangi sampai 2 putaran kosong.
Subagent Claude Code berkonteks sendiri, hanya mengembalikan ringkasan (Claude Code Subagents); tools dan isolation: worktree membatasi tiap agent; agent() dan parallel() menjalankannya, maksimal 16 agent serentak (Claude Code Workflows).
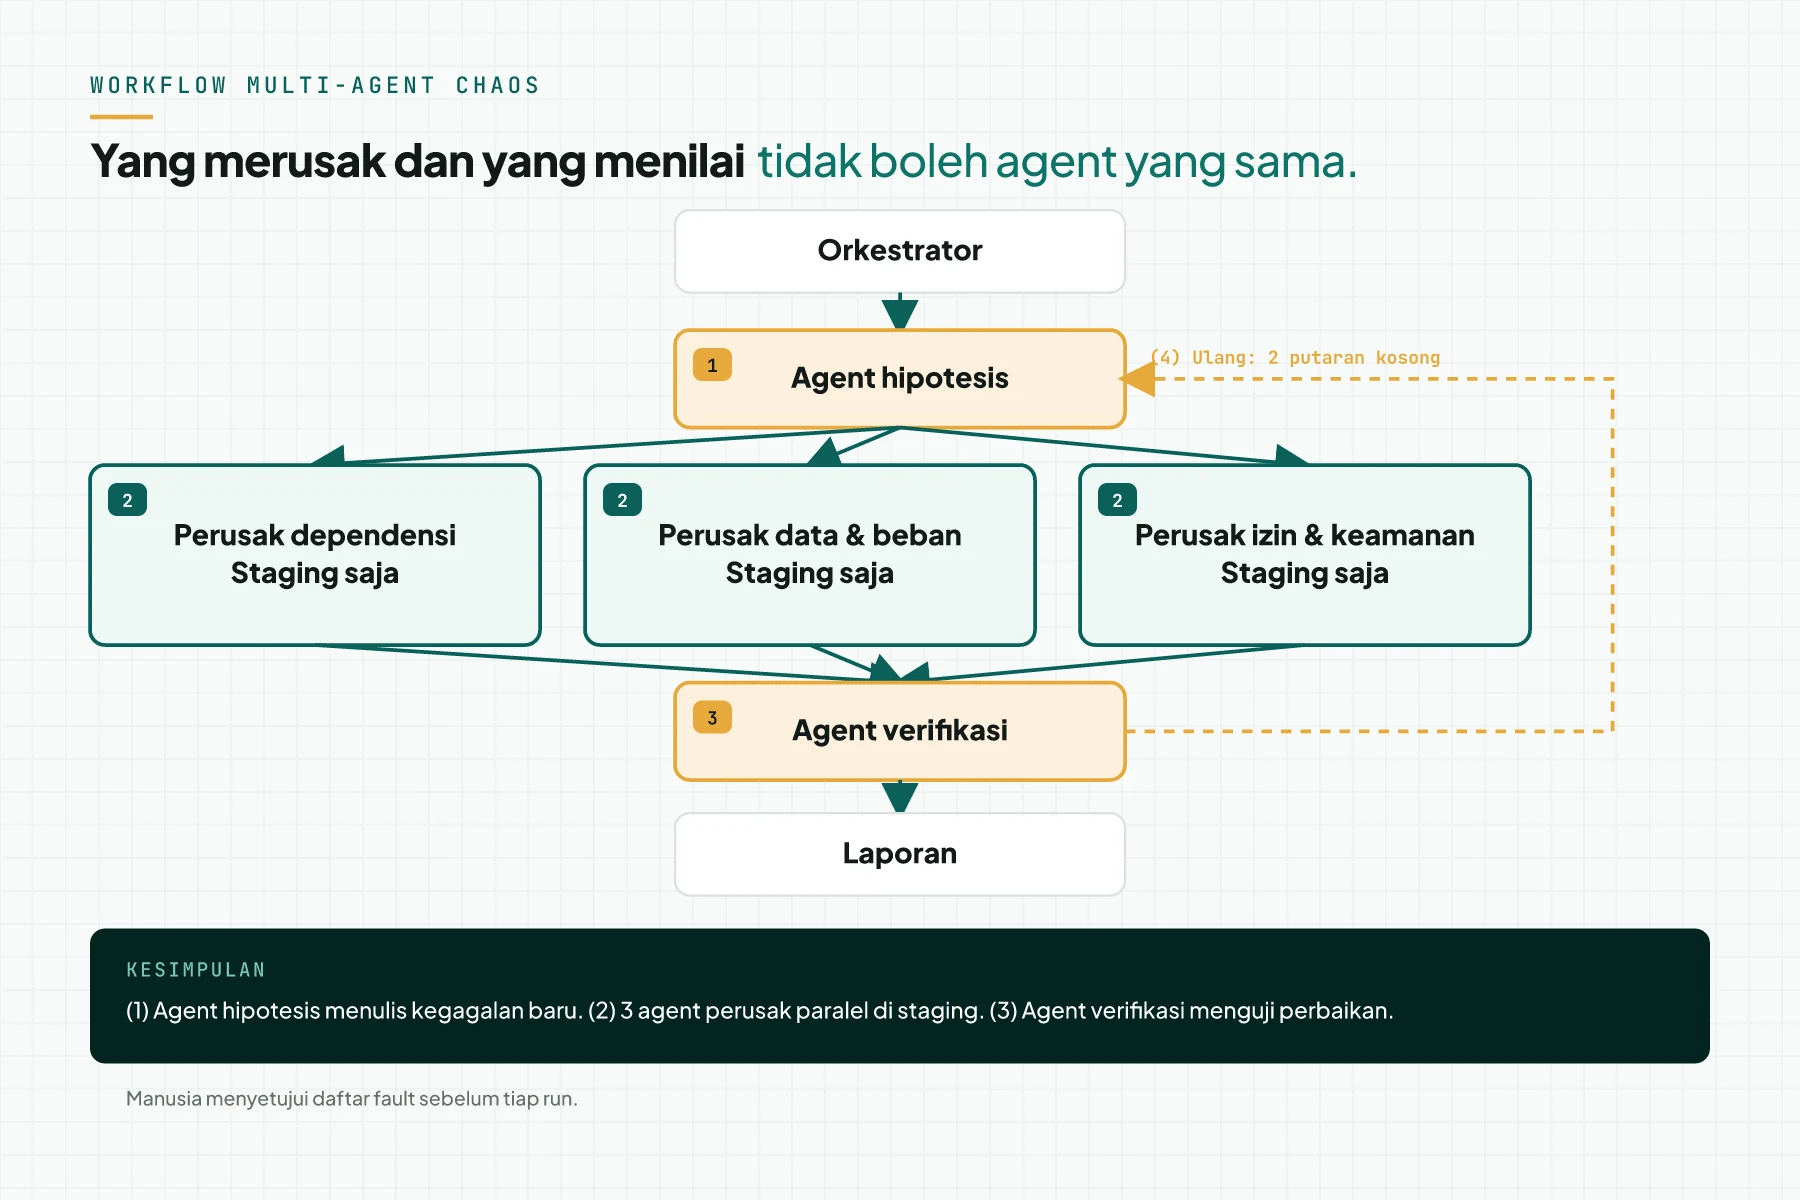
Sketsa:
phase('Chaos Hari 6');
let empty = 0;
while (empty < 2) {
  const hipotesis = await agent(promptHipotesis);
  const temuan = await parallel([
    agent(promptDependensi(hipotesis)),
    agent(promptData(hipotesis)),
    agent(promptIzin(hipotesis)),
  ]);
  const v = await agent(promptVerifikasi(temuan), { schema });
  empty = v.temuanBaru === 0 ? empty + 1 : 0;
}
Aturan aman: agent perusak tanpa kredensial produksi, semua fault lewat staging, agent verifikasi terpisah, dan manusia menyetujui daftar fault. Baca juga agent yang agentic tetapi deterministic, pola Claude Code Workflows, dan ukuran default dan rem Claude Code 2.1.219. Azure Chaos Studio menambah plugin startchaos sebagai server MCPMCPAturan standar yang memungkinkan program AI memakai alat dan data Anda dengan izin yang jelas.Buka glosarium untuk agent otonom (Azure Chaos Studio, 5 September 2026), tanda arah industri.
Verifikasi: temuan per putaran turun ke 0 dua kali berturut, tiap temuan punya test gagal lalu lulus; webhook palsu ditolak 401 atau 403.
Langkah 6: Hari 7 — Jalankan game day, retro, dan laporan
Langkah ini menutup 6 hari uji dengan latihan bersama dan laporan tertulis. Game day biasanya 2-4 jam untuk 1 eksperimen atau lebih, klaim vendor (Gremlin, How to Run a GameDay), di lingkungan mirip produksi dengan stakeholder diberi tahu di muka (AWS REL12-BP05).
Gremlin memberi 4 peran: Owner, Coordinator, Reporter, Observer; tim 2 orang bisa menggabungkan peran. Agenda 2 jam memakai 3 skenario Hari 2 yang belum pernah dijalankan bersamaan.
Tutup dengan retro blameless: dampak, tindakan, penyebab, tindak lanjut, tanpa menuding orang (Google SRE Book, Postmortem Culture). Tulis laporan 1 halaman: steady state, eksperimen, temuan, dan jadwal berikutnya.
Verifikasi: laporan tersimpan di repo, tiap temuan punya tiket, dan eksperimen yang lulus terjadwal ulang otomatis (principlesofchaos.org).
Contoh simulasi: fitur pesanan WhatsApp ke invoice, Hari 1 sampai 7
Simulasi dengan data dummy. Bukan klien nyata.
Fitur contoh: webhook WhatsApp Meta, parse pesan, buat pesanan dan PDF invoice, kirim balik. Dependensi: database, layanan PDF, API dummy "PayDummy", antrean. Steady state: 120 pesan per jam, p95 4 detik, error di bawah 1%.
| Hari | Eksperimen | Hipotesis | Hasil | Perbaikan |
|---|---|---|---|---|
| Hari 1 | Agent AI membangun fitur; test hijau. | — | Jalur normal berjalan. | Belum ada. |
| Hari 2 | Peta 12 mode kegagalan, 3 metrik. | Semua mode punya metrik. | Tabel 12 baris, 4 prioritas tinggi. | Belum ada; daftar disetujui. |
| Hari 3 | Toxiproxy latency 3.000 ms ke PDF. | Balasan di bawah 10 detik, fallback. | Menggantung 60 detik; antrean 40 pesan. | Timeout 5 detik dan fallback. |
| Hari 3 | Toxiproxy down pada database, 30 detik. | Pesan tersimpan di antrean. | Pesan hilang tanpa log. | Simpan event mentah; log ID. |
| Hari 4 | Webhook sama 2 kali, Meta mengulang 36 jam. | 1 pesanan tetap 1 invoice. | 2 invoice untuk 1 pesanan. | Idempotency key = ID pesan. |
| Hari 4 | Payload 2 MB, field harga "abc". | Ditolak 400 jelas. | 500 dengan stack trace. | Batas body 64 KB, validasi skema. |
| Hari 5 | Ulangi latency 3.000 ms, amati alert. | Alert dalam 3 menit. | Alert tidak ada; dashboard hanya CPU. | 4 golden signals, alert p95. |
| Hari 5 | Latihan rollback oleh orang kedua. | Rollback dalam 10 menit. | Selesai 14 menit; 1 perintah usang. | Runbook diperbarui, target 8 menit. |
| Hari 6 | Multi-agent: token kedaluwarsa, 429, webhook tanpa tanda tangan. | Ditolak atau diberi alert; tanpa invoice ganda. | Putaran 1: 5 temuan; putaran 2: 2; 3-4: 0. | Verifikasi tanda tangan; backoff untuk 429. |
| Hari 7 | Game day: replica mati, lonjakan 10 kali, token kedaluwarsa. | Steady state bertahan; runbook dipakai. | 1 temuan baru: dashboard gagal saat replica mati. | Dashboard baca sumber terpisah; retro dan laporan. |
Total 14 temuan dalam 6 hari: 6 dari Hari 3-5, 7 dari workflow multi-agent, dan 1 dari game day, semuanya sebelum pelanggan pertama.
Checklist chaos engineering untuk fitur baru
- Tulis steady state dalam 3 angka. Pemilik: developer. Bukti: screenshot dashboard 1 jam normal.
- Buat tabel 10 mode kegagalan atau lebih, dengan prioritas. Pemilik: developer. Bukti: tabel di repo.
- Jalankan 1 eksperimen dependensi di staging, dengan aturan stop. Pemilik: developer. Bukti: log eksperimen.
- Uji webhook duplikat dan payload rusak; buktikan idempotency. Pemilik: developer. Bukti: test gagal, lalu lulus.
- Pastikan alert error rate dan p95 berbunyi saat fault disuntik. Pemilik: on-call. Bukti: notifikasi tercatat.
- Minta orang kedua menjalankan runbook rollback, catat waktunya. Pemilik: on-call. Bukti: waktu di runbook.
- Jalankan workflow multi-agent, agent perusak dan verifikasi terpisah, hanya staging. Pemilik: developer. Bukti: laporan per putaran.
- Jalankan game day 2 jam, retro blameless, laporan 1 halaman. Pemilik: tim. Bukti: laporan dengan tiket tindak lanjut.
- Berhenti bila 2 putaran berturut kosong dan semua alert berbunyi. Jadwalkan eksperimen lulus sebagai regression test, lalu lanjut ke fitur berikutnya.
FAQ chaos engineering untuk vibe coder
Apa itu chaos engineering? Disiplin bereksperimen pada sistem untuk membangun keyakinan sistem tahan kondisi bergolak (principlesofchaos.org). Netflix memulainya 2011 (Netflix Tech Blog), makalah Basiri menamainya 2016 (IEEE Software).
Apakah chaos engineering harus dijalankan di produksi? Tidak wajib; AWS menyarankan non-produksi dulu (AWS REL12-BP04), meski Gremlin mencatat 34% bereksperimen di produksi, klaim vendor (Gremlin 2021).
Apa bedanya chaos engineering dengan unit test dan pentest? Unit test membuktikan fungsi benar; pentest mencari celah dieksploitasi (OWASP API Security Top 10); chaos experiment membantah hipotesis steady state.
Bisakah vibe coder tanpa tim SRE mulai chaos engineering? Bisa, dengan 1 fitur, staging, Toxiproxy, 3 metrik, dan 1 aturan stop, seperti DiRT yang mulai kecil (Krishnan 2012).
Alat chaos engineering apa yang gratis? Toxiproxy (GitHub), Chaos Mesh, dan LitmusChaos, CNCF incubating (CNCF; CNCF); AWS FIS berbayar per menit (dokumentasi), Azure Chaos Studio Workspaces masih preview (dokumentasi).
Bagaimana agent AI membantu tanpa merusak produksi? Agent perusak dibatasi tool tanpa kredensial produksi (Claude Code Subagents); agent verifikasi terpisah, pola orchestrator-workers (Anthropic), lewat workflow (Claude Code Workflows).
Langkah berikutnya
Chaos engineering tidak menggantikan unit test, integration test, atau pentest. Hasilnya keyakinan terukur pada 1 fitur, bukan jaminan bebas insiden. Bila tim Anda ingin mulai tanpa menebak sendiri, pakai layanan Vibe Code Rescue: audit forensik Rp 7,5 jt dalam 1-2 minggu. Laporan audit menentukan rescue mulai Rp 25 juta, atau rebuild mulai Rp 40 juta. Bila Anda ingin bertanya dulu, jadwalkan sesi 30 menit.
Sumber
- principlesofchaos.org
- Gremlin: Glosarium
- Gremlin: History
- Gremlin: GameDay
- Gremlin 2021
- AWS: REL12-BP04
- AWS: REL12-BP05
- AWS: OPS07-BP03
- AWS FIS
- AWS Builder: Backoff
- Azure Chaos Studio
- Netflix: Simian Army
- GitHub: chaosmonkey
- Basiri 2016
- Krishnan 2012
- CNCF: LitmusChaos
- CNCF: Chaos Mesh
- Chaos Mesh: Network
- GitHub: Toxiproxy
- SRE Book: Monitoring
- SRE Book: Postmortem
- Stripe: Idempotency
- Meta: Webhooks
- OWASP API Top 10 2023
- DORA 2024
- DORA 2025
- METR 2025
- Stack Overflow 2025
- Merriam-Webster
- Anthropic: Effective Agents
- Claude Code: Subagents
- Claude Code: Workflows