Jawaban langsung: Jev adalah model keputusan dari TypeSafe. Model ini membaca 1 state lalu menjawab pertanyaan bertipe: Noul untuk ya atau tidak, Choice untuk memilih 1 opsi, dan Score untuk menilai pada tangga yang Anda tulis. Jev tidak menulis teks dan tidak menjelaskan alasannya, jadi kode Anda yang membaca angkanya dan memutuskan. Kami memakainya untuk membedah asisten CRM kami sendiri: 227 sesi percakapan, 1.100 pertanyaan, 20,8 detik, 0,0094 USD.
Kondisi utama: keputusan Anda tertutup, artinya jawabannya dapat ditulis sebagai ya, 1 pilihan dari daftar, atau 1 nilai pada tangga. Batas: Jev tidak menghitung, tidak membandingkan tanggal dengan andal, dan tidak menulis balasan. Untuk teks, Anda tetap memakai model generatif.
Kami menulis panduan ini dari jalan nyata pada 20 dan 21 September 2026, memakai dokumentasi resmi TypeSafe dan data percakapan produksi kami sendiri. Nomor dan nama pelanggan tidak muncul pada artikel ini, dan contoh memakai data dummy.
Masalahnya: asisten yang rajin menjawab terasa berhasil
Asisten AI yang sopan dan informatif memberi kesan bekerja. Chat masuk, pertanyaan dijawab, pengunjung berterima kasih, lalu pergi. Tidak ada 1 pun angka yang memberi tahu apakah asisten itu menjual.
Membaca percakapan satu per satu tidak menyelesaikannya. 227 percakapan berarti berjam-jam membaca, dan penilaian manusia berubah setelah percakapan ke-20. Kami membahas masalah pemeriksaan yang berpindah tangan ini pada Apa itu meat proxy.
Model keputusan menutup jarak itu. Anda menulis rubriknya 1 kali, lalu seluruh antrean dinilai dengan rubrik yang sama.
Cara kerja model keputusan
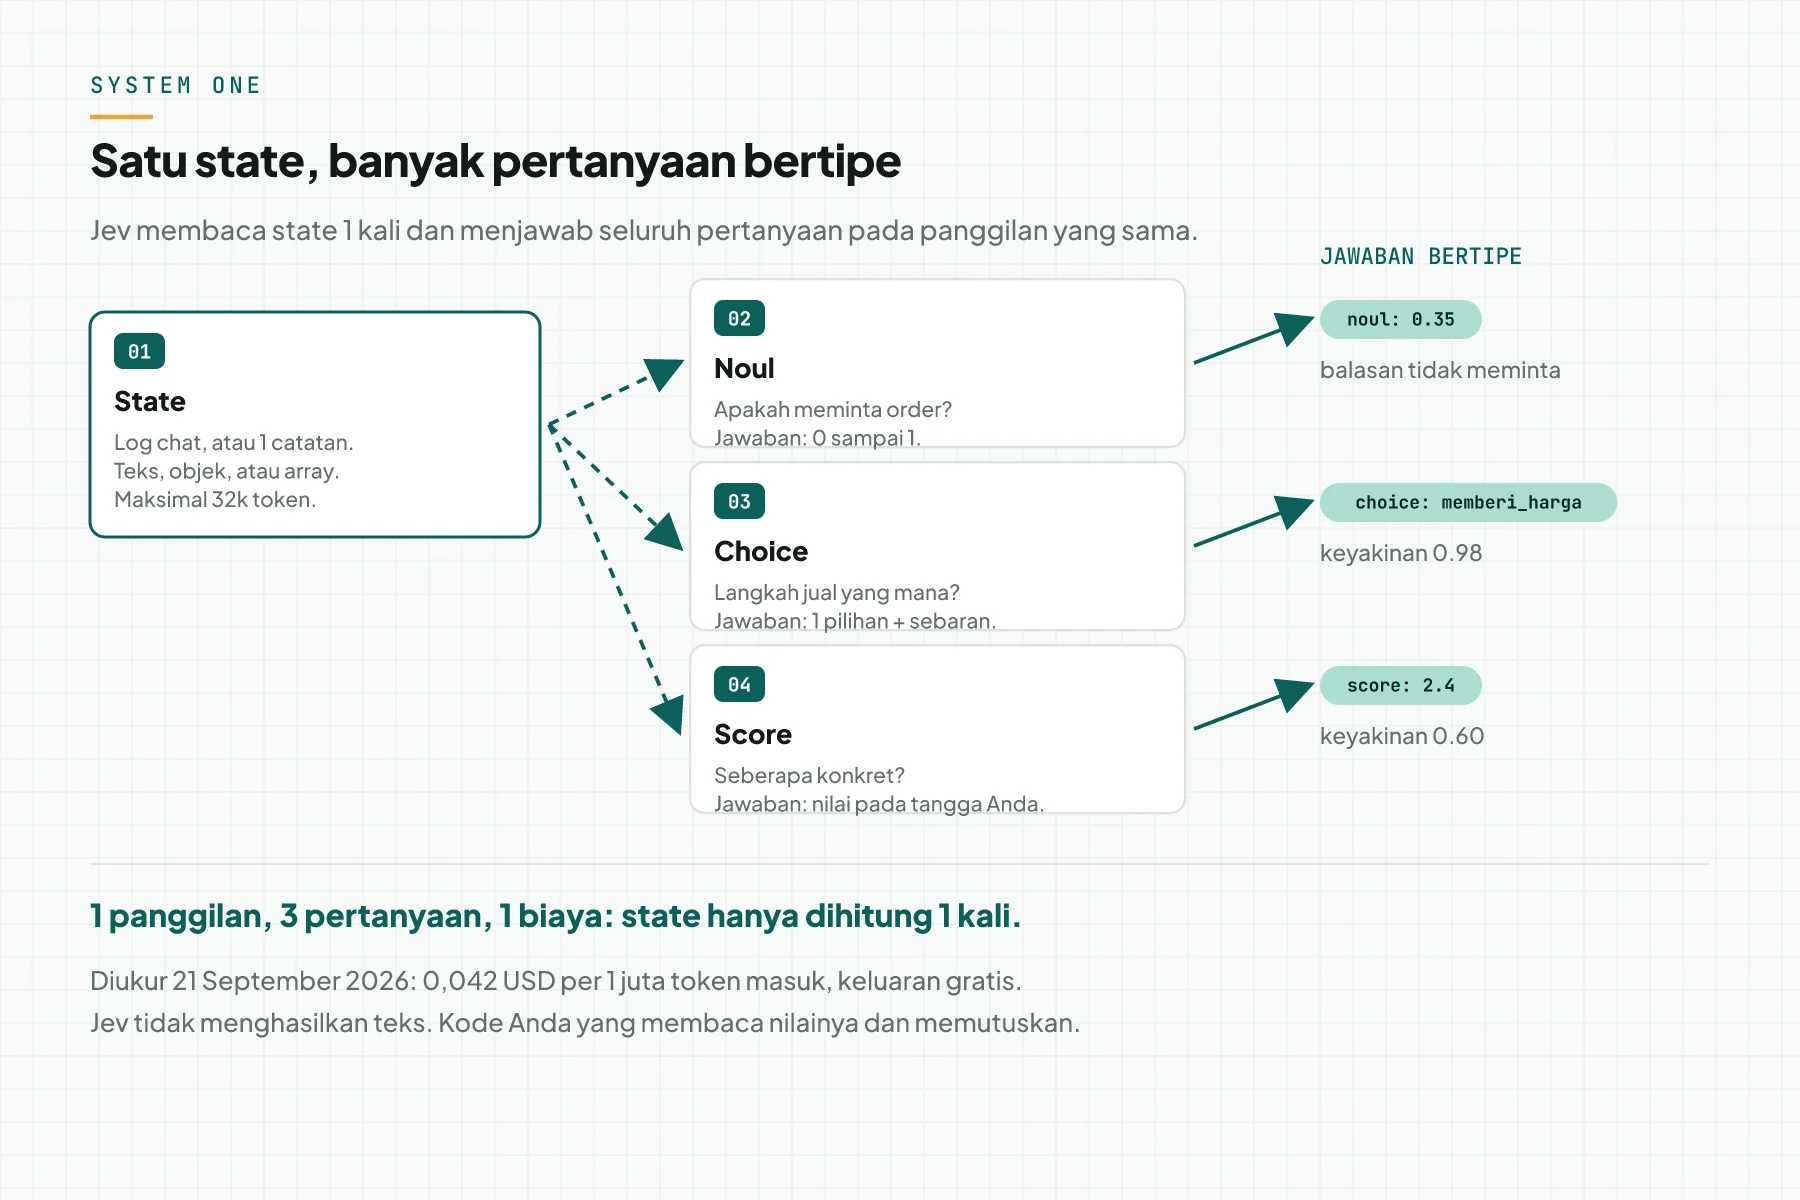
TypeSafe menyebut kelas model ini System One, dari istilah Daniel Kahneman untuk penilaian cepat. Model membaca state dan mengembalikan jawaban bertipe beserta peluangnya. Sumber: halaman System One TypeSafe.
Noul menjawab ya atau tidak
Noul mengembalikan 1 angka antara 0 dan 1. Angka itu adalah peluang jawabannya ya. Contoh pertanyaan: apakah balasan ini meminta pengunjung mengambil 1 langkah konkret.
Choice memilih 1 opsi dari daftar Anda
Choice mengembalikan 1 pilihan, peluang tiap pilihan, dan keyakinan. Anda menulis sendiri daftar opsinya, maksimal 255 opsi. Daftar itulah yang menentukan jawaban, jadi tulis opsi yang saling terpisah.
Score menilai pada tangga yang Anda tulis
Score mengembalikan 1 nilai pada tangga berurutan, 2 sampai 10 tingkat. Nilainya berbobot peluang, jadi 2,4 berarti jawaban berada di antara tingkat 2 dan 3. Sumber: halaman primitives TypeSafe.
Keyakinan berdiri terpisah dari jawaban
Tiap jawaban membawa angka keyakinan sendiri. Peluang menjawab pertanyaan "seberapa mungkin". Keyakinan menjawab pertanyaan "seberapa layak kode saya bertindak tanpa manusia". Sumber: halaman confidence TypeSafe.
Banding: model keputusan, model generatif, dan aturan tetap
Tiga alat ini menyelesaikan pekerjaan yang berbeda. Tabel berikut memakai angka resmi TypeSafe pada 21 September 2026 dan pengalaman kami sendiri.
| Hal | Model keputusan (Jev) | Model generatif | Aturan tetap (regex) |
|---|---|---|---|
| Keluaran | Pilihan, skor, peluang, keyakinan | Teks bebas | Cocok atau tidak cocok |
| Dibaca kode | Langsung, tanpa parsing | Perlu parsing dan penjagaan | Langsung |
| Harga token masuk | 0,042 USD per 1 juta | Berbeda tiap penyedia, umumnya jauh di atas itu | Tidak ada |
| Token keluar | Gratis | Dibayar | Tidak ada |
| Paham kalimat baru | Ya | Ya | Tidak |
| Menulis balasan | Tidak | Ya | Tidak |
| Cocok untuk | Menilai, memilah, menjaga, memutuskan | Menulis, meringkas, menjelaskan | Pola tetap seperti nomor invoice |
Ketiganya dipakai bersama. Pada sistem kami, model generatif menulis balasan, aturan tetap menangkap pola, dan Jev memutuskan langkah berikutnya.
Prasyarat sebelum mulai
- 1 kunci APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium TypeSafe. Simpan pada berkas
.envdengan mode 600, jangan pada repositori. - 1 ekspor percakapan atau catatan yang ingin Anda nilai. Format teks, objek, atau array.
- Rubrik tertulis. 1 kalimat untuk tiap pertanyaan, dan 1 kalimat untuk tiap opsi.
- 1 ambang keyakinan yang disepakati tim, misalnya 0,80 untuk aksi otomatis.
- Kemampuan menjalankan
curlatau 1 skrip Python. SDK Python dan JavaScript tersedia. - Data pelanggan yang sudah disamarkan bila Anda menyimpan hasilnya di luar sistem sendiri.
Langkah 1: Panggil endpoint dengan 1 pertanyaan
Kirim permintaan pertama untuk memastikan kunci dan bentuk permintaan Anda benar. Endpointnya POST https://api.typesafe.ai/v1/systemone. Header wajibnya Authorization: Bearer dan content-type: application/json.
{
  "state": {
    "pertanyaan_pengunjung": "berapa harga bikin landing page?",
    "balasan_wulan": "Jasa Pembuatan Landing Page seharga Rp 4,9 jt, durasi 7-10 hari kerja. Siapa nama yang dapat saya pakai untuk rangkuman ini?"
  },
  "model": "jev-latest",
  "questions": {
    "minta_order": {
      "type": "noul",
      "instructions": "Apakah balasan ini meminta pengunjung mengambil 1 langkah konkret, misalnya bayar, pilih jadwal, atau menerima penawaran?"
    },
    "langkah_jual": {
      "type": "choice",
      "instructions": "Langkah jual mana yang dilakukan balasan ini?",
      "criteria": {
        "menyapa": "Membuka percakapan",
        "menggali": "Menanyakan masalahnya",
        "menjelaskan": "Menerangkan layanan",
        "memberi_harga": "Menyebut harga atau paket",
        "minta_order": "Meminta pesanan, jadwal, atau pembayaran",
        "melempar": "Menyerahkan ke manusia"
      }
    }
  }
}
Simpan berkas itu sebagai demo.json, lalu jalankan perintah pada gambar berikut. Jawabannya tiba dalam bentuk JSON bertipe.
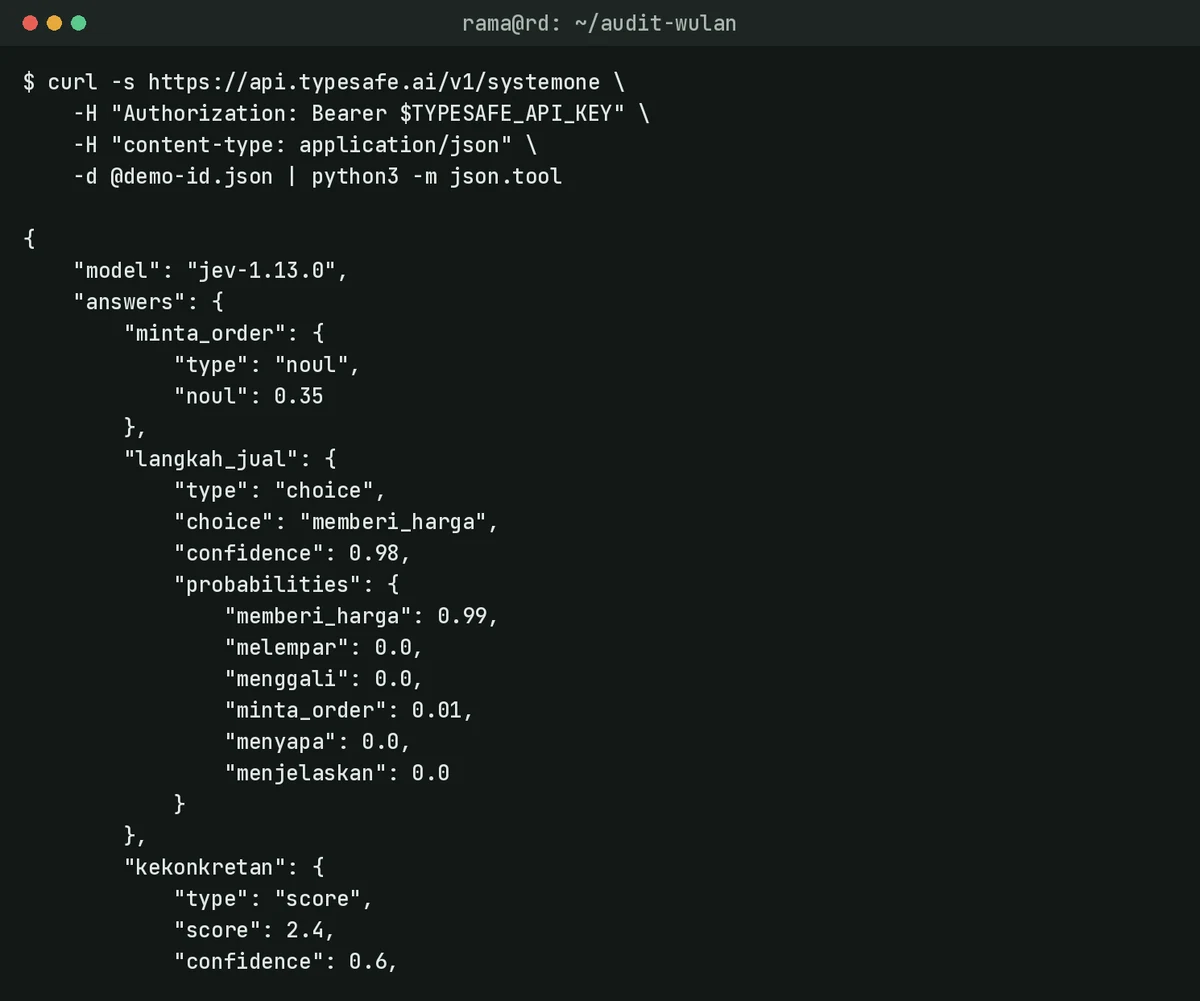
Cara memeriksa: jawaban memuat "model": "jev-1.13.0" dan 1 kunci di dalam answers untuk tiap pertanyaan yang Anda kirim. Bila kunci API salah, server menjawab authentication_error. Sumber: referensi API TypeSafe.
Langkah 2: Susun state dari 1 percakapan
State adalah bahan yang dinilai. Kirim objek, bukan kalimat panjang, supaya tiap bagian dapat dirujuk pada pertanyaan. Batasnya 32k token untuk state plus pertanyaan terpanjang.
Saring dulu isinya. Dokumentasi TypeSafe menyebut state besar yang penuh detail tak terpakai sebagai salah satu sisi lemah jev-1.13. Kirim hanya bagian yang dibutuhkan pertanyaan Anda. Sumber: halaman state TypeSafe.
Cara memeriksa: hitung token permintaan Anda pada jawaban, bagian usage.input_tokens. Pada audit kami, 1 percakapan penuh memakai sekitar 800 sampai 3.000 token masuk.
Langkah 3: Tulis pertanyaan yang tidak dapat ditafsir ganda
Jev menjawab pertanyaan yang Anda tulis, bukan yang Anda maksud. Tulis syaratnya secara harfiah, lalu taruh kasus batas pada criteria.
Contoh yang lemah: "Apakah balasan ini bagus?". Contoh yang bekerja: "Apakah balasan ini meminta pengunjung mengambil 1 langkah konkret, misalnya bayar, pilih jadwal, atau menerima penawaran?".
Tumpuk pertanyaan pada 1 panggilan. TypeSafe menilai seluruh pertanyaan paralel, dan biaya state hanya dihitung 1 kali. Pada audit kami, 12 pertanyaan per percakapan berjalan pada 1 panggilan. Sumber: pola speculative fan-out.
Cara memeriksa: bila Anda menemukan jawaban yang salah lalu menjelaskan "maksud saya sebenarnya", kalimat penjelasan itu adalah bagian pertanyaan yang hilang. Tambahkan ke instructions.
Langkah 4: Baca keyakinan, bukan hanya jawaban
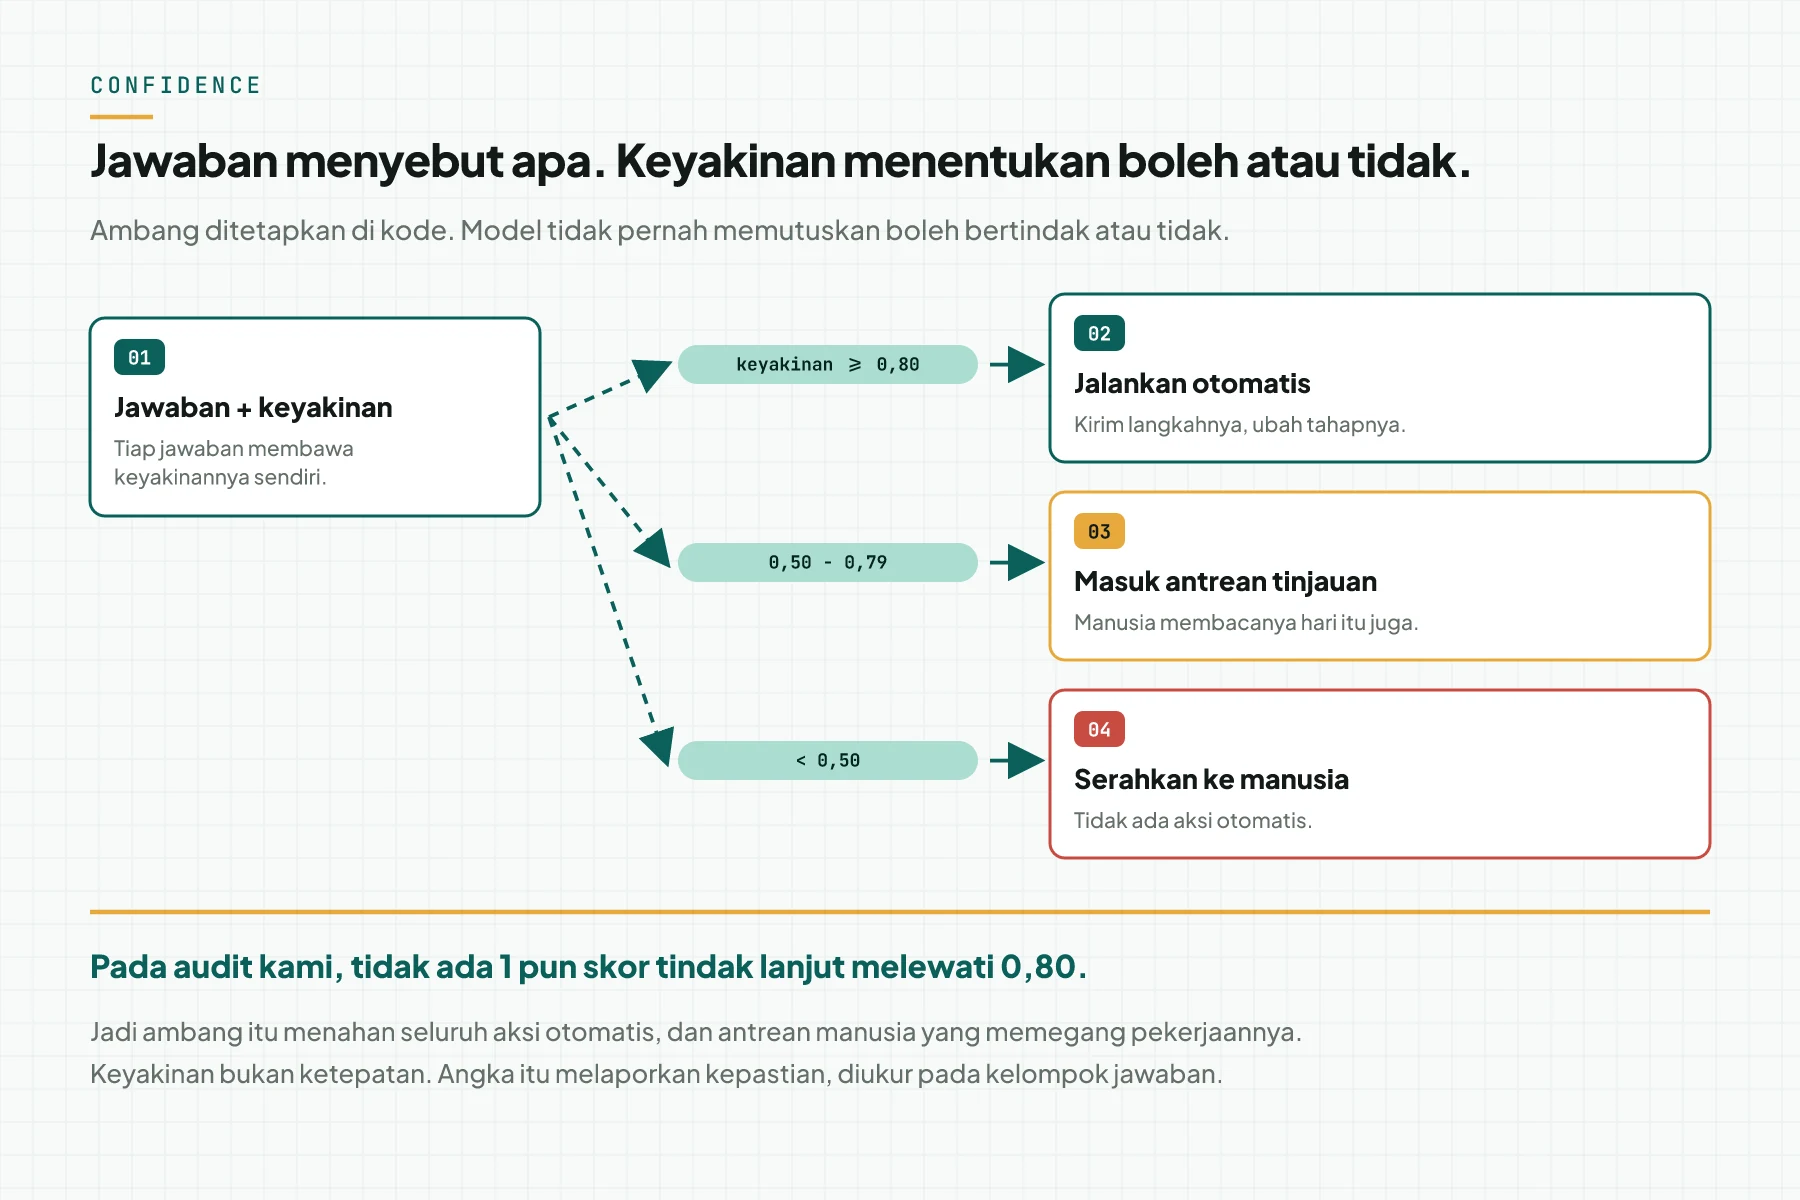
Jawaban menyebut apa. Keyakinan menentukan boleh atau tidak. Taruh ambangnya pada kode, bukan pada prompt.
const jawaban = hasil.answers.minta_order;
if (jawaban.noul >= 0.8) kirimAjakan();        // jalankan otomatis
else if (jawaban.noul >= 0.5) antreanManusia();  // tinjau hari ini
else diamkan();                                   // biarkan manusia
Keyakinan bukan ketepatan. TypeSafe mengukurnya pada kelompok jawaban, bukan pada 1 jawaban tunggal. Sumber: pola confidence-gated routing.
Cara memeriksa: hitung berapa persen antrean Anda lolos ambang. Pada audit kami, tidak ada 1 pun skor tindak lanjut melewati 0,80, jadi seluruh aksi otomatis tertahan dan antrean manusia yang memegang pekerjaannya.
Langkah 5: Jalankan seluruh antrean, lalu hitung biayanya
Jalankan pertanyaan yang sama pada seluruh catatan. Kami memakai 12 pertanyaan per percakapan, 5 pertanyaan per balasan asisten, dan 3 pertanyaan per catatan sesi.
Pakai kolam benang, misalnya 8 sampai 12 permintaan serentak. Batas resmi TypeSafe adalah 250.000 token per detik dan 1.200 permintaan per menit. Sumber: halaman models TypeSafe.
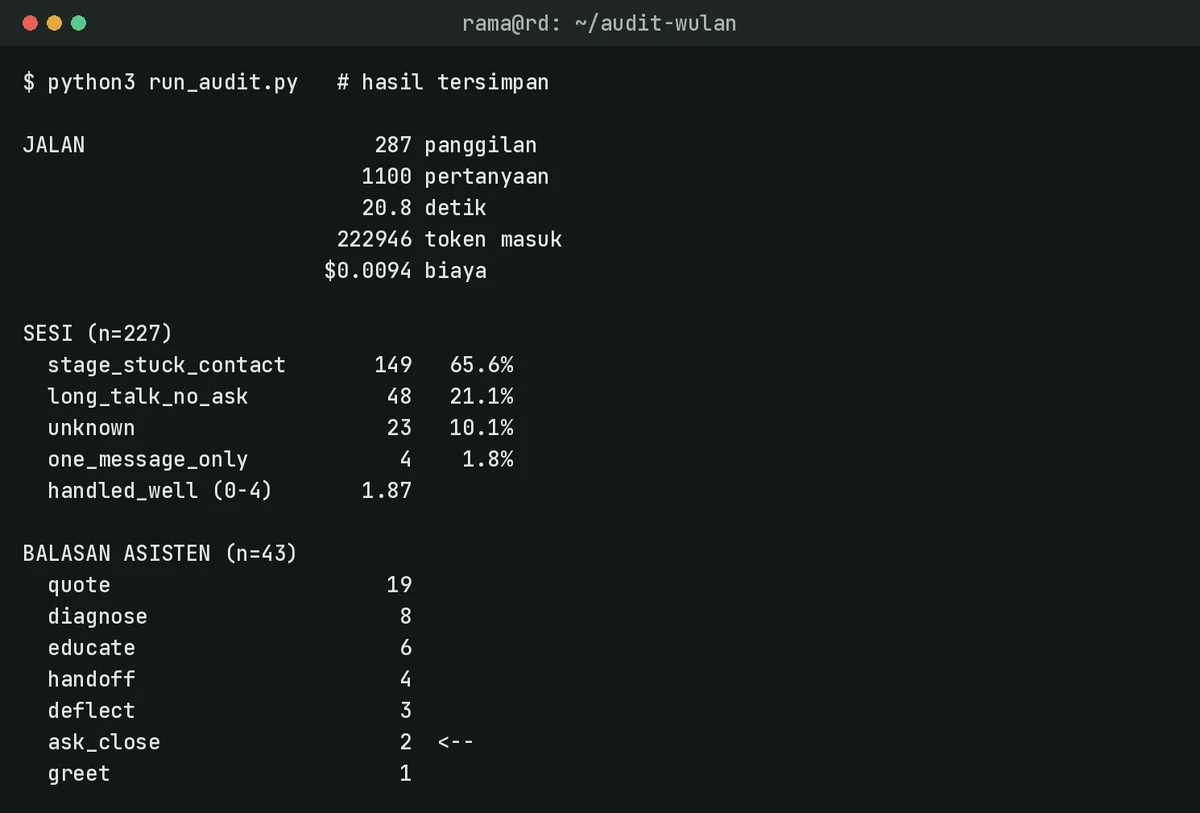
Cara memeriksa: jumlahkan usage.input_tokens seluruh panggilan, lalu kalikan 0,042 USD per 1 juta token. Jalan kami memakai 222.946 token masuk, jadi biayanya 0,0094 USD.
Langkah 6: Sambungkan hasilnya ke pekerjaan nyata
Angka tanpa tindakan tidak mengubah apa pun. Ubah tiap temuan menjadi 1 perubahan yang dapat diuji ulang.
Pada sistem kami, 3 temuan menjadi 3 perubahan. Balasan yang tidak pernah meminta order menjadi aturan "beri 1 langkah setelah penggalian selesai". Balasan yang panjang menjadi batas 80 kata. Bahasa yang berpindah menjadi kunci bahasa percakapan.
Cara memeriksa: jalankan skenario uji yang sama sebelum dan sesudah perubahan, lalu nilai keduanya dengan pertanyaan yang sama. Pada uji kami, rata-rata panjang balasan turun dari 71 kata menjadi 43 kata, dan balasan yang melewati 80 kata turun dari 73% menjadi 45%.
Contoh terukur dengan data dummy
Tabel berikut adalah simulasi memakai data dummy. Angkanya menggambarkan bentuk alur, bukan hasil 1 pelanggan nyata.
| Waktu | Masukan | Keputusan Jev | Tindakan sistem |
|---|---|---|---|
| 09.14 | Pengunjung menulis "berapa harga landing pageLanding pageHalaman tujuan iklan yang memuat 1 penawaran dan 1 tindakan, tanpa menu yang menarik pengunjung ke tempat lain.Apa itu landing page??" | minta_order 0,35 | Balasan keluar, tidak ada aksi otomatis |
| 09.15 | Balasan asisten menyebut harga dan menanyakan nama | langkah_jual memberi_harga, keyakinan 0,98 | Tandai percakapan sebagai belum ditutup |
| 09.41 | Percakapan diam 26 menit | layak_dikejar 0,62 | Masuk antrean tinjauan manusia |
| 10.05 | Tim membuka antrean pagi | — | Manusia mengirim 1 tautan jadwal |
Perhatikan baris 09.41. Nilai 0,62 berada di bawah ambang otomatis 0,80, jadi sistem tidak mengirim apa pun sendiri. Pekerjaan berpindah ke manusia, dan itu memang keputusannya.
Checklist sebelum Anda memakainya pada data nyata
- Tulis rubrik dan simpan pada repositori. Pemilik: penanggung jawab produk. Bukti: berkas rubrik dengan riwayat perubahan.
- Uji 10 catatan yang Anda sudah tahu jawabannya. Pemilik: engineer. Bukti: tabel jawaban Jev melawan jawaban Anda.
- Samarkan nama, nomor, dan email sebelum data keluar dari sistem Anda. Pemilik: engineer. Bukti: skrip penyamaran.
- Tetapkan ambang keyakinan untuk aksi otomatis. Pemilik: pemilik proses. Bukti: 1 baris konstanta pada kode.
- Catat biaya tiap jalan. Pemilik: engineer. Bukti: jumlah token masuk per jalan.
- Siapkan antrean manusia untuk jawaban di bawah ambang. Pemilik: tim operasi. Bukti: daftar tugas harian.
- Berhenti bila jawaban Jev dan jawaban Anda berbeda pada lebih dari 2 dari 10 catatan uji. Perbaiki rubriknya lebih dulu.
Kapan model keputusan bukan jawabannya
TypeSafe menerbitkan daftar sisi lemah jev-1.13 sendiri, ditinjau 17 September 2026. Daftar itu jujur dan layak dibaca sebelum Anda memakainya. Sumber: halaman jaggedness jev-1.13.
| Sisi lemah | Yang dilakukan |
|---|---|
| Membaca harfiah | Tulis syarat yang tepat pada instruksi dan kasus batas pada kriteria |
| Hitungan dan angka | Taruh aritmetika pada kode |
| Perbandingan tanggal | Ambil komponennya, bandingkan pada kode |
| State besar | Saring dulu, kirim yang dibutuhkan saja |
| Menulis teks | Pakai model generatif |
Rekomendasi Rama Digital: pakai model keputusan bila jawaban Anda tertutup dan volumenya besar. Untuk 10 catatan per bulan, membaca sendiri lebih murah daripada menulis rubrik.
Pertanyaan yang sering muncul
Apakah Jev menggantikan ChatGPT atau Claude? Tidak. Jev tidak menghasilkan teks sama sekali. Model generatif menulis balasan, sedangkan Jev memutuskan hal yang jawabannya tertutup, seperti memilih 1 jalur atau menilai 1 balasan.
Berapa biaya untuk 1.000 percakapan? Biayanya mengikuti token masuk. Audit kami memakai 222.946 token masuk untuk 227 sesi plus 43 balasan, sehingga biayanya 0,0094 USD. Token keluar tidak dibayar.
Apakah jawabannya konsisten? Jawaban yang sama untuk state yang sama umumnya stabil, tetapi peluang tetap bergerak sedikit. Karena itu ambang keyakinan penting, dan angka batas Anda harus ditulis pada kode.
Apakah data percakapan kami dikirim ke pihak lain? State dikirim ke API TypeSafe, jadi perlakukan seperti pengiriman data ke penyedia mana pun. Samarkan nama, nomor, dan email lebih dulu bila kebijakan Anda menuntutnya.
Apakah kami perlu SDK? Tidak wajib. HTTP biasa sudah memadai, dan SDK Python serta JavaScript tersedia bila Anda ingin tipe siap pakai serta percobaan ulang otomatis.
Langkah berikutnya
Batas yang tersisa jelas: model keputusan memberi angka, bukan perbaikan. Perubahan pada asisten, rubrik, dan ambang tetap pekerjaan tim Anda. Kami membahas kebiasaan menguji sistem sendiri pada Chaos engineering untuk vibe coder.
Bila Anda ingin kami memetakan alur kerja dan titik keputusan yang layak diserahkan ke mesin, buka AI Diagnostic. Bila Anda ingin membahasnya lebih dulu, pilih jadwal sesi AI Diagnostic.