Jawaban langsung: Jev adalah model AI dari TypeSafe yang membuat keputusan, bukan teks. Anda mengirim 1 state dan sekumpulan pertanyaan bertipe, lalu Jev mengembalikan jawaban yang dapat dibaca kode: 1 angka peluang, 1 pilihan dari daftar Anda, atau 1 nilai pada tangga Anda. TypeSafe menyebut kelas model ini System One, dan merilisnya pada 15 September 2026.
Kondisi utama: pertanyaan Anda tertutup, artinya ruang jawabannya Anda tulis sendiri. Batas: Jev tidak menulis kalimat, tidak menjelaskan alasannya, dan tidak menghitung angka.
Kami menulis penjelasan ini dari dokumentasi resmi TypeSafe dan pemakaian sendiri pada 20 dan 21 September 2026. Angka harga dan batas teknis berasal dari halaman resmi, bukan dari ingatan.
Jev menjawab, bukan mengarang
Model bahasa biasa menghasilkan teks. Anda meminta jawaban, lalu kode Anda membaca kalimat dan menebak maksudnya. Langkah menebak itulah yang sering pecah.
Jev menghapus langkah itu. Anda menulis pertanyaan beserta ruang jawabannya, dan jawaban yang kembali sudah berbentuk data. Tidak ada kalimat untuk diurai dan tidak ada format yang meleset.
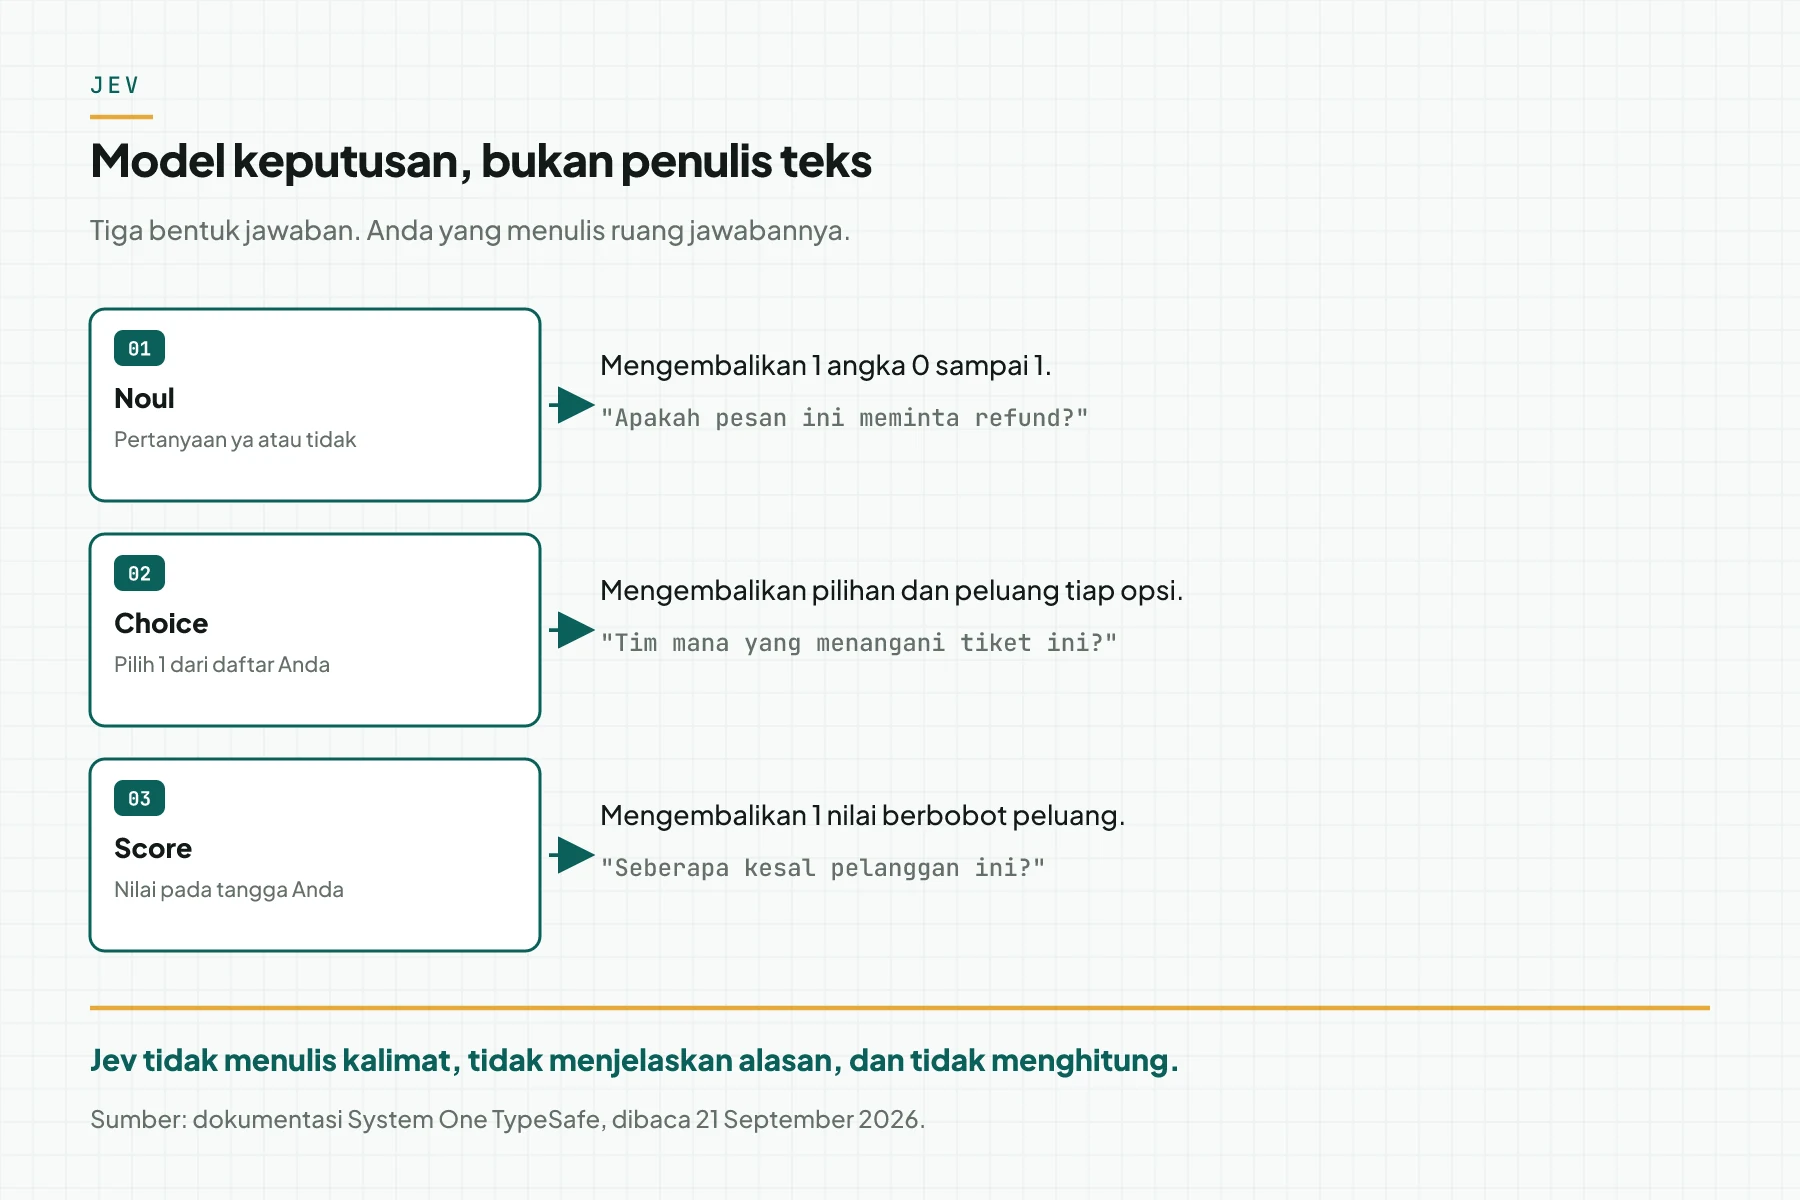
Tiga bentuk pertanyaan
Noul: pertanyaan ya atau tidak
Noul mengembalikan 1 angka antara 0 dan 1. Angka itu adalah peluang jawabannya ya. Contoh: "Apakah pesan ini meminta pengembalian dana?". Sumber: halaman Noul TypeSafe.
Choice: pilih 1 dari daftar Anda
Choice mengembalikan 1 pilihan, peluang tiap pilihan, dan keyakinan. Anda menulis daftar opsinya, paling banyak 255 opsi. Tulis opsi yang tidak saling tumpang tindih, karena daftar itulah yang menentukan jawabannya. Sumber: halaman Choice TypeSafe.
Score: nilai pada tangga Anda
Score mengembalikan 1 nilai pada tangga berurutan, 2 sampai 10 tingkat. Nilainya berbobot peluang, jadi 1,4 berarti jawaban berada di antara tingkat 1 dan 2. Sumber: halaman Score TypeSafe.
Ketiganya boleh berada pada 1 permintaan yang sama. Contoh berikut mengirim 1 kalimat pelanggan dan 3 pertanyaan sekaligus.
{
  "state": "Pesanan saya belum sampai dan saya sudah menunggu 5 hari.",
  "model": "jev-latest",
  "questions": {
    "minta_refund": { "type": "noul", "instructions": "Apakah pesan ini meminta pengembalian dana?" },
    "tim": {
      "type": "choice",
      "instructions": "Tim mana yang harus menangani pesan ini?",
      "criteria": {
        "pengiriman": "Paket, resi, dan keterlambatan",
        "tagihan": "Pembayaran, invoice, dan refund",
        "teknis": "Aplikasi, akun, dan error"
      }
    },
    "kekesalan": {
      "type": "score",
      "instructions": "Seberapa kesal penulis pesan ini?",
      "criteria": ["Tenang", "Kesal", "Marah"]
    }
  }
}
Keyakinan menentukan boleh atau tidak
Tiap jawaban membawa angka keyakinan sendiri. Peluang menjawab pertanyaan "seberapa mungkin". Keyakinan menjawab pertanyaan lain: "seberapa layak kode saya bertindak tanpa manusia".
Pemisahan ini yang membuat model keputusan dapat dipakai pada alur produksi. Anda menetapkan ambang pada kode, misalnya 0,80 untuk aksi otomatis, lalu sisanya masuk antrean manusia. Sumber: halaman confidence TypeSafe.
TypeSafe menulis bahwa kalibrasi diukur pada kelompok jawaban, bukan pada 1 jawaban tunggal. Jadi keyakinan tinggi tidak menjamin 1 jawaban benar.
Yang bukan pekerjaan Jev
Jev tidak menggantikan model generatif. Keduanya mengerjakan bagian yang berbeda pada 1 alur yang sama.
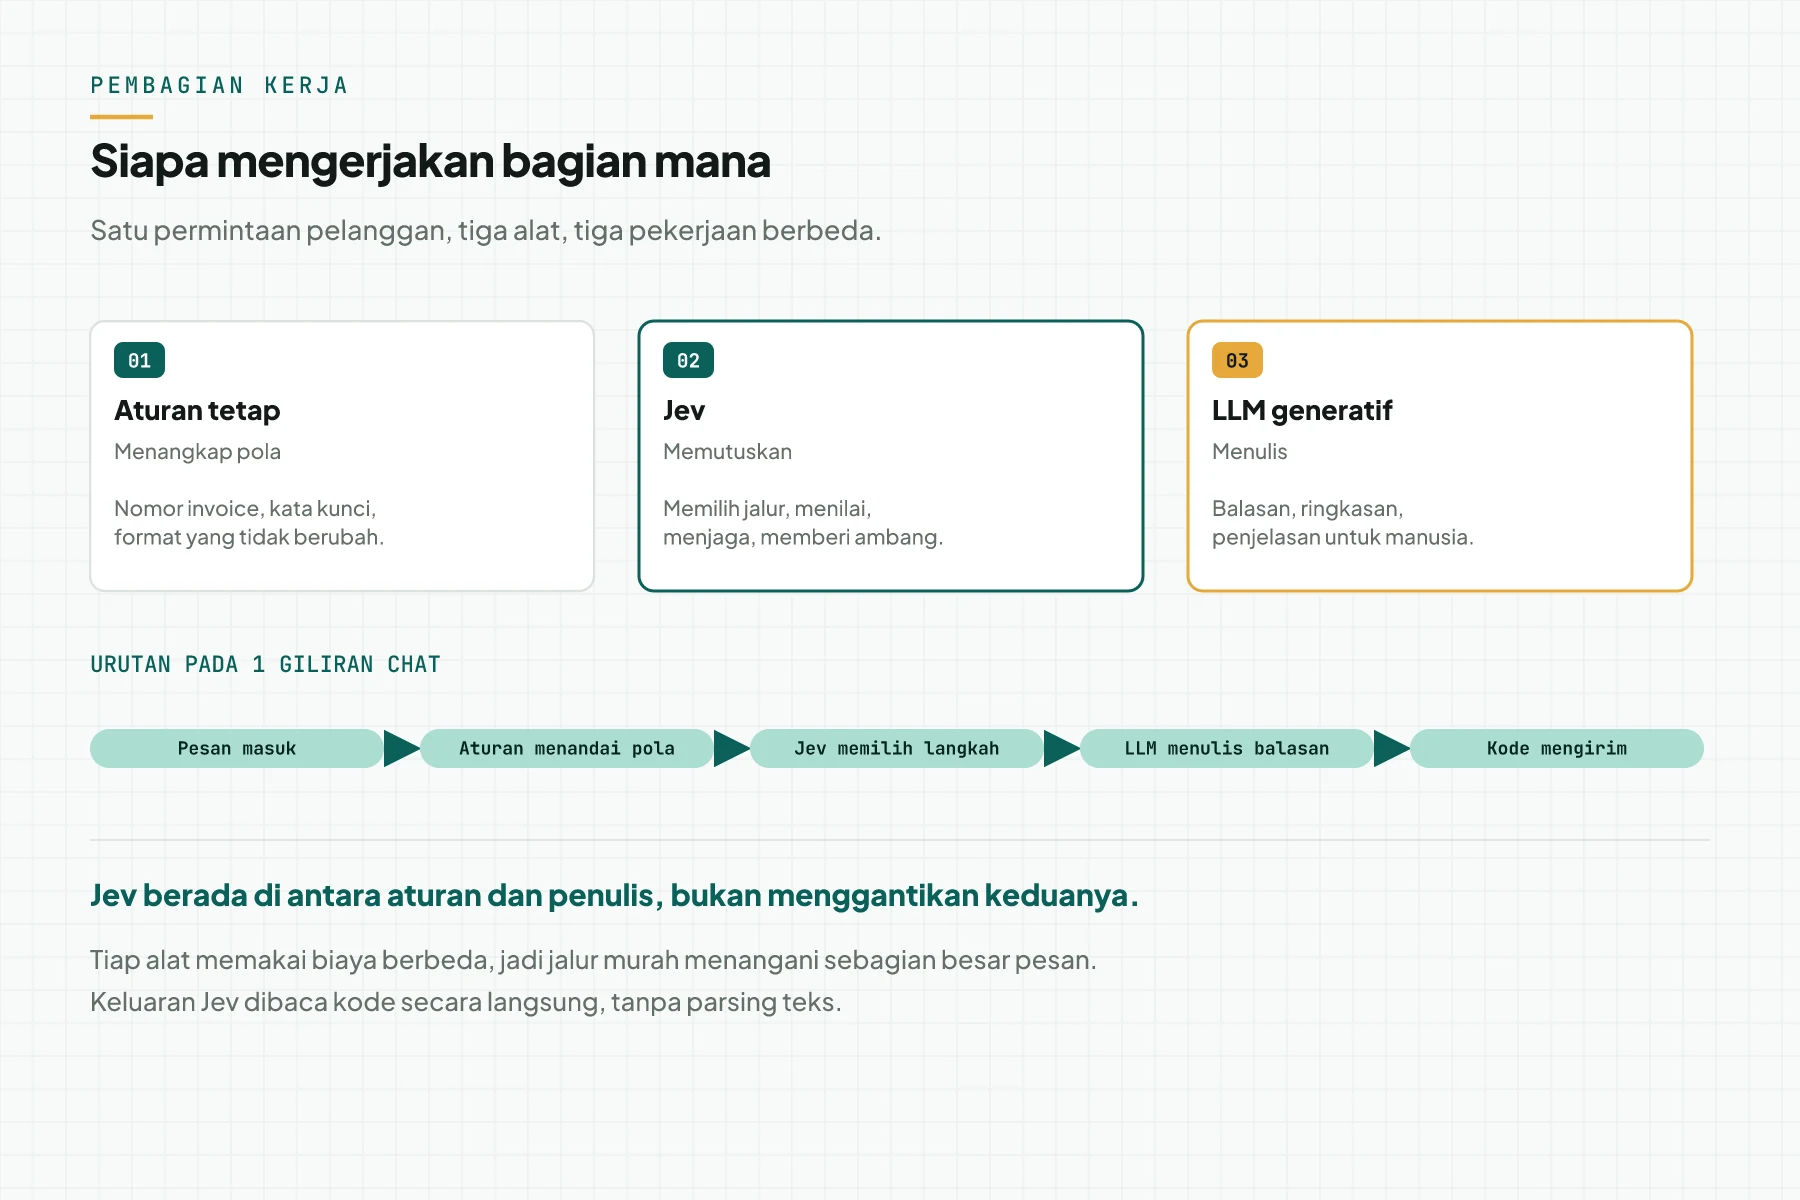
| Pekerjaan | Alat yang tepat |
|---|---|
| Menulis balasan untuk pelanggan | Model generatif |
| Memilih 1 jalur dari 3 jalur | Jev |
| Menghitung total tagihan | Kode biasa |
| Menangkap nomor invoice | Aturan tetap |
| Menilai kekesalan pelanggan | Jev |
| Membandingkan 2 tanggal | Kode biasa |
TypeSafe menerbitkan sendiri daftar sisi lemah jev-1.13, ditinjau 17 September 2026. Model ini membaca harfiah, lemah pada hitungan, dan melemah bila state besar dan penuh detail tak terpakai. Sumber: halaman jaggedness jev-1.13.
Harga dan batas teknis
| Ukuran | Nilai |
|---|---|
| Harga token masuk | 0,042 USD per 1 juta token |
| Harga token keluar | Gratis |
| Batas konteks | 64k per permintaan, 32k untuk state plus pertanyaan terpanjang |
| Batas laju | 250.000 token per detik, 1.200 permintaan per menit |
| Masukan yang diterima | Teks, objek JSON, dan array teks |
Seluruh pertanyaan pada 1 permintaan dinilai paralel, dan biaya state hanya dihitung 1 kali. Jadi menumpuk 12 pertanyaan pada 1 panggilan lebih murah daripada 12 panggilan terpisah. Sumber: halaman models TypeSafe dan pola fan-out.
Pada uji kami, 1 pertanyaan tunggal dari Jakarta selesai dalam median 760 milidetik, termasuk perjalanan jaringan.
Kapan model keputusan pantas dipakai
Pakai model keputusan bila 3 hal berikut benar. Pertama, jawaban Anda tertutup. Kedua, volumenya besar. Ketiga, keputusan itu berulang dengan rubrik yang sama.
Kami memakainya untuk membedah asisten CRM kami sendiri: 227 percakapan produksi dinilai dalam 20,8 detik seharga 0,0094 USD. Cerita lengkap dan cara memasangnya ada pada panduan memakai Jev untuk audit percakapan.
Rekomendasi Rama Digital: mulai dari 1 keputusan yang paling sering Anda ulang, bukan dari seluruh sistem sekaligus. Satu rubrik yang benar lebih berguna daripada 10 rubrik yang setengah jadi.
Cara membaca jawaban yang kembali
Jawaban Jev memakai bentuk tetap, jadi kode Anda membacanya tanpa penjagaan tambahan. Tiap kunci pada answers memakai nama yang Anda tulis sendiri pada permintaan.
| Bentuk | Kolom yang kembali | Cara memakainya |
|---|---|---|
| Noul | noul | Bandingkan dengan ambang Anda, misalnya 0,8 |
| Choice | choice, probabilities, confidence | Pakai choice untuk jalur, confidence untuk gerbangnya |
| Score | score, legend, probabilities, confidence | Bulatkan bila Anda perlu tingkat, bukan nilai pecahan |
| Seluruh permintaan | usage.input_tokens | Kalikan harga untuk menghitung biaya tiap jalan |
Perhatikan 1 hal penting. Nama kunci pertanyaan tidak ikut dinilai model, jadi menamai pertanyaan penting_banget tidak mengubah jawabannya. Hanya instructions dan criteria yang menentukan hasil.
Kesalahan yang sering terjadi saat menulis pertanyaan
Empat kesalahan berikut muncul paling sering, dan seluruhnya berasal dari rubrik, bukan dari model.
- Pertanyaan bernilai rasa. "Apakah balasan ini bagus" tidak memiliki syarat. Tulis syarat yang dapat diperiksa orang lain.
- Opsi yang tumpang tindih. Bila 2 opsi dapat benar bersamaan, peluangnya terbelah dan keyakinan turun.
- Kriteria yang melawan instruksi. Instruksi meminta 1 hal, kriteria menjelaskan hal lain, lalu jawabannya mengikuti yang mana saja.
- State yang terlalu gemuk. Mengirim seluruh riwayat pelanggan untuk menilai 1 balasan menurunkan mutu jawaban dan menaikkan biaya.
Uji rubrik Anda pada 10 catatan yang jawabannya sudah Anda ketahui. Bila Jev dan Anda berbeda pada lebih dari 2 catatan, perbaiki rubriknya lebih dulu. Sumber: panduan membangun dengan System One.
Pertanyaan yang sering muncul
Apakah Jev sebuah chatbot? Bukan. Jev tidak menghasilkan kalimat sama sekali. Model ini hanya mengembalikan angka, pilihan, dan keyakinan yang dibaca kode Anda.
Apakah Jev bisa dipakai bahasa Indonesia? Bisa. State dan pertanyaan boleh ditulis bahasa Indonesia, dan pada uji kami jawabannya mengikuti rubrik yang kami tulis.
Apa bedanya dengan klasifikasi biasa? Klasifikasi biasa perlu data latih dan ambang yang dicari sendiri. Jev memakai rubrik yang Anda tulis dengan kalimat, lalu mengembalikan peluang beserta keyakinannya.
Apakah jawabannya selalu sama? Untuk state yang sama, jawabannya umumnya stabil, tetapi peluang tetap bergerak sedikit. Karena itu ambang keputusan Anda perlu ditulis pada kode.
Berapa biaya untuk mencoba? Percobaan kecil hampir tidak berbiaya. Audit kami yang memakai 287 panggilan dan 1.100 pertanyaan berhenti pada 0,0094 USD.
Langkah berikutnya
Batas yang tersisa: model keputusan memberi angka, bukan perbaikan. Anda tetap menulis rubriknya, menetapkan ambangnya, dan mengubah sistemnya. Kami menulis kebiasaan menguji sistem sendiri pada Chaos engineering untuk vibe coder.
Bila Anda ingin kami memetakan titik keputusan yang layak diserahkan ke mesin, buka AI Diagnostic. Untuk membahasnya lebih dulu, pilih jadwal sesi AI Diagnostic.