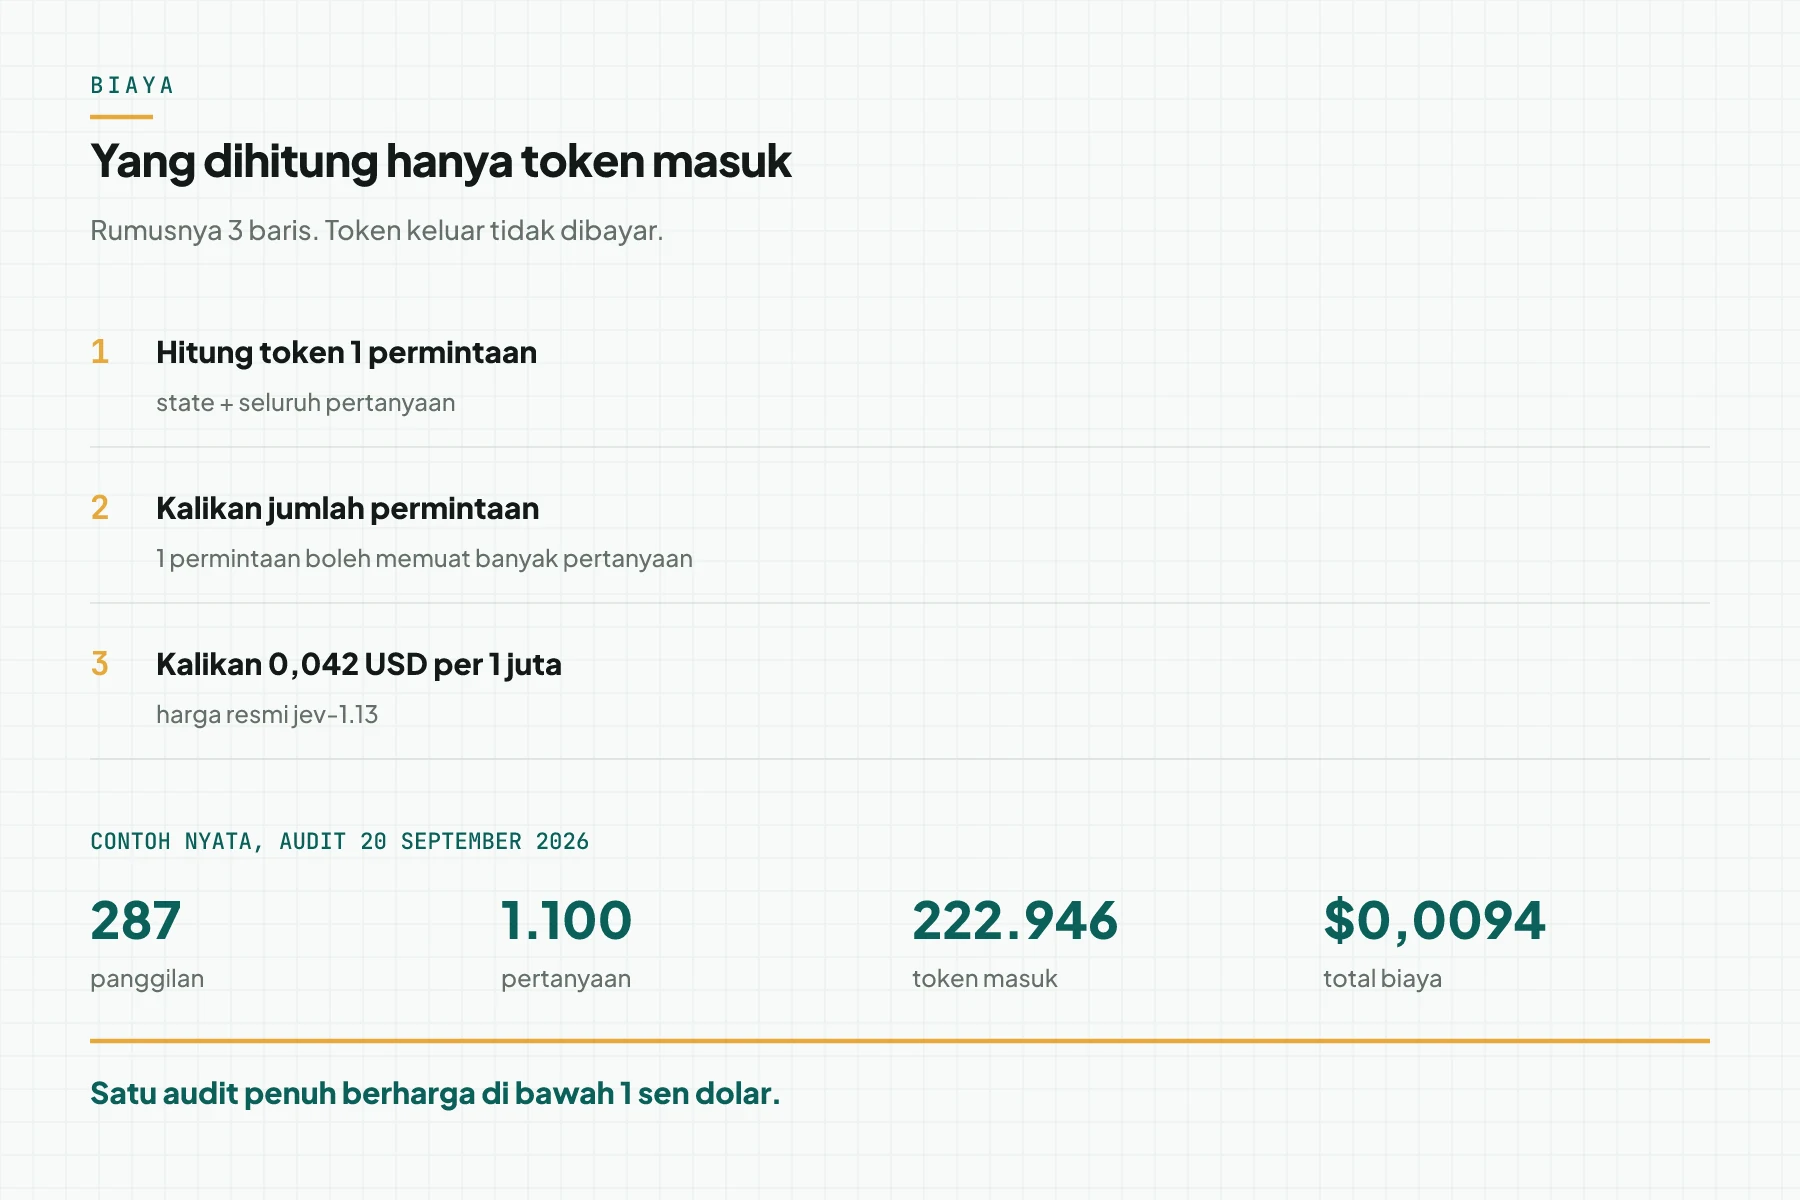
Jawaban langsung: Jev menagih token masuk saja, 0,042 USD per 1 juta token, dan token keluar gratis. Biaya 1 jalan sama dengan jumlah token masuk seluruh permintaan dikali 0,042 dibagi 1 juta. Audit kami memakai 287 panggilan dan 222.946 token masuk, sehingga tagihannya 0,0094 USD, sekitar Rp 155.
Kondisi utama: angka ini berlaku untuk model jev-1.13 pada 21 September 2026. Batas: harga dapat berubah, dan ukuran state Anda yang menentukan tagihan akhir, bukan jumlah pertanyaan.
Kami menulis panduan ini dari halaman harga resmi TypeSafe dan dari jalan nyata kami sendiri pada 20 September 2026. Angka token berasal dari kolom usage pada jawaban, bukan dari perkiraan.
Yang dihitung dan yang tidak
Model generatif menagih 2 sisi: token yang masuk dan token yang keluar. Jev hanya menagih 1 sisi.
| Bagian | Ditagih | Catatan |
|---|---|---|
| State | Ya | Isi yang dinilai, dihitung 1 kali per permintaan |
| Instruksi pertanyaan | Ya | Termasuk kriteria tiap opsi |
| Jawaban yang kembali | Tidak | Token keluar gratis |
| Nama kunci pertanyaan | Tidak | Tidak dikirim ke model |
Karena token keluar gratis, pertanyaan yang mengembalikan sebaran peluang panjang tidak menambah tagihan. Yang menambah tagihan hanyalah teks yang Anda kirim.
Rumus dan contoh hitungan
Ambil jumlah token masuk dari jawaban, lalu kalikan harganya. Kode berikut melakukannya untuk 1 jalan penuh.
# 1 permintaan, 12 pertanyaan, 1 kali biaya state
total_token = 0
for hasil in jawaban:
    total_token += hasil["usage"]["input_tokens"]

biaya_usd = total_token * 0.042 / 1_000_000
print(f"{total_token} token masuk, {biaya_usd:.4f} USD")
Contoh kecil. Satu balasan chat sepanjang 800 token masuk berharga 0,0000336 USD. Seribu balasan sejenis berharga 0,0336 USD, di bawah Rp 600.
Contoh kami sendiri. Audit 227 sesi memakai 12 pertanyaan per percakapan, 5 pertanyaan per balasan, dan 3 pertanyaan per catatan sesi. Totalnya 1.100 pertanyaan pada 287 panggilan, memakan 222.946 token masuk, dan berhenti pada 0,0094 USD.
Biaya untuk 1.000 keputusan
Tabel berikut memakai 3 ukuran state yang kami temui sendiri. Angkanya perkiraan, dan ukuran permintaan Anda menentukan hasil akhirnya.
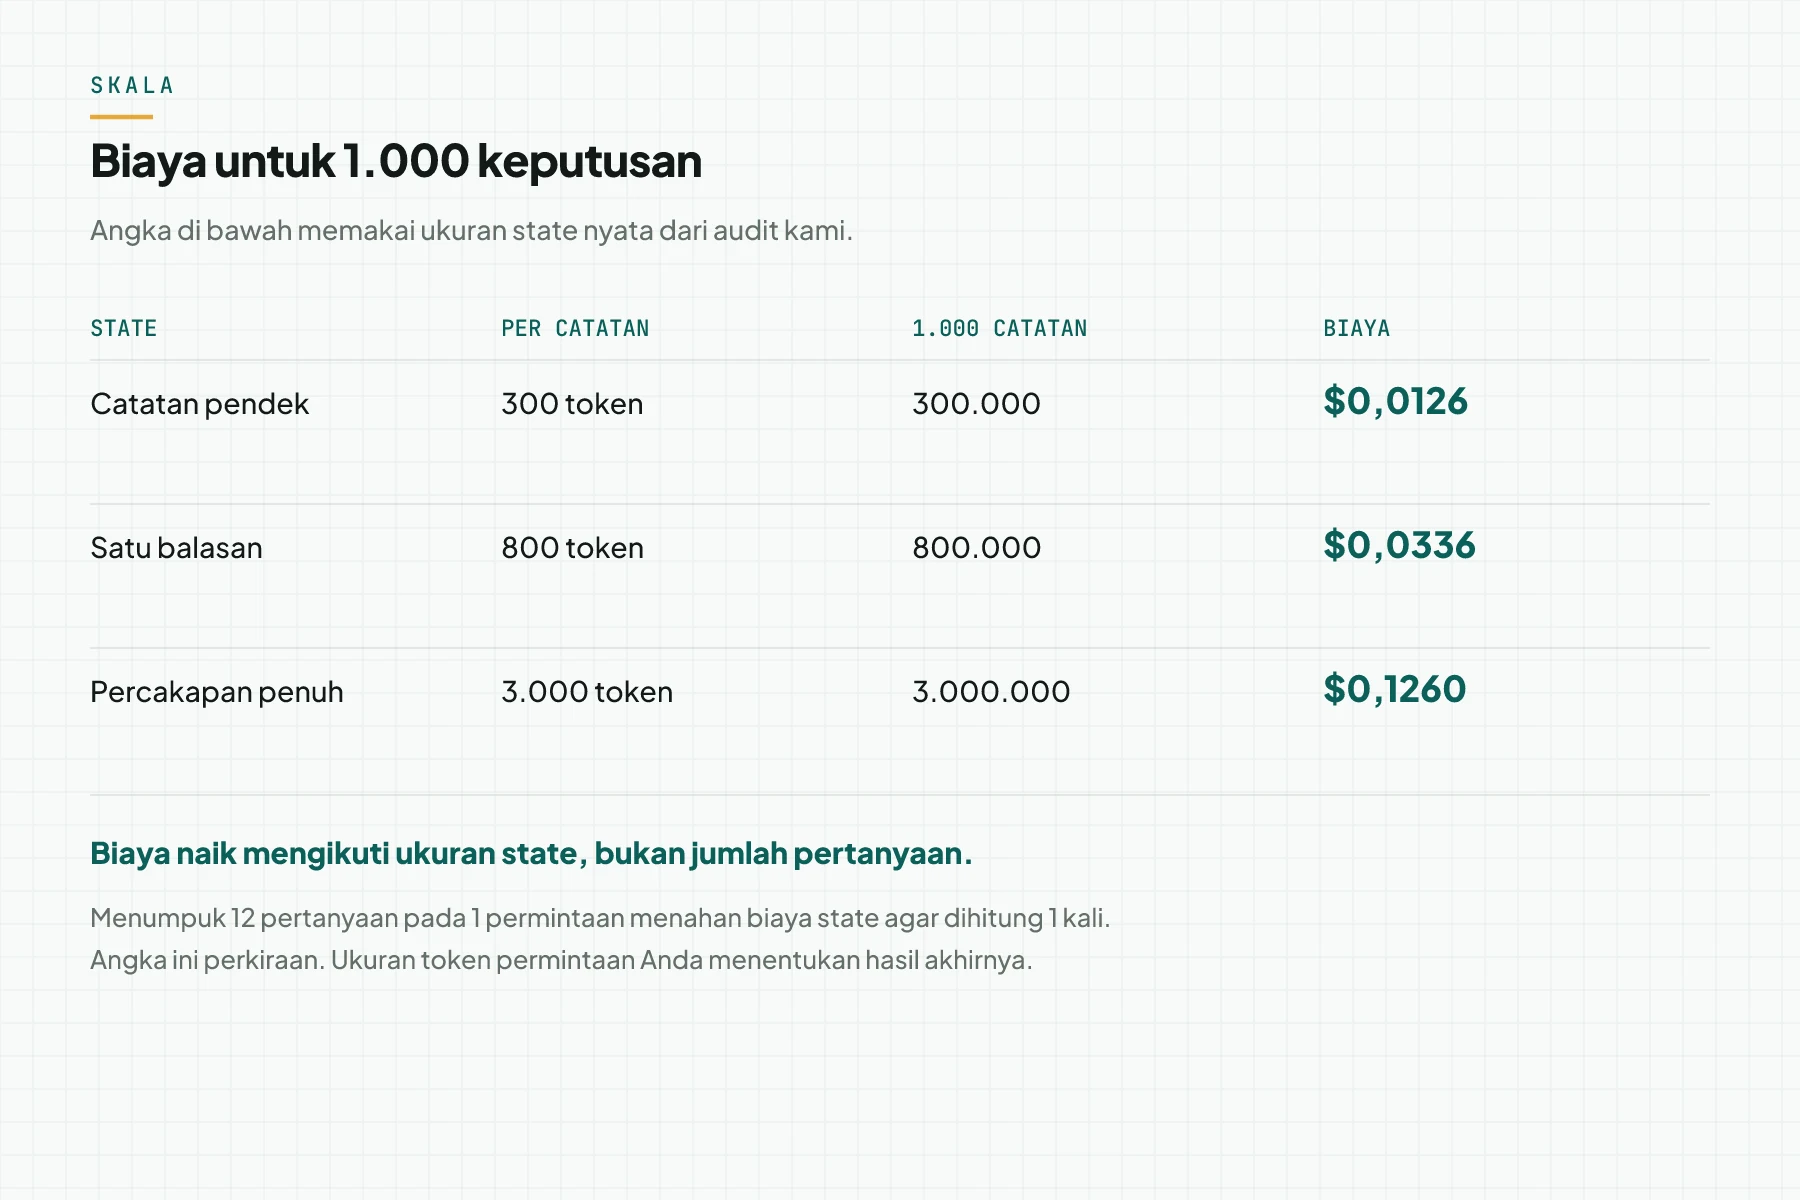
| Jenis state | Token per catatan | 1.000 catatan | Biaya |
|---|---|---|---|
| Catatan pendek, misalnya metadata sesi | 300 | 300.000 token | 0,0126 USD |
| Satu balasan chat | 800 | 800.000 token | 0,0336 USD |
| Percakapan penuh | 3.000 | 3.000.000 token | 0,1260 USD |
Perhatikan bahwa 3 baris di atas memakai jumlah pertanyaan yang sama. Yang berbeda hanya ukuran bahan yang dikirim.
Empat cara menekan tagihan
- Tumpuk pertanyaan pada 1 permintaan. Biaya state dihitung 1 kali, jadi 12 pertanyaan pada 1 panggilan jauh lebih murah daripada 12 panggilan. Sumber: pola fan-out.
- Saring state lebih dulu. Kirim bagian yang dibutuhkan pertanyaan, bukan seluruh riwayat. Ini menurunkan biaya dan menaikkan mutu jawaban.
- Pakai bentuk tertutup, bukan kalimat panjang. Objek JSON pendek memakai token lebih sedikit daripada narasi yang sama isinya.
- Saring dengan kode sebelum memanggil model. Catatan yang jelas tidak relevan tidak perlu dinilai model sama sekali.
Pada audit kami, pilihan menumpuk 12 pertanyaan pada 1 panggilan menahan jumlah panggilan pada 287, bukan lebih dari 1.000.
Batas laju dan konteks
| Batas | Nilai |
|---|---|
| Token per detik | 250.000 |
| Permintaan per menit | 1.200 |
| Konteks 1 permintaan | 64k token |
| State plus pertanyaan terpanjang | 32k token |
Permintaan yang melewati batas laju menerima status 429. SDK resmi mengulang dengan jeda bertambah dan membaca header retry-after. Sumber: halaman models TypeSafe.
Pada audit kami, 8 sampai 12 permintaan serentak tidak pernah menyentuh batas itu.
Membandingkan biaya dengan pekerjaan manusia
Perbandingan yang adil bukan melawan model lain, melainkan melawan cara lama. Membaca 227 percakapan dengan tangan memakan waktu berjam-jam, dan penilaian berubah setelah percakapan ke-20.
Jalan mesin memakan 20,8 detik dan 0,0094 USD, dengan rubrik yang sama untuk seluruh antrean. Cerita lengkapnya ada pada panduan audit percakapan dengan Jev.
Rekomendasi Rama Digital: hitung biaya per keputusan, bukan biaya per bulan. Angka per keputusan yang di bawah 1 sen membuat Anda berani memasang penjaga pada tiap giliran.
Bagian mana yang membuat 1 permintaan menjadi mahal
Satu permintaan memuat 3 bagian yang ditagih. Memahami porsinya membuat Anda tahu bagian mana yang layak dipangkas.
| Bagian | Porsi khas | Cara memangkas |
|---|---|---|
| State | 70% sampai 90% | Saring isinya, kirim bidang yang dipakai pertanyaan saja |
| Instruksi pertanyaan | 5% sampai 20% | Tulis 1 kalimat yang tepat, bukan 1 paragraf |
| Kriteria opsi | 5% sampai 15% | Pakai kalimat pendek untuk tiap opsi, bukan contoh panjang |
Porsi di atas berasal dari permintaan kami sendiri pada audit 20 September 2026. Bila state Anda berupa percakapan panjang, porsinya bergeser lebih jauh ke state.
Satu pola menghemat paling banyak: jangan mengirim percakapan penuh untuk menilai 1 balasan. Kirim pertanyaan pengunjung dan balasan yang dinilai saja. Pada audit kami, permintaan tingkat balasan memakai sekitar 800 token, sedangkan permintaan tingkat percakapan memakai sampai 3.000 token.
Anggaran untuk 3 ukuran bisnis
Tiga skenario berikut memakai ukuran state 800 token per keputusan. Angkanya perkiraan bulanan, dan ukuran catatan Anda menentukan hasil akhirnya.
| Skenario | Keputusan per bulan | Token masuk | Biaya per bulan |
|---|---|---|---|
| Toko kecil, 1 kanal chat | 3.000 | 2,4 juta | 0,10 USD |
| Bisnis menengah, 3 kanal | 30.000 | 24 juta | 1,01 USD |
| Agensi, 20 klien | 300.000 | 240 juta | 10,08 USD |
Perhatikan bahwa skenario agensi tetap berada di bawah 11 USD per bulan. Pada ukuran ini, biaya bukan lagi pertimbangan utama; mutu rubrik yang menentukan hasilnya.
Kesalahan hitung yang sering terjadi
Tiga kesalahan berikut membuat perkiraan meleset jauh, dan seluruhnya mudah dihindari.
- Menghitung per pertanyaan, bukan per permintaan. Dua belas pertanyaan pada 1 panggilan memakai 1 kali biaya state, bukan 12 kali.
- Lupa menghitung kriteria. Daftar opsi yang panjang ikut menjadi token masuk, jadi opsi dengan contoh panjang menaikkan tagihan tiap permintaan.
- Memakai perkiraan kata, bukan token. Satu kata bahasa Indonesia sering menjadi lebih dari 1 token, jadi bacalah kolom
usage, bukan jumlah kata.
Cara paling aman tetap sama: jalankan 10 catatan contoh, baca angka nyatanya, lalu kalikan. Perkiraan dari 10 catatan memberi gambaran yang jauh lebih dekat daripada hitungan di atas kertas.
Satu hal lagi yang mudah terlewat. Catatan yang gagal diproses tetap memakai token masuk, karena teksnya sudah terkirim. Jadi saring catatan kosong dan catatan rusak dengan kode sebelum permintaan dibuat.
Pertanyaan yang sering muncul
Apakah ada biaya bulanan? Halaman harga resmi hanya menyebut harga per token masuk. Periksa halaman itu sebelum Anda menyusun anggaran, karena harga dapat berubah.
Mengapa token keluar gratis? Jev tidak menghasilkan teks. Keluarannya hanya angka dan pilihan, sehingga panjangnya kecil dan tetap.
Bagaimana menghitung biaya sebelum menjalankan? Kirim 10 catatan contoh, baca usage.input_tokens, lalu kalikan dengan jumlah catatan Anda. Perkiraan itu meleset kecil bila ukuran catatan Anda seragam.
Apakah pertanyaan tambahan menambah biaya? Menambah pertanyaan menambah token instruksi, dan itu kecil. Yang membesar adalah state, jadi tumpuk pertanyaan dan jaga statenya tetap ramping.
Berapa biaya memasang penjaga pada tiap giliran chat? Pada ukuran balasan kami, 1 penjaga berharga sekitar 0,00003 USD per giliran. Seribu giliran berhenti di bawah 0,05 USD.
Langkah berikutnya
Batas yang tersisa: angka biaya tidak menjamin mutu jawaban. Rubrik yang buruk tetap menghasilkan keputusan yang buruk, walaupun murah. Kami membahas cara memeriksa klaim sebelum dipakai pada Apa itu meat proxy.
Bila Anda ingin kami menghitung titik keputusan mana yang layak diotomasi lebih dulu, buka AI Diagnostic. Untuk membahasnya lebih dulu, pilih jadwal sesi AI Diagnostic.