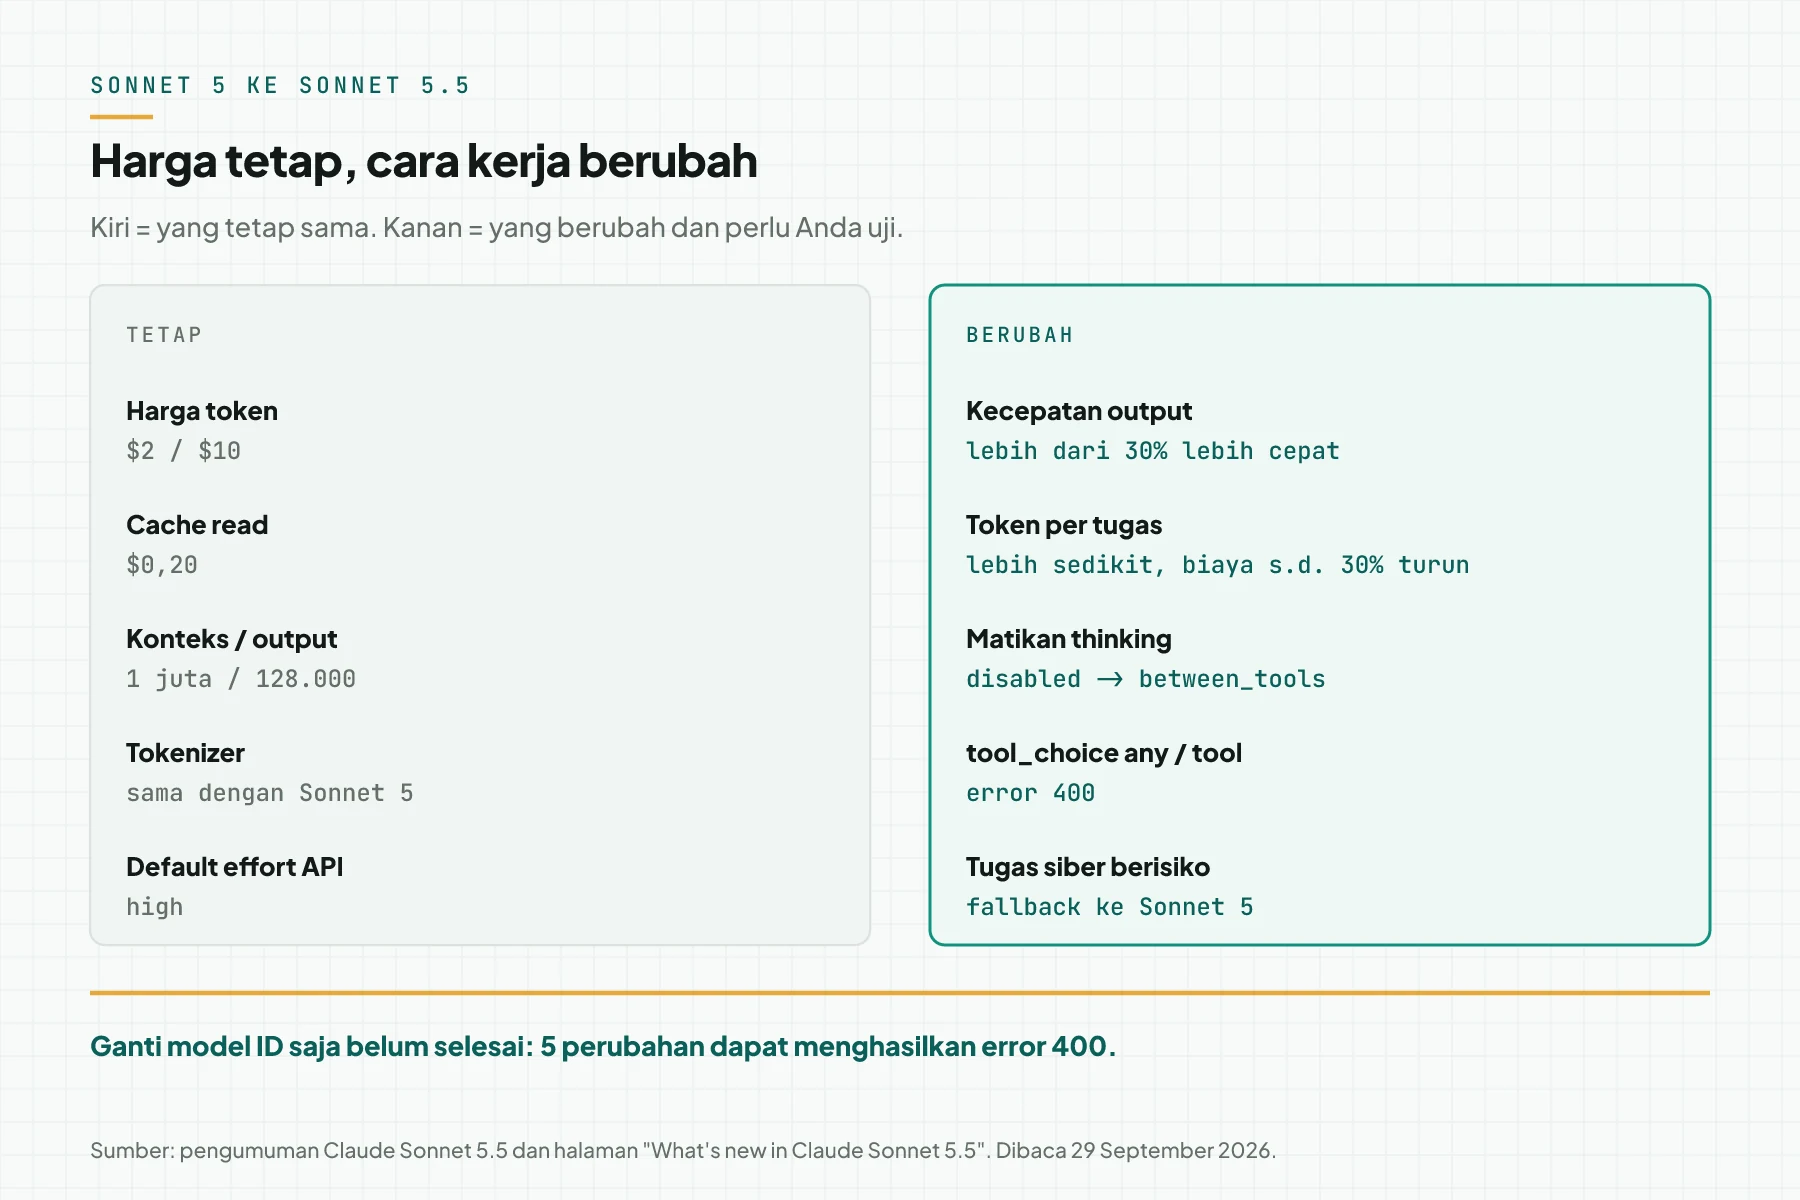
Jawaban langsung: ClaudeClaude ProLangganan berbayar asisten AI Claude dari Anthropic. Langganan ini membuka connector ke alat luar.Buka glosarium Sonnet 5.5 adalah model kedua keluarga Claude 5.5, rilis 28 September 2026. Harganya sama dengan Sonnet 5: $2 input dan $10 output per 1 juta token. Anthropic menulis bahwa output Sonnet 5.5 lebih dari 30% lebih cepat. Biaya per tugas juga turun sampai 30%, karena model memakai lebih sedikit token dan panggilan tool.
Kondisi utama: penghematan itu datang dari token per tugas, bukan dari harga token, jadi ukur di data Anda sendiri. Migrasi dari Sonnet 5 memerlukan 6 langkah, karena 5 breaking changes langsung menghasilkan error 400. Batas: permintaan siber yang berisiko dialihkan ke Sonnet 5, dan Opus 5.5 tetap lebih kuat untuk tugas terbuka yang butuh penilaian panjang.
Pada 29 September 2026 kami membaca pengumuman Anthropic, halaman model, halaman What's new, panduan migrasi, dan halaman refusal. Kami juga membaca halaman model Artificial Analysis. Pada hari yang sama kami menguji Sonnet 5 dan Sonnet 5.5 dengan prompt sama dan data dummy: 36 panggilan untuk 5 tugas.
Kenapa ganti model ID saja belum selesai
Banyak tim mengganti claude-sonnet-5 menjadi claude-sonnet-5-5, lalu menganggap migrasi selesai. Pada Sonnet 5.5, pola itu gagal bila kode Anda mematikan thinking dengan disabled atau memaksa tool dengan tool_choice. Kedua permintaan itu kini menjawab error 400.
Masalah kedua tidak menghasilkan error. Teks di antara panggilan tool kini datang sebagai blok thinking yang kosong secara default. Jadi layar progres agentAgent AIProgram AI yang mengerjakan langkah pekerjaan sendiri, misalnya membaca pesan, menyiapkan balasan, lalu mencatat hasilnya.Buka glosarium Anda dapat diam tanpa pesan apa pun.
Pola ini sama dengan migrasi Opus 5.5 minggu lalu. Bila Anda sudah membaca panduan migrasi Claude Opus 5.5, sebagian besar langkah di bawah akan terasa akrab.
Apa yang baru di Claude Sonnet 5.5
Anthropic memposisikan Sonnet 5.5 sebagai rekan kerja yang lebih cepat dan lebih murah untuk Opus 5.5. Sonnet 5.5 kuat untuk tugas harian yang jelas: perbaikan bug, dokumen, slide, dan spreadsheet. Sumber: pengumuman Claude Sonnet 5.5.
Harga dan spesifikasi
| Item | Claude Sonnet 5 | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|---|
| ID APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium | claude-sonnet-5 | claude-sonnet-5-5 | claude-opus-5-5 |
| Input / output per 1 juta token | $2 / $10 | $2 / $10 | $4 / $20 |
| Cache write 5 menit / cache read | $2,50 / $0,20 | $2,50 / $0,20 | $5 / $0,20 |
| Konteks / output maksimal | 1 juta / 128.000 token | 1 juta / 128.000 token | 1 juta / 128.000 token |
| Default effort di API | high | high | medium |
| Cara mematikan thinking | disabled | between_tools | tidak dapat |
| Prompt minimal untuk cache | 1.024 token | 512 token | lihat halaman model |
Sumber: halaman model Claude Sonnet 5.5, halaman What's new in Claude Sonnet 5.5, dan ringkasan model Claude, dibaca 29 September 2026. Tokenizer Sonnet 5.5 sama dengan Sonnet 5, jadi teks yang sama menghasilkan jumlah token yang sama.
Di Claude Code dan aplikasi Claude, default effort adalah medium. Di Claude Platform, default effort adalah high. Sonnet 5.5 tersedia di Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, dan Claude Platform on AWS.
Benchmark menurut Anthropic
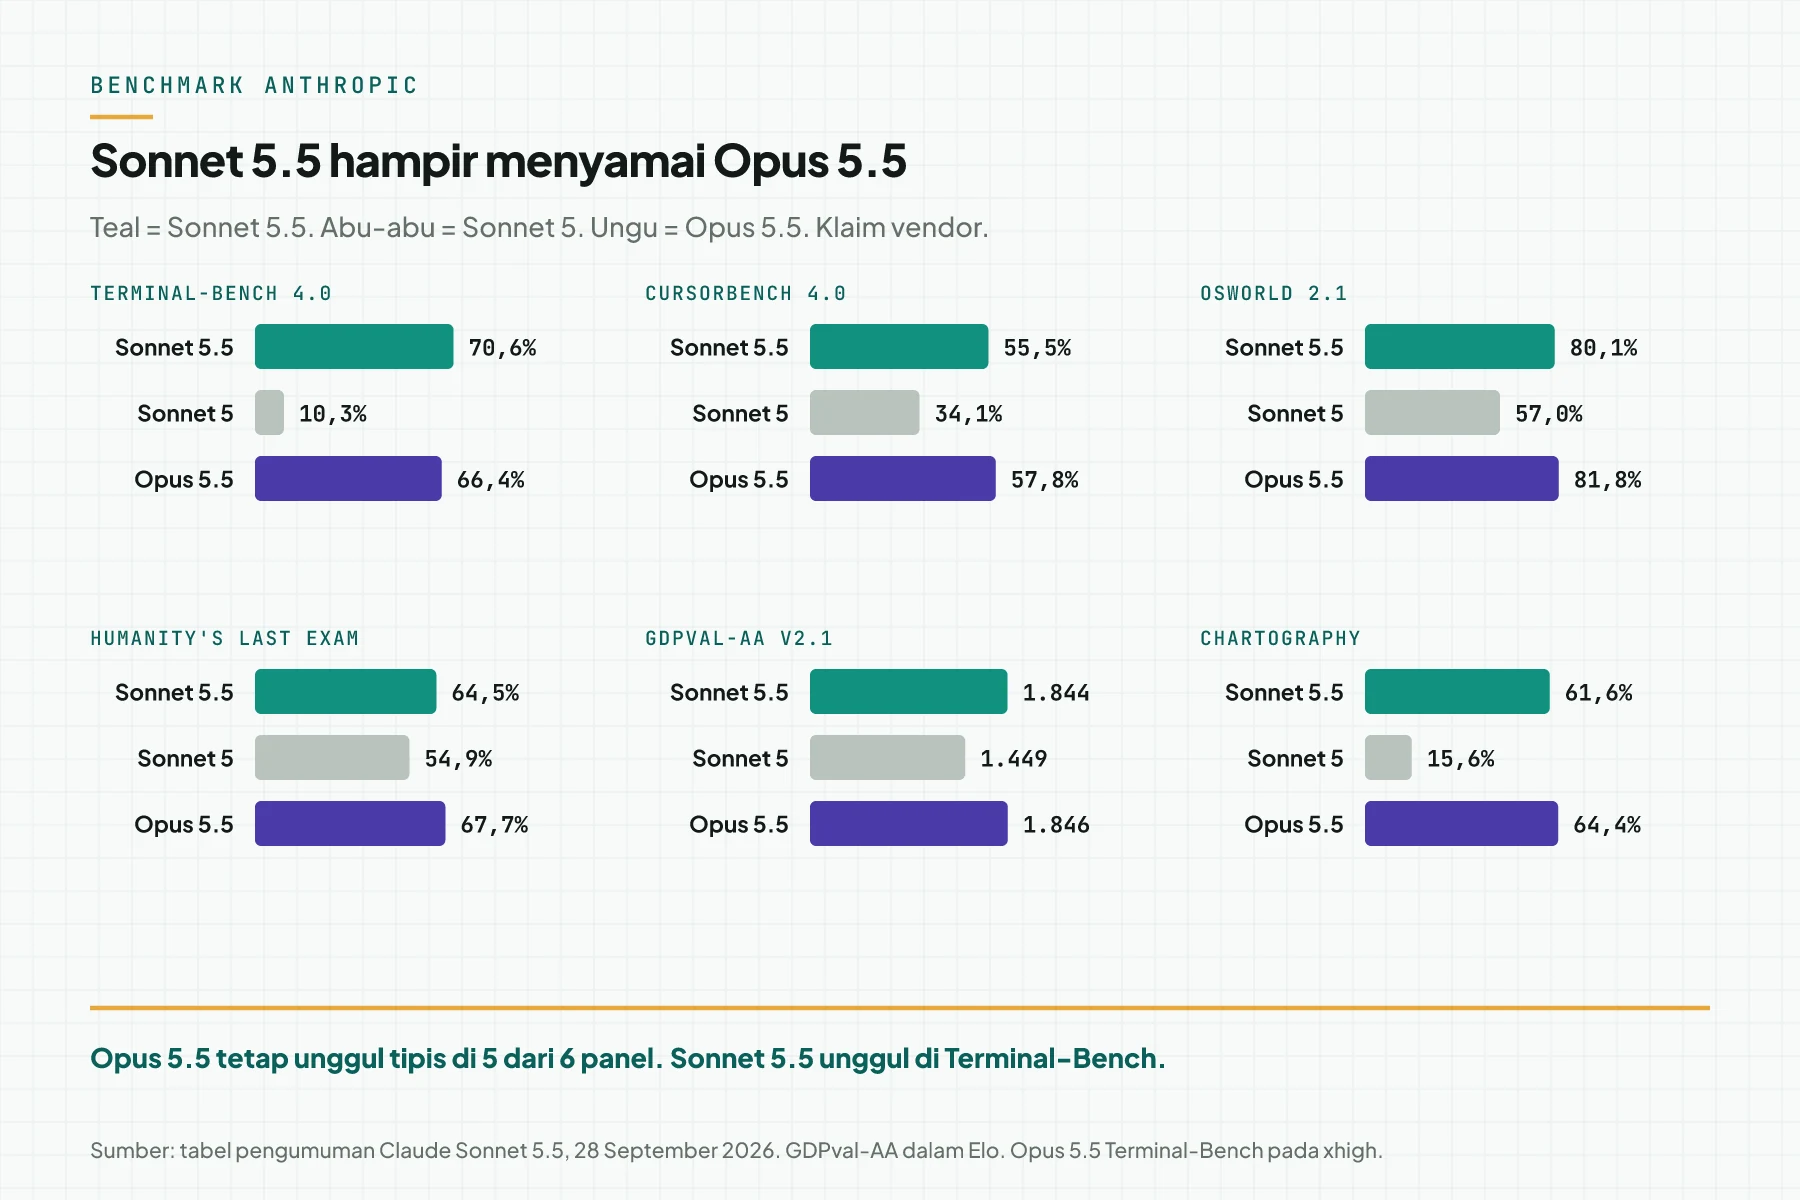
- Terminal-Bench 4.0: 70,6%, di atas Opus 5.5 xhigh 66,4%. Tabel Anthropic mencatat Sonnet 5 hanya 10,3% tanpa catatan kaki, jadi anggap selisih ini dengan hati-hati.
- CursorBench 4.0: 55,5%, naik dari 34,1% dan 2,3 poin di bawah Opus 5.5.
- OSWorld 2.1 partial: 80,1%, naik dari 57,0%.
- GDPval-AA v2.1: 1.844 Elo, sekitar 400 poin di atas Sonnet 5 dan 2 poin di bawah Opus 5.5.
Anthropic juga menulis bahwa Sonnet 5.5 pada effort low atau medium dapat mengalahkan skor tertinggi Sonnet 5 dengan sekitar sepersepuluh biaya per tugas. Pada FrontierCode, Sonnet 5.5 max mencetak 46,2%, lebih rendah dari xhigh 52,1%, karena max lebih sering menjalankan subagent review sampai timeout.
Uji independen
Artificial Analysis mencatat Sonnet 5.5 max effort dengan skor Intelligence Index 56, peringkat 3 dari 216 model. Kecepatan output 141,9 token per detik. Pada halaman Sonnet 5, skor Sonnet 5 max effort adalah 38 dengan kecepatan 76,8 token per detik.
Biaya per tugas indeks naik dari $5,09 ke $7,60 pada max effort, karena Sonnet 5.5 max memakai 410 juta token output untuk seluruh indeks. Jadi hemat 30% hanya berlaku bila Anda memilih effort lebih rendah dari max.
Uji Rama Digital: prompt sama, 2 model
Pada uji kami, 29 September 2026, kami mengirim 5 tugas bisnis dengan data dummy, masing-masing 3 kali per model. Tugasnya: hitung invoice dengan diskon dan PPN, ekstraksi JSON dari chat, perbaikan bug Python, balasan WhatsApp dengan 4 aturan, dan pertanyaan tentang model yang belum rilis. Setiap jawaban diperiksa oleh kode, bukan oleh penilaian rasa.
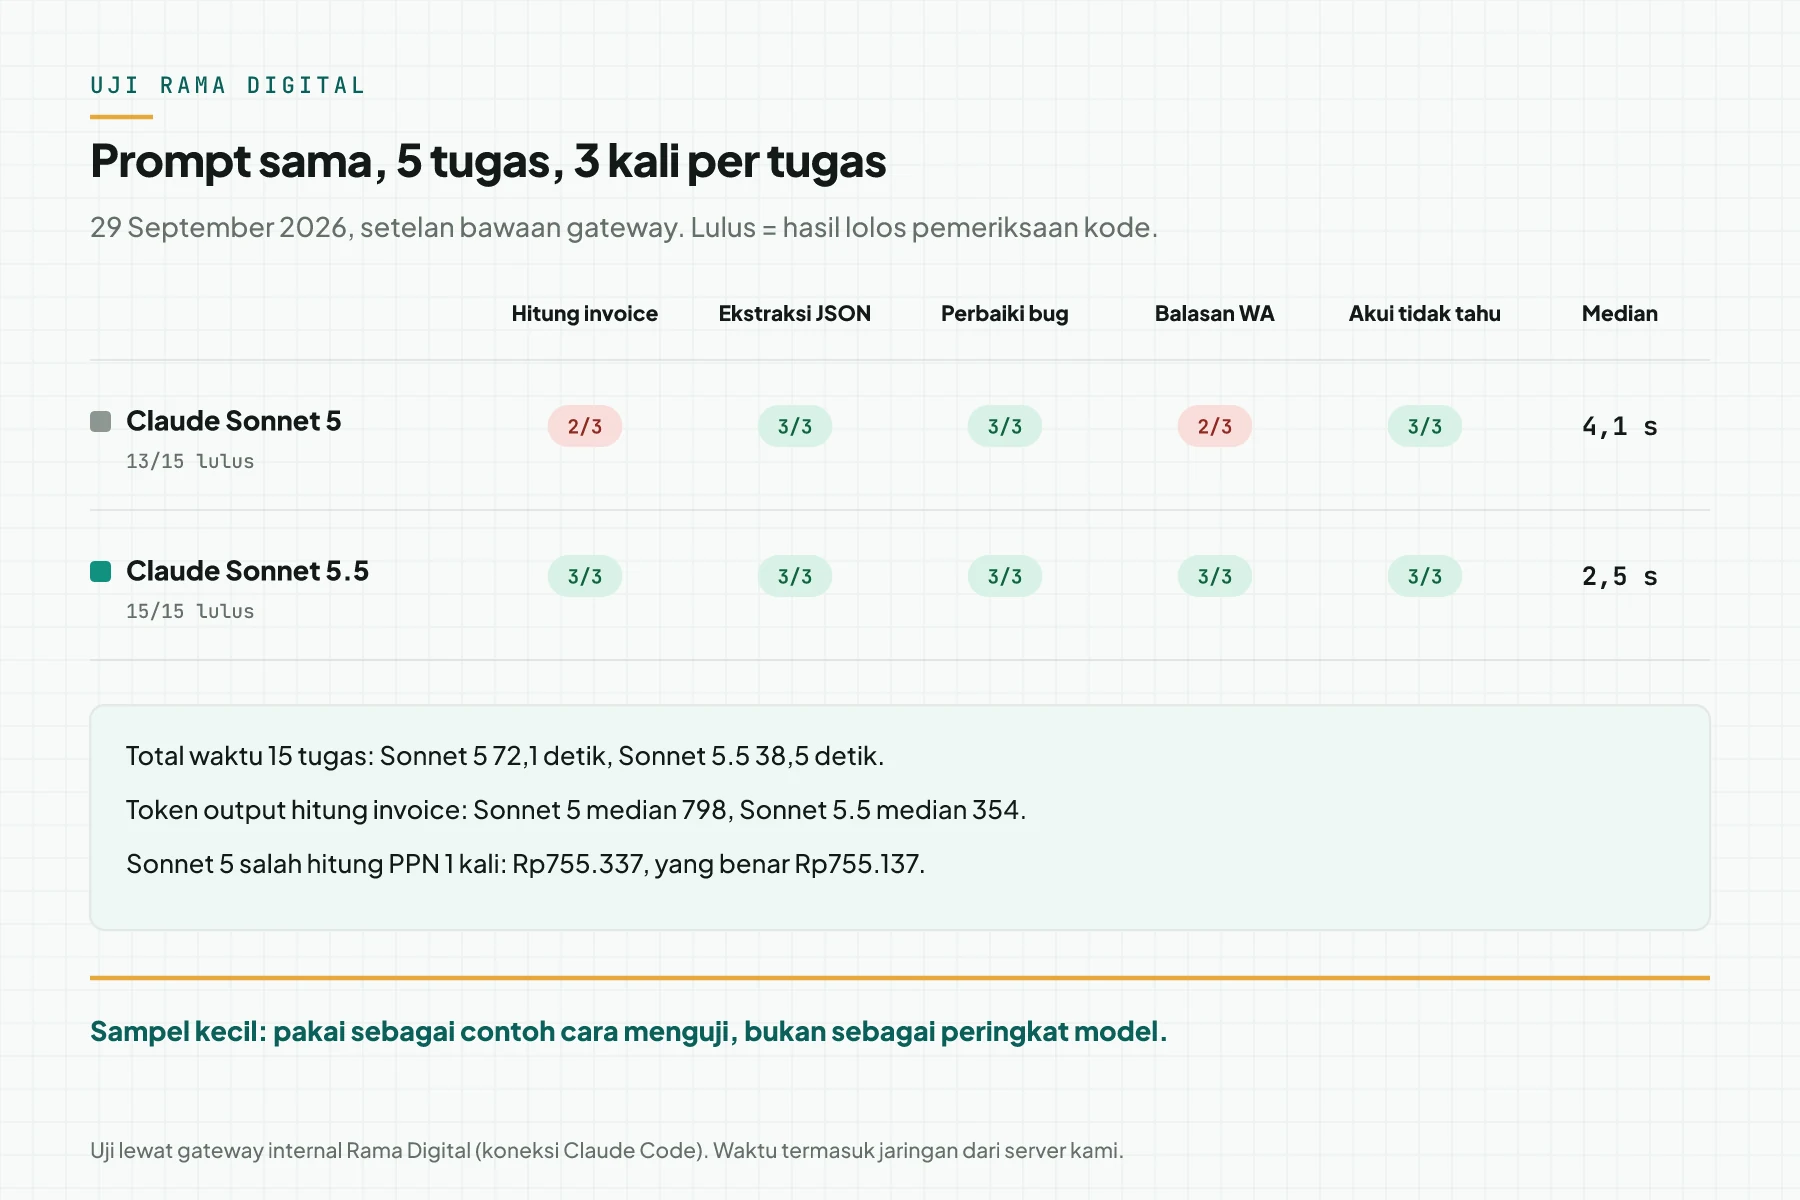
- Sonnet 5.5 lulus 15 dari 15. Sonnet 5 lulus 13 dari 15.
- Waktu total 15 tugas: Sonnet 5 72,1 detik, Sonnet 5.5 38,5 detik, jadi 47% lebih singkat.
- Sonnet 5 salah menghitung PPN 1 kali pada setelan bawaan dan 1 kali pada effort low. Nilainya Rp755.337, yang benar Rp755.137.
- Pada hitung invoice, median token output Sonnet 5.5 adalah 354, Sonnet 5 adalah 798.
- 1 balasan WhatsApp Sonnet 5 menambah emoji setelah pertanyaan penutup, jadi gagal aturan "akhiri dengan 1 pertanyaan".
Kami menguji lewat gateway internal dengan koneksi Claude Code, jadi waktu termasuk jaringan dari server kami. Sampel ini kecil. Pakai sebagai contoh cara menguji, bukan sebagai peringkat model.
Safeguard siber dan fallback ke Sonnet 5
Kemampuan siber Sonnet 5.5 setara Opus 5, menurut Anthropic. Karena itu Sonnet 5.5 adalah Sonnet pertama yang rilis dengan safeguard siber. Permintaan siber berisiko tinggi dialihkan ke Sonnet 5 secara terlihat, sedangkan perbaikan bug rutin tidak terpengaruh.
- Refusal datang sebagai HTTP 200 dengan
stop_reason: "refusal"dan objekstop_details. - Ada 5 kategori:
cyber,bio,frontier_llm,reasoning_extraction, dangeneral_harms. - Tim keamanan dapat mendaftar Cyber Verification Program. Tim riset biologi dapat mendaftar Life Sciences Verification Program.
Anthropic juga menambahkan classifier anti-distilasi. Blok thinking Sonnet 5.5 hanya berlaku di akun yang membuatnya. Untuk kewajiban label konten AI di Eropa, baca artikel watermark Claude dan EU AI Act.
Sonnet 5.5, Opus 5.5, atau Haiku 4.5
Harga Opus 5.5 2x Sonnet 5.5, dan Haiku 4.5 setengah harga Sonnet 5.5. Tabel ini membandingkan ketiganya dari halaman resmi Anthropic.
| Atribut | Claude Haiku 4.5 | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|---|
| Posisi menurut Anthropic | model tercepat | kombinasi kecepatan dan kecerdasan | agenticAgenticCara kerja saat tugas rutin dikerjakan agent AI, lalu staf atau owner memeriksa dan menyetujui hasilnya.Buka glosarium coding dan knowledge work panjang |
| Input / output per 1 juta token | $1 / $5 | $2 / $10 | $4 / $20 |
| Konteks / output maksimal | 200.000 / 64.000 token | 1 juta / 128.000 token | 1 juta / 128.000 token |
| Latensi relatif | tercepat | cepat | sedang |
| Batas pengetahuan | Februari 2025 | Juni 2026 | Juni 2026 |
| Pensiun paling cepat | 15 Oktober 2026 | 28 September 2027 | 22 September 2027 |
Sumber: ringkasan model Claude, dibaca 29 September 2026. Haiku 4.5 dapat pensiun paling cepat 15 Oktober 2026, dan Anthropic menulis bahwa Haiku 5.5 menyusul dalam beberapa minggu.
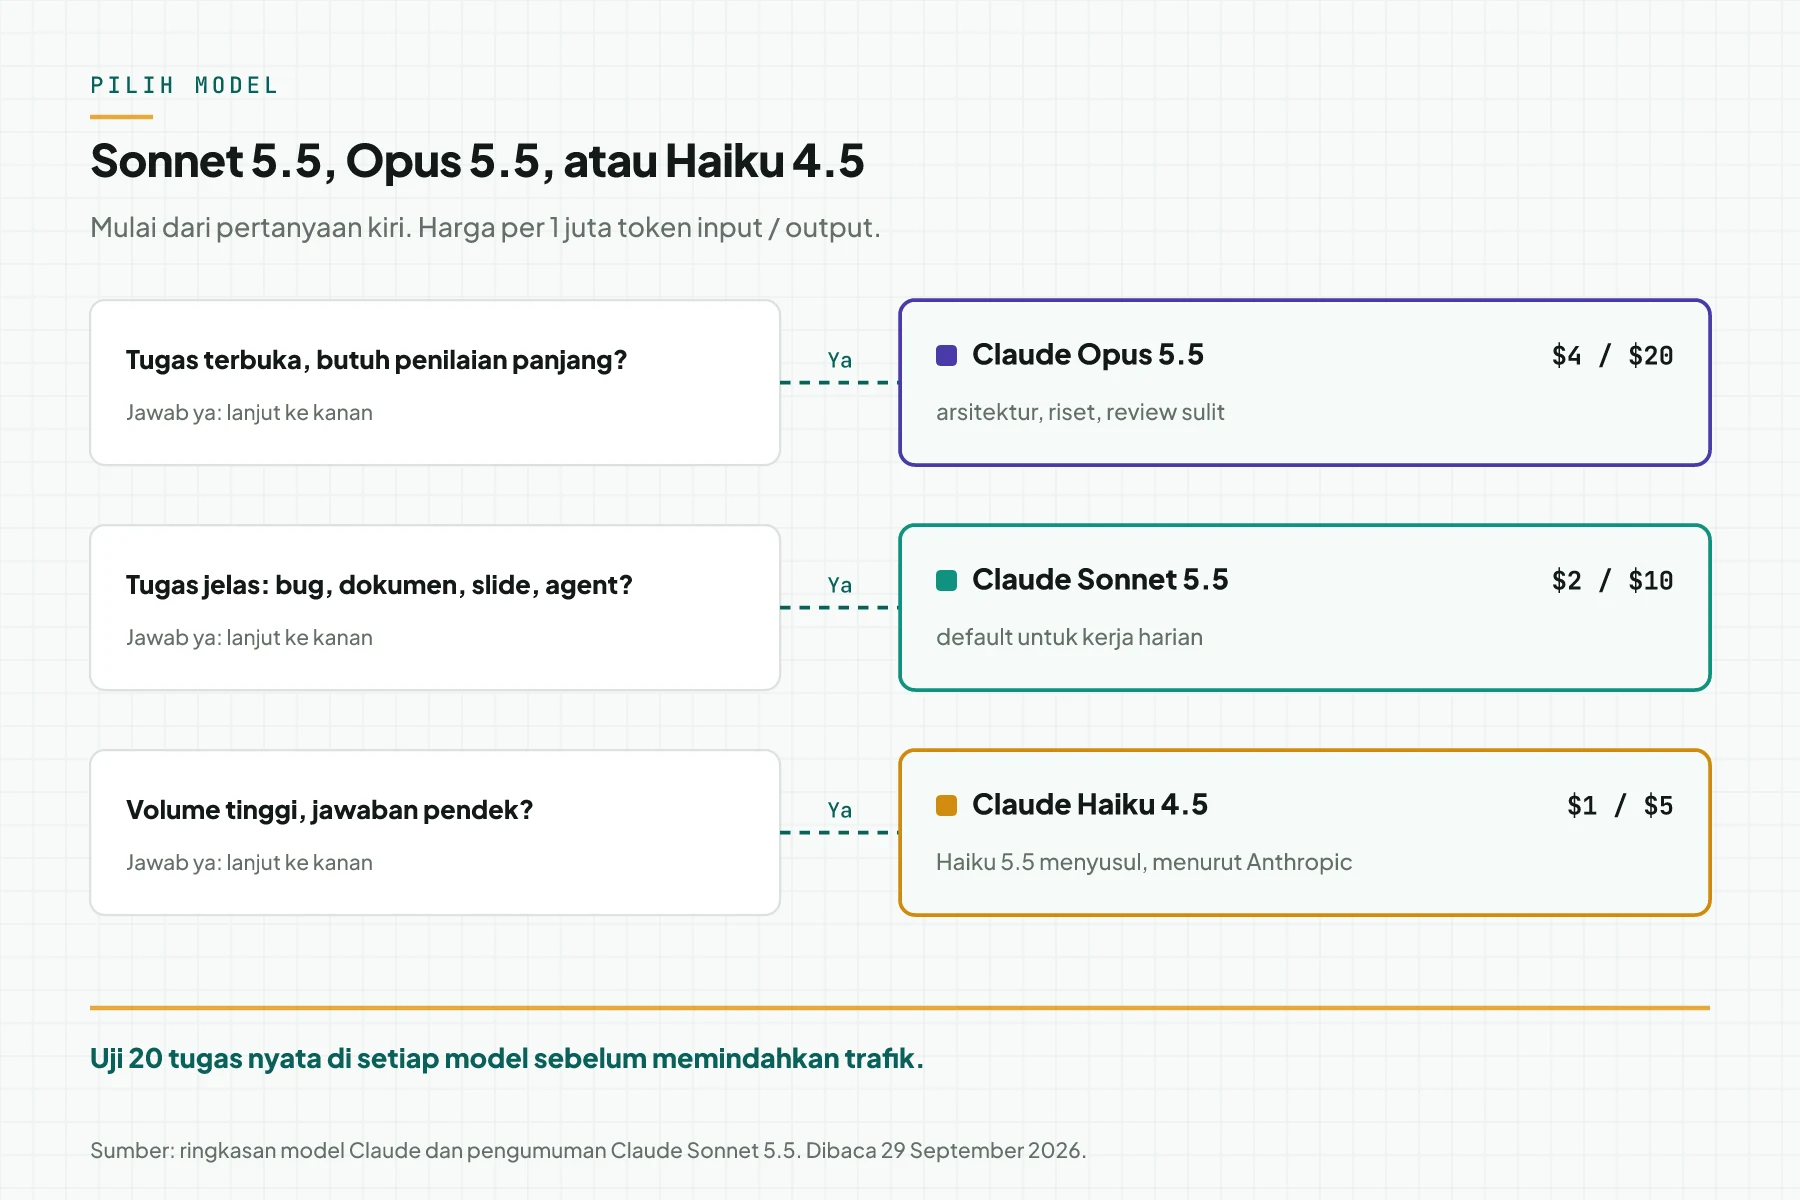
Rekomendasi Rama Digital: jadikan Sonnet 5.5 model default untuk agent dan otomasi yang tugasnya jelas, bila uji 20 tugas nyata Anda lulus. Pakai Opus 5.5 untuk desain arsitektur, riset, dan review yang butuh penilaian panjang. Untuk tugas volume tinggi dengan harga paling rendah, bandingkan dulu di perbandingan 4 model AI murah.
Yang perlu Anda siapkan
- Akses Claude API atau platform cloud yang sudah memuat
claude-sonnet-5-5. - SDK Anthropic versi terbaru dan lingkungan staging.
- 20 tugas nyata beserta jawaban benar, dari alur kerja yang akan Anda pindahkan.
- Daftar semua tempat kode Anda memakai
thinking,tool_choice, computer use, dan advisor tool. - Log token per tugas dari Sonnet 5 selama 7 hari, sebagai garis dasar biaya.
Anthropic menyediakan skill otomatis di Claude Code: /claude-api migrate this project to claude-sonnet-5-5. Skill itu mengganti model ID, mengubah parameter, lalu memberi checklist untuk Anda periksa manual.
Langkah 1: Ganti model ID dan tulis effort secara eksplisit
Ubah model ke claude-sonnet-5-5 di konfigurasi, lalu tulis output_config.effort di setiap permintaan. Level effort Sonnet 5.5 dikalibrasi ulang, jadi 1 level tidak menghasilkan jumlah thinking yang sama dengan Sonnet 5.
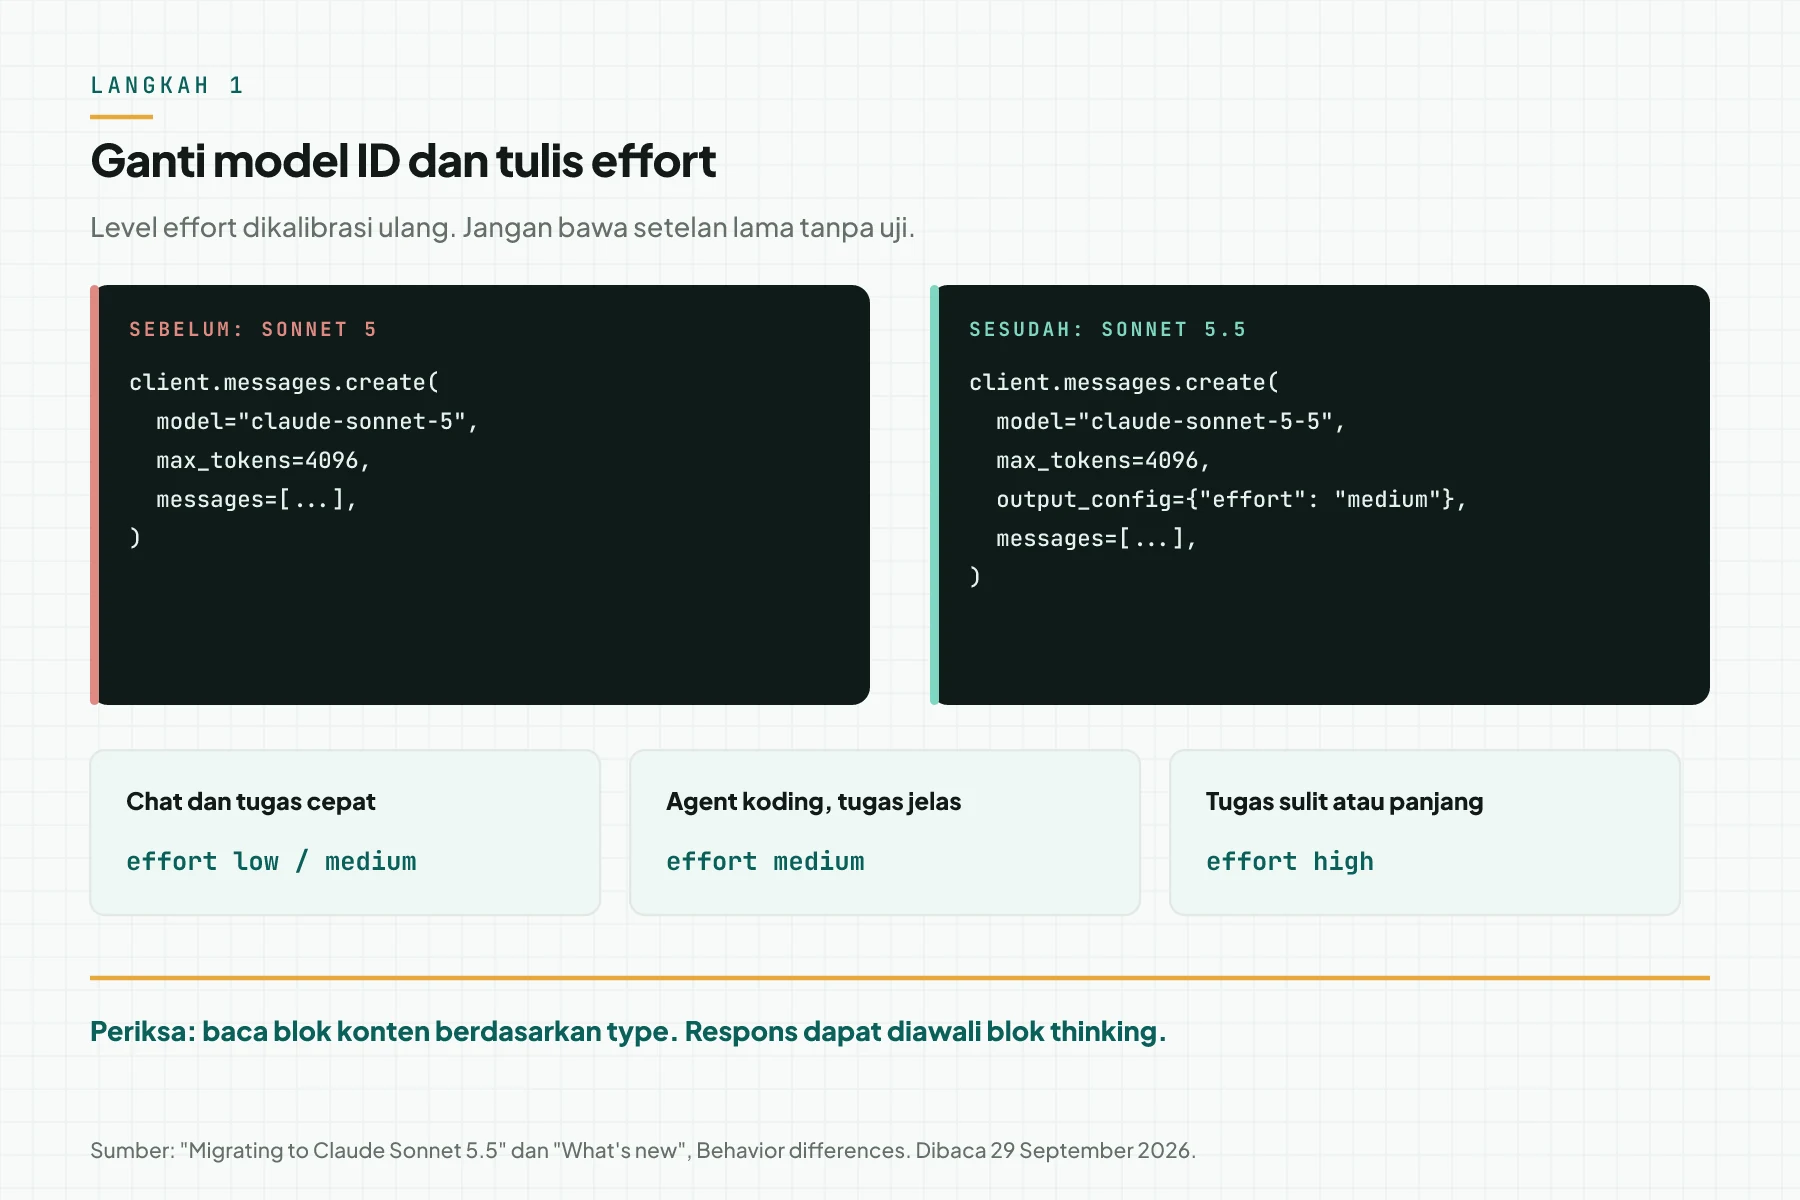
Titik awal dari Anthropic: high untuk tugas umum, medium untuk agent koding dengan tugas jelas, dan low atau medium untuk chat. Respons dapat diawali blok thinking, jadi baca blok konten berdasarkan type, bukan content[0].text.
Periksa: 20 tugas staging menjawab 200, dan skor lulus tidak turun dari Sonnet 5. Sumber: panduan Migrating to Claude Sonnet 5.5.
Langkah 2: Ganti thinking disabled dengan between_tools
Bila kode Anda mematikan thinking untuk menghemat token, ganti thinking: {"type": "disabled"} dengan thinking: {"type": "between_tools"}. Setelan ini mematikan thinking di awal, tetapi model tetap menulis catatan singkat di antara panggilan tool.
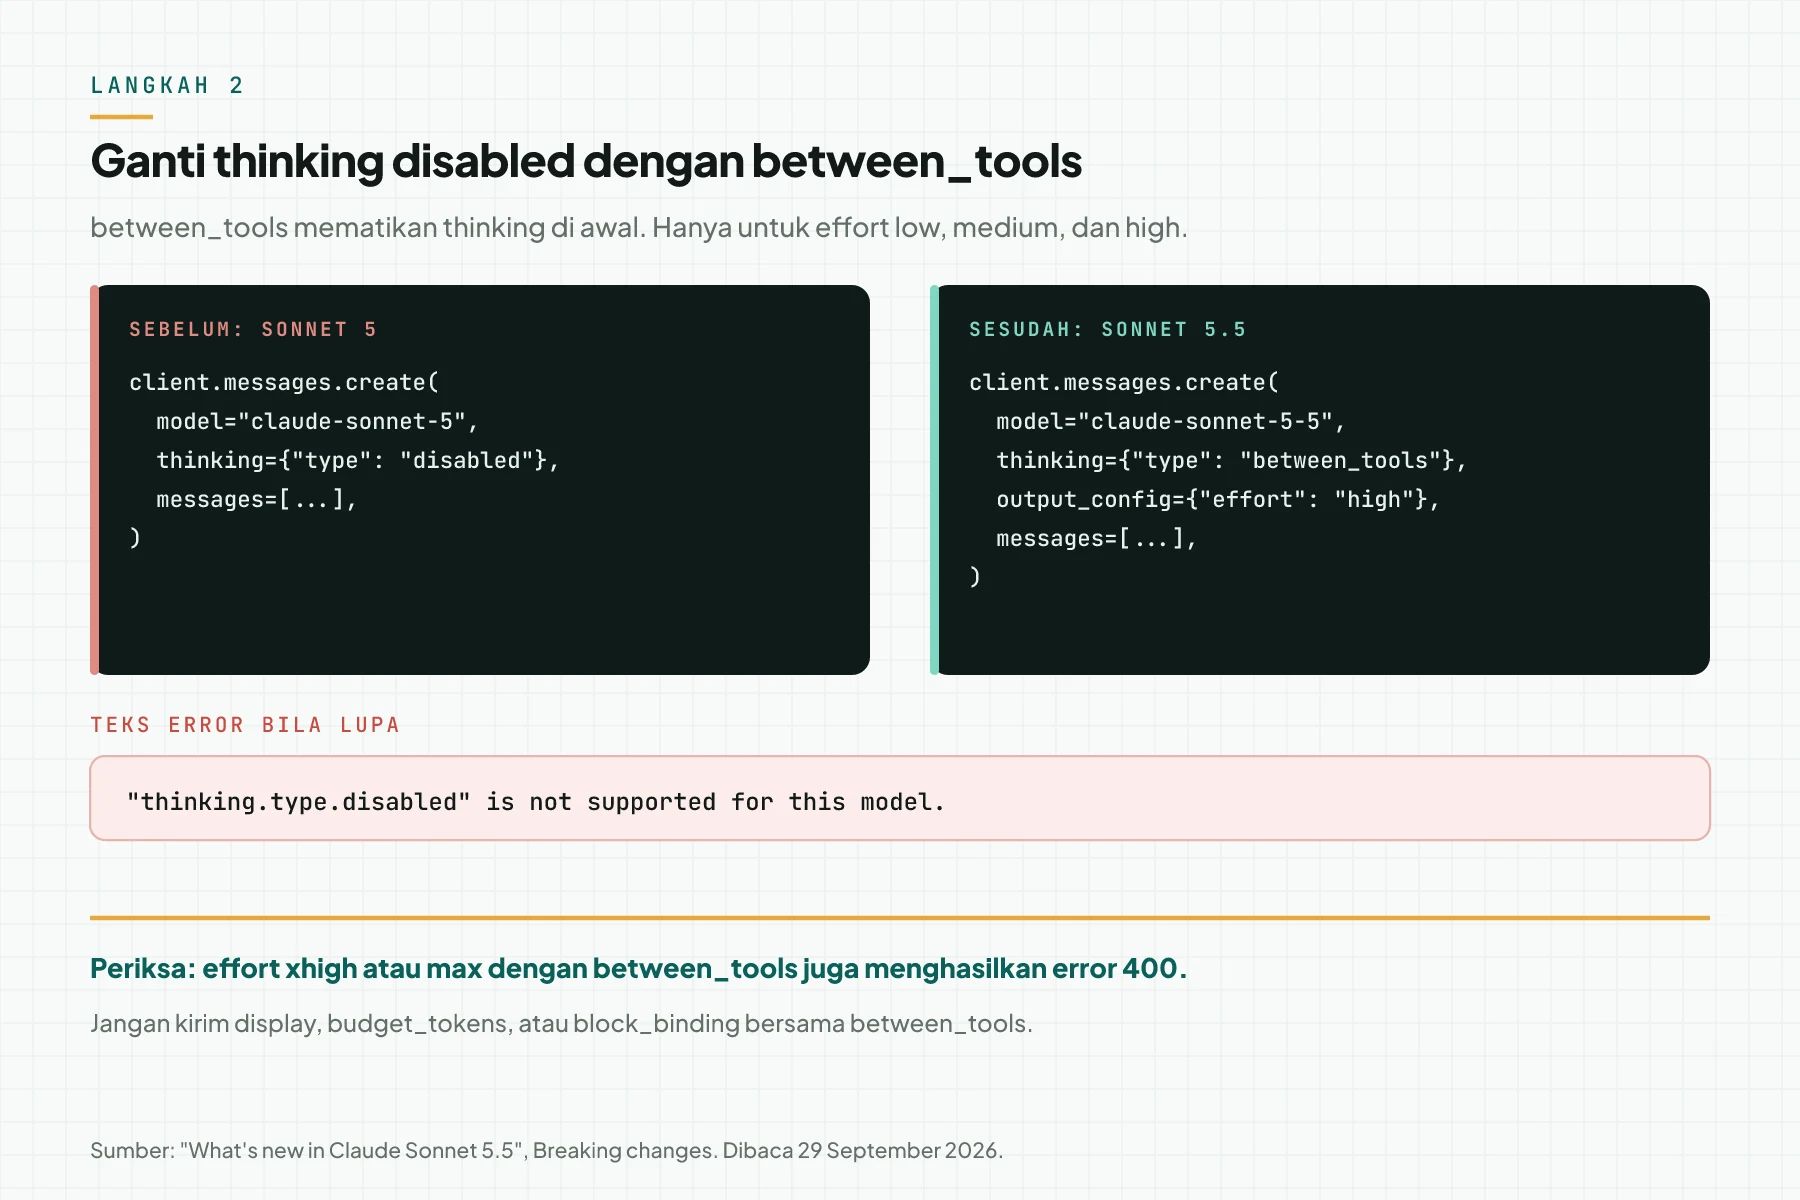
Bila field lama tetap terkirim, API menjawab 400 dengan teks "thinking.type.disabled" is not supported for this model. Jangan kirim display, budget_tokens, atau block_binding bersama between_tools, karena ketiganya juga menghasilkan error 400.
Periksa: permintaan dengan between_tools menjawab 200, dan effort tidak berubah di tengah percakapan. Sumber: What's new in Claude Sonnet 5.5.
Langkah 3: Ganti tool_choice any dan tool
Sonnet 5.5 menolak tool_choice bertipe any dan tool, termasuk di endpoint hitung token. Pakai auto dengan strict: true di setiap tool, lalu tulis di prompt kapan tool harus dipakai.
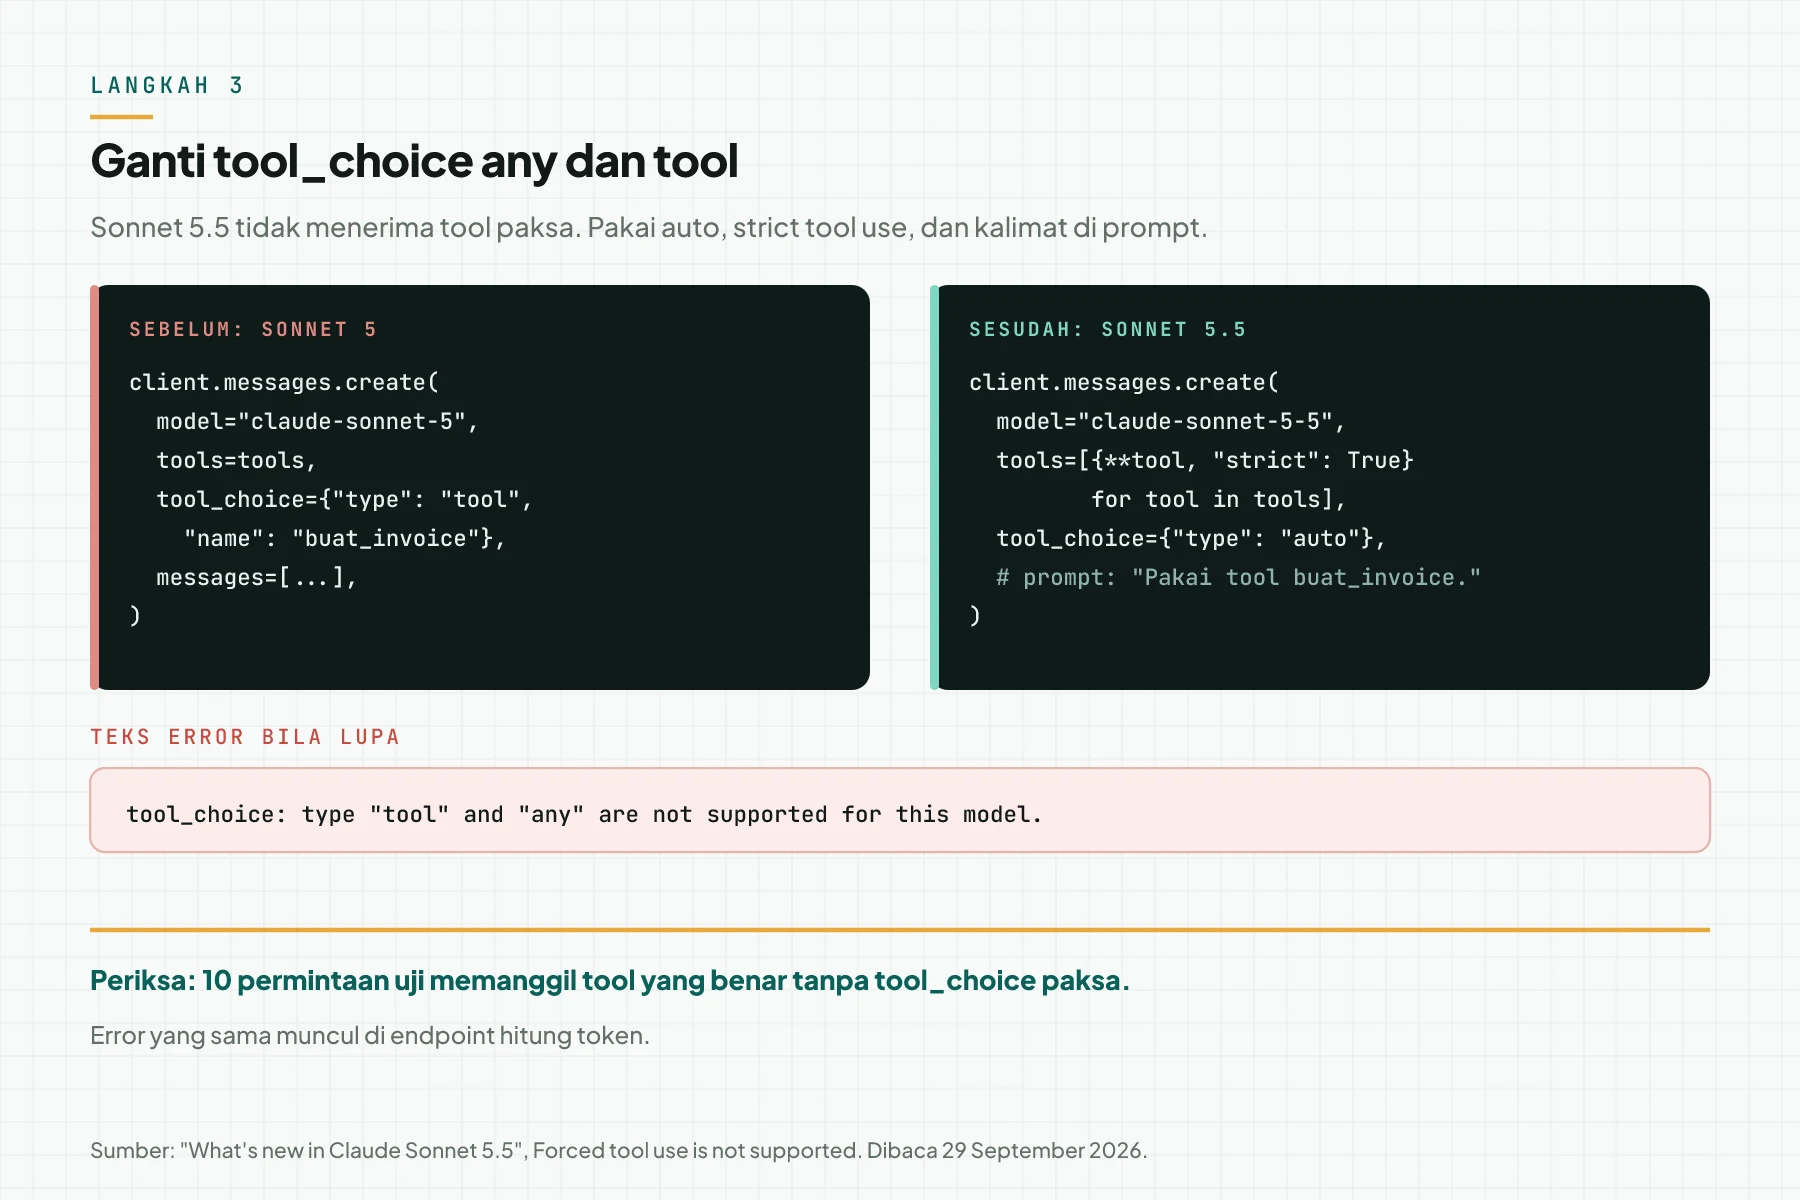
Teks error bila Anda lupa: tool_choice: type "tool" and "any" are not supported for this model. Bila Anda hanya butuh JSON sesuai skema tanpa tool, pindahkan skema ke structured outputs.
Periksa: 10 permintaan uji memanggil tool yang benar tanpa tool_choice paksa.
Langkah 4: Jaga percakapan append-only dan kembalikan teks progres
Setiap blok thinking mencatat model yang membuatnya. Sonnet 5.5 membaca blok dari Sonnet 5, Opus 4.8, dan Haiku 4.5, tetapi tidak dari Opus 5, Opus 5.5, Fable, atau Mythos. Tidak ada model lain yang membaca blok Sonnet 5.5.
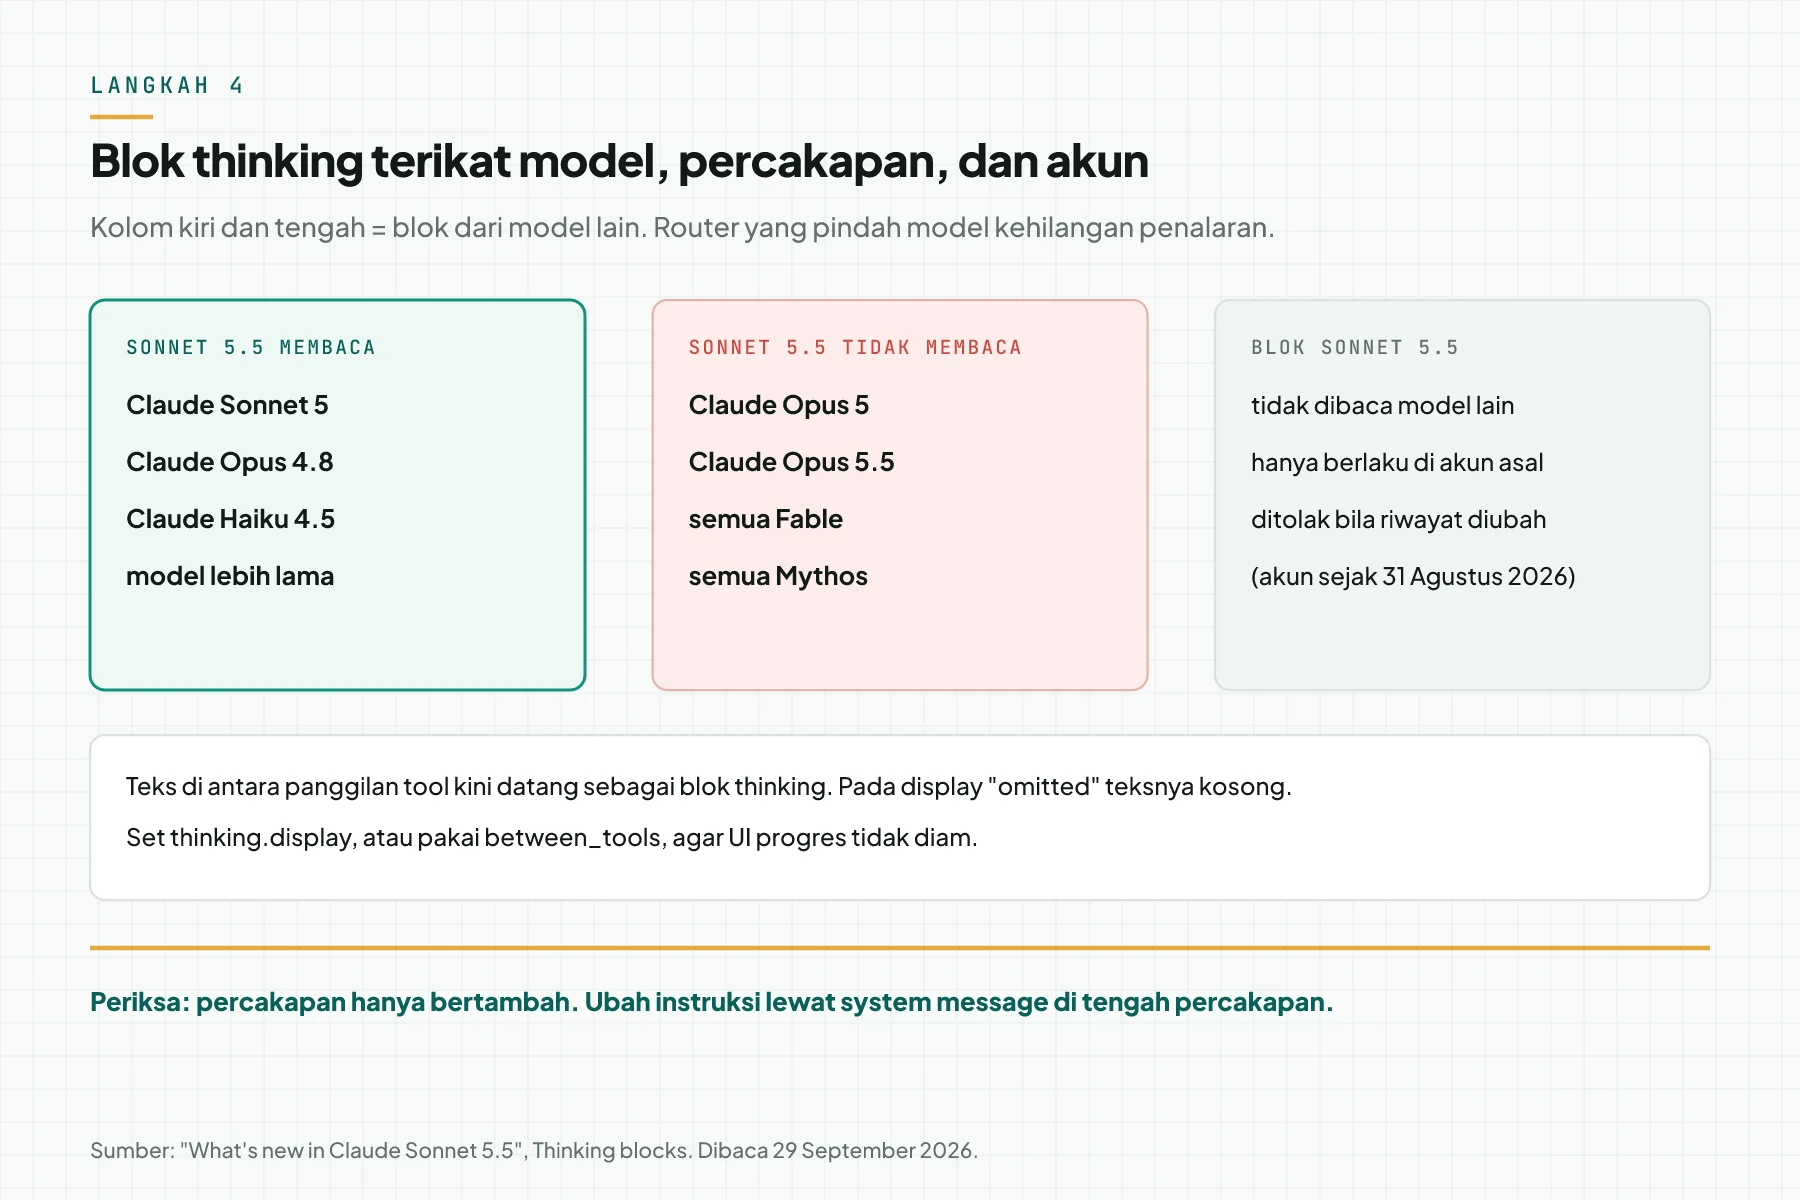
- Jangan ubah system prompt, tool, atau pesan lama di tengah percakapan. Untuk akun yang dibuat sejak 31 Agustus 2026, perubahan itu menghasilkan error 400 saat blok thinking diputar ulang.
- Ubah instruksi lewat mid-conversation system message.
- Kirim blok thinking kembali tanpa diubah bersama hasil tool.
- Set
thinking.displaybila UI Anda menampilkan teks progres. Denganbetween_tools, teks progres kembali tanpa setelan ini.
Periksa: UI menampilkan teks progres sebelum setiap panggilan tool, dan tidak ada error 400 pada percakapan 10 giliran.
Langkah 5 (opsional): Pindahkan computer use dan advisor tool
Lewati langkah ini bila Anda tidak memakai computer use atau advisor tool. Di Claude API dan Google Cloud, tool computer_20251124 menghasilkan error 400 di Sonnet 5.5.
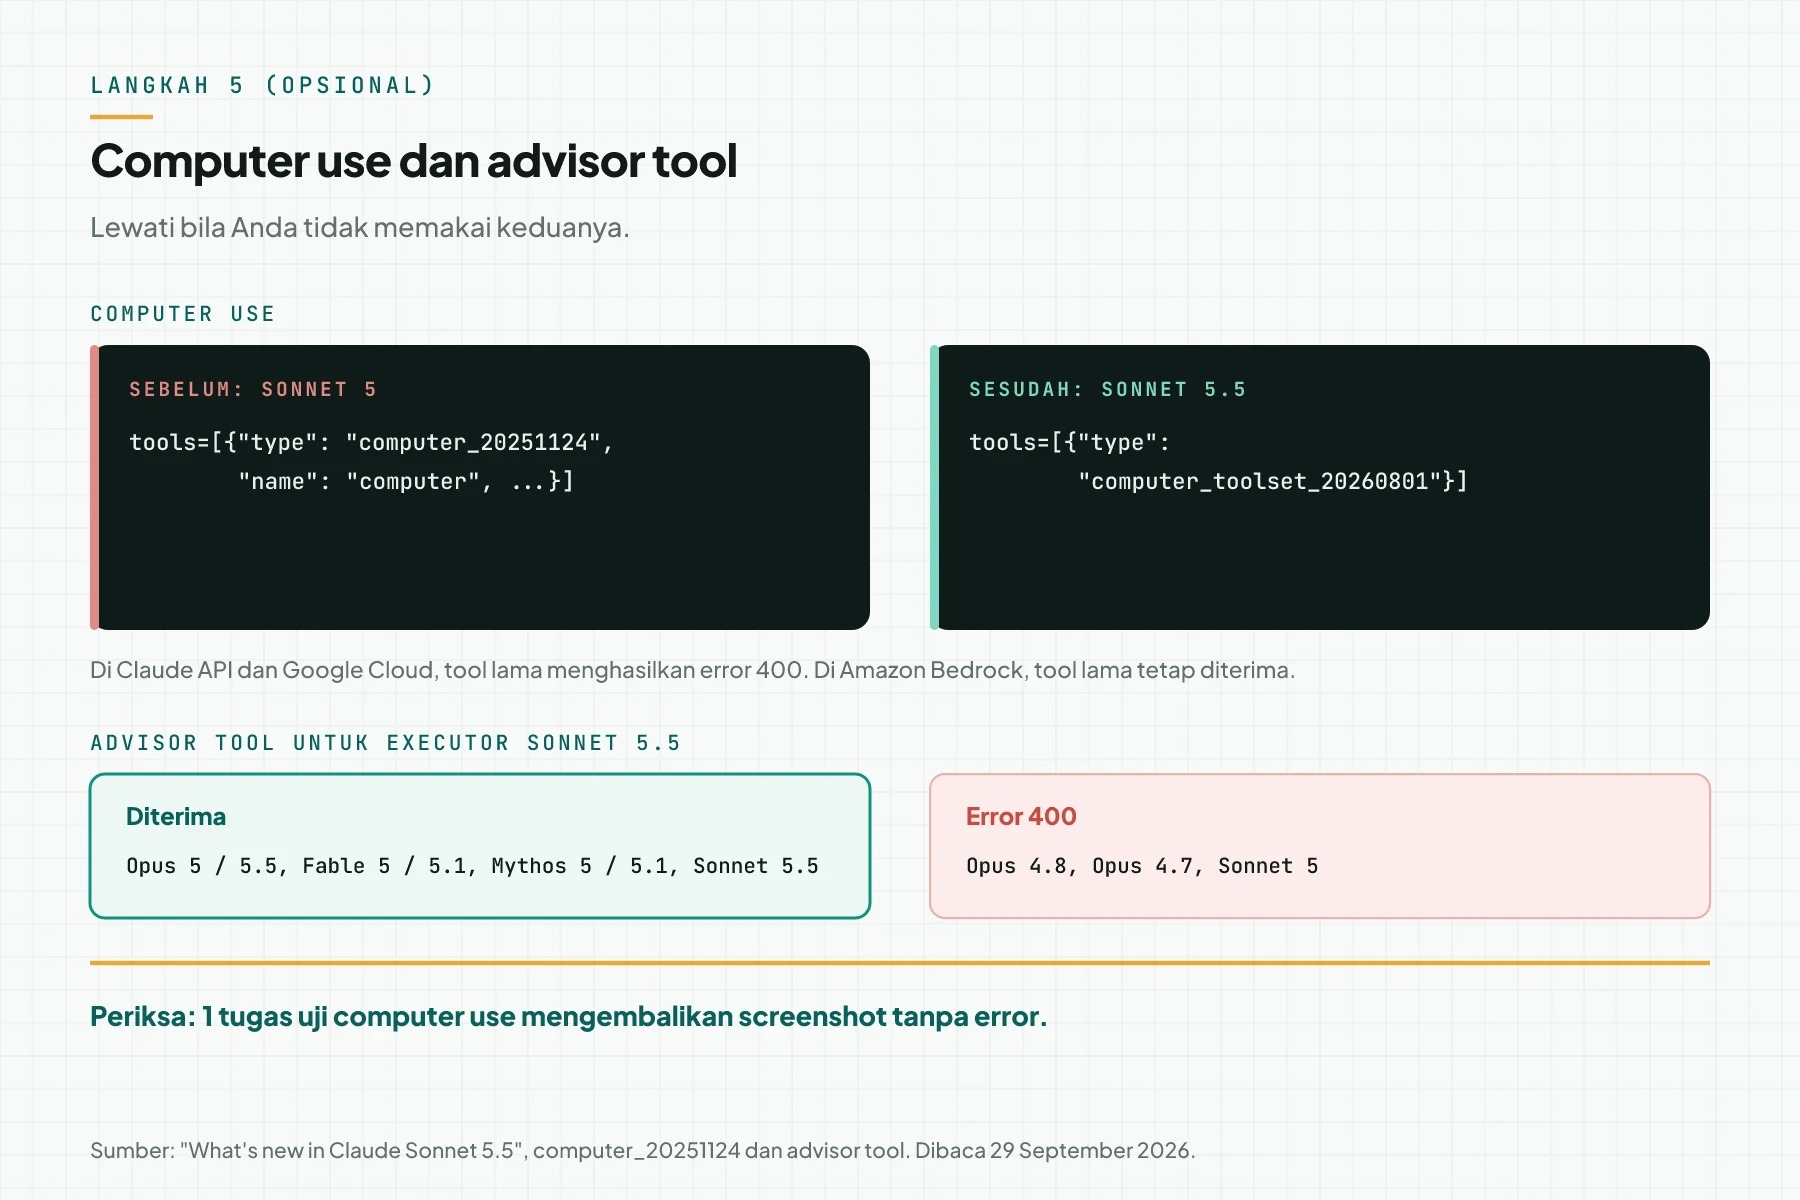
Deklarasikan computer_toolset_20260801 tanpa header beta. Untuk advisor tool, pilih Opus 5, Opus 5.5, Fable 5, Fable 5.1, Mythos 5, Mythos 5.1, atau Sonnet 5.5 sendiri. Saran advisor datang terenkripsi sebagai blok advisor_redacted_result.
Periksa: 1 tugas uji computer use mengembalikan screenshot, dan 1 panggilan advisor menjawab 200.
Langkah 6: Tangani refusal siber dan ukur ulang biaya
Siapkan penanganan stop_reason: "refusal" sebelum rilis. Di Claude API, set fallbacks: "default" agar API mengulang refusal cyber dan frontier_llm di Sonnet 5 secara otomatis.
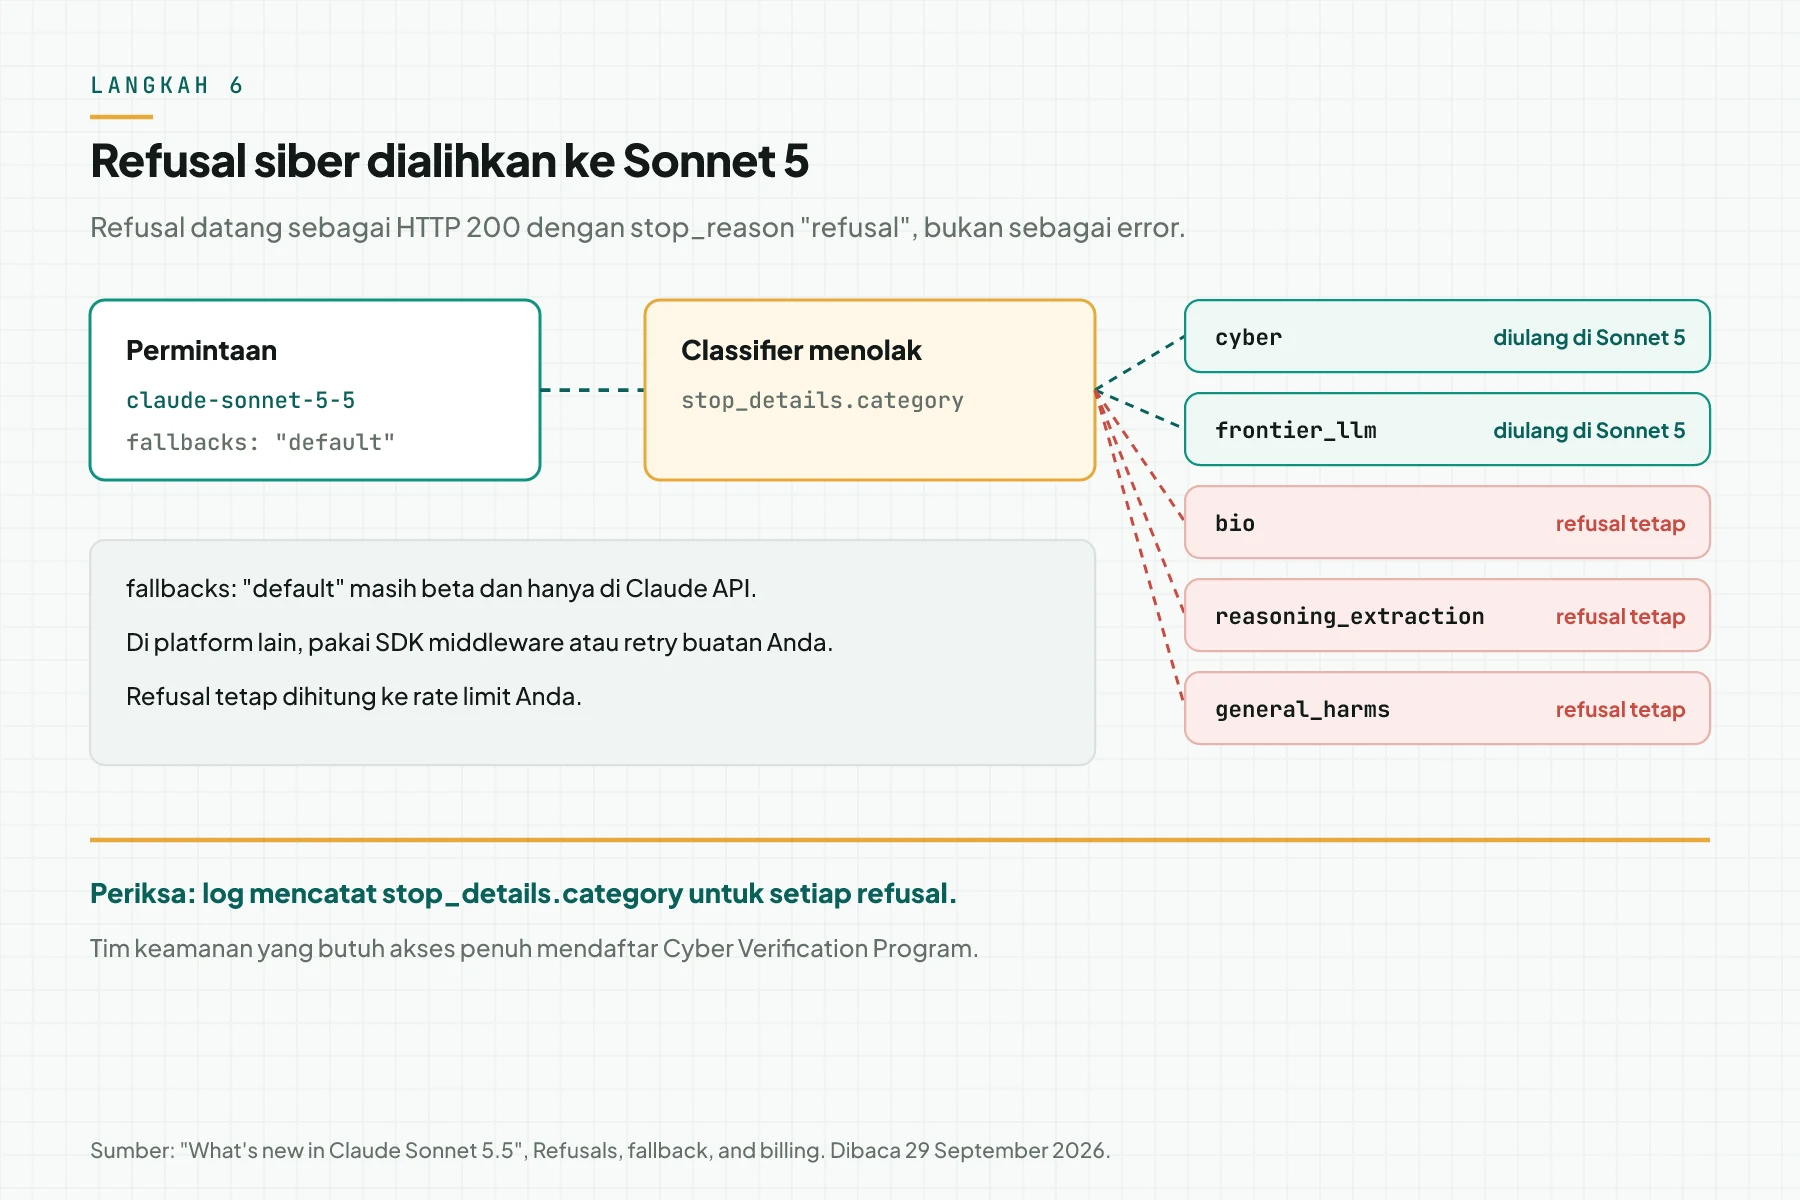
Di Amazon Bedrock, Google Cloud, dan Microsoft Foundry, pakai SDK middleware atau retry buatan Anda. Refusal tetap dihitung ke rate limit Anda, dan biayanya bergantung pada kategori. Sumber: halaman Refusals and fallback.
Lalu bandingkan token output per tugas dengan garis dasar Sonnet 5. Periksa: log mencatat stop_details.category untuk setiap refusal, dan laporan biaya menunjukkan token per tugas yang berhasil.
Contoh: biaya per jawaban turun dengan harga token yang sama
Balyasny menguji Sonnet 5.5 pada 2.441 tugas keuangan, menurut pengumuman Anthropic. Sonnet 5.5 memakai sekitar 121.000 token per jawaban, sedangkan Sonnet 5 memakai 497.000 token. Ini klaim pelanggan, jadi ukur ulang di data Anda.
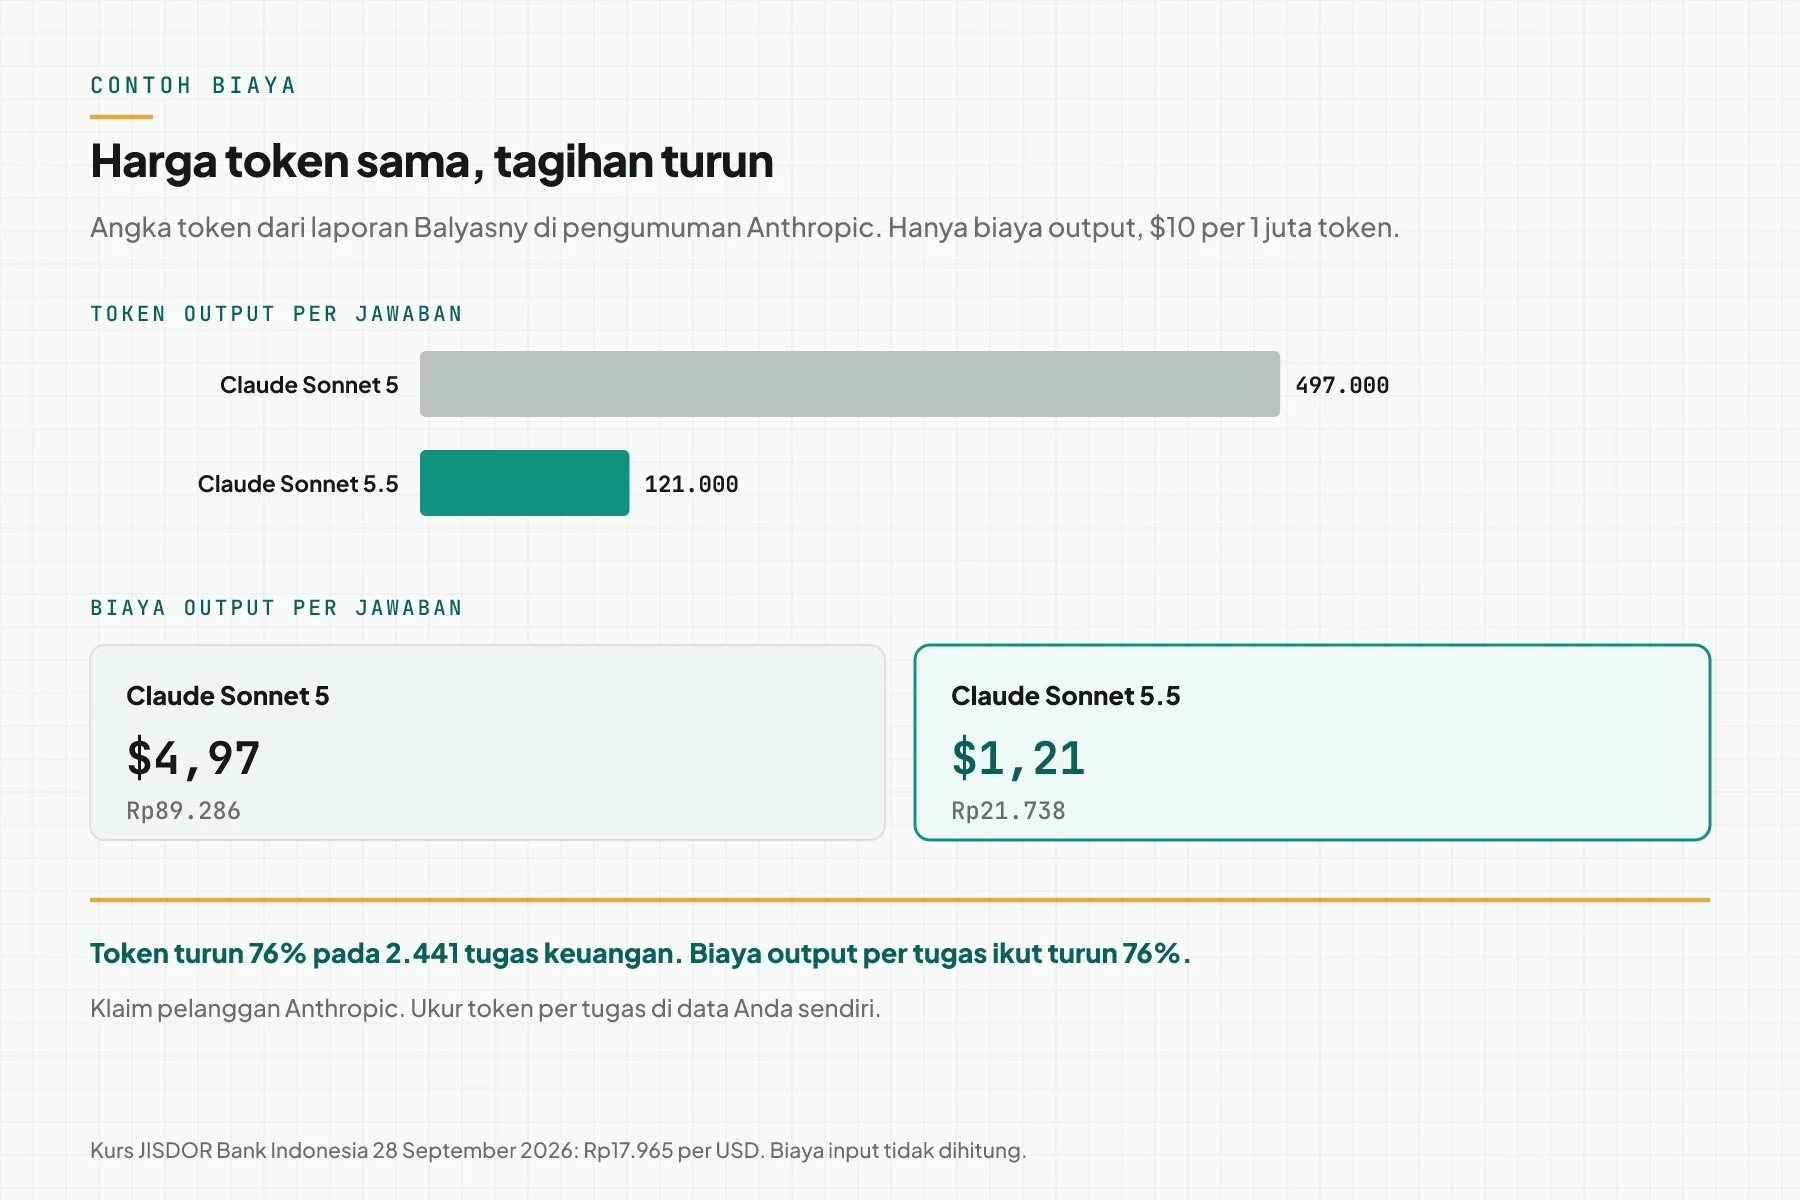
Simulasi dengan data dummy berikut menunjukkan cara tim "Agensi Contoh" mencatat migrasi 1 agent laporan. Kurs JISDOR Bank Indonesia 28 September 2026: Rp17.965 per USD.
| Waktu | Aksi | Yang tercatat | Hasil |
|---|---|---|---|
| 29 Sep 2026, 09.00 | Ambil garis dasar Sonnet 5 | 497.000 token output per laporan | $4,97 atau Rp89.286 per laporan |
| 29 Sep 2026, 10.00 | Langkah 1 sampai 3 di staging | 20 tugas, effort medium | 20 dari 20 menjawab 200 |
| 29 Sep 2026, 13.00 | Uji 20 tugas nyata | 121.000 token output per laporan | $1,21 atau Rp21.738 per laporan |
| 30 Sep 2026, 09.00 | Pindahkan 10% trafik | stop_details.category per refusal | 0 refusal cyber pada 200 laporan |
| 2 Okt 2026, 09.00 | Pindahkan 100% trafik | Token per tugas berhasil | Biaya output turun 76% |
Checklist migrasi ke Sonnet 5.5
- Catat token per tugas Sonnet 5 selama 7 hari. Pemilik: engineer platform. Bukti: laporan pemakaian per alur kerja.
- Ganti model ID dan tulis effort di setiap permintaan. Pemilik: engineer aplikasi. Bukti: diff konfigurasi.
- Ganti
disableddenganbetween_toolsdantool_choicepaksa denganautoplus strict. Pemilik: engineer aplikasi. Bukti: 0 error 400 di staging. - Pastikan percakapan append-only dan UI progres tidak diam. Pemilik: engineer frontend. Bukti: rekaman 1 sesi agent 10 giliran.
- Pasang fallback refusal dan log kategori. Pemilik: engineer platform. Bukti: 1 refusal uji tercatat dengan kategorinya.
- Uji 20 tugas nyata di Sonnet 5.5 dan Opus 5.5. Pemilik: pemilik alur kerja. Bukti: tabel lulus, token, dan waktu per model.
- Berhenti dan kembali ke Sonnet 5 bila skor lulus turun lebih dari 1 tugas dari 20, atau bila token per tugas naik. Pemilik: pemilik alur kerja. Bukti: catatan keputusan dengan tanggal.
Pertanyaan umum
Apakah harga Claude Sonnet 5.5 lebih mahal dari Sonnet 5? Tidak. Harganya sama: $2 input, $10 output, dan $0,20 cache read per 1 juta token. Biaya per tugas dapat turun karena Sonnet 5.5 memakai lebih sedikit token.
Apa model ID Claude Sonnet 5.5? Di Claude API, Google Cloud, Microsoft Foundry, dan Claude Platform on AWS, ID-nya claude-sonnet-5-5. Di Amazon Bedrock, ID-nya anthropic.claude-sonnet-5-5.
Kenapa kode saya mendapat error 400 setelah pindah ke Sonnet 5.5? Penyebab paling umum adalah thinking disabled, tool_choice any atau tool, sampling parameter non-default, dan computer_20251124. Baca teks error, lalu ikuti Langkah 2, 3, atau 5.
Apakah permintaan saya dapat dijawab oleh Sonnet 5, bukan Sonnet 5.5? Ya, untuk refusal cyber dan frontier_llm bila Anda memakai fallbacks default di Claude API. Anthropic menulis bahwa perbaikan bug rutin tetap berjalan di Sonnet 5.5.
Kapan saya tetap memakai Opus 5.5? Pakai Opus 5.5 untuk tugas terbuka yang butuh penilaian panjang, seperti desain arsitektur dan riset. Anthropic menulis bahwa Opus 5.5 tetap lebih kuat untuk pekerjaan itu.
Langkah berikutnya
Batas yang tetap berlaku: benchmark Anthropic dan uji kami hanya titik awal, karena prompt, data, dan risiko Anda berbeda. Uji 20 tugas nyata sebelum Anda memindahkan trafik. Bila tim Anda ingin model, prompt, dan biaya AI dipantau setiap bulan, lihat layanan OS Care Retainer. Untuk membahas migrasi sistem Anda, jadwalkan sesi scoping teknis.
Sumber
- Anthropic: Introducing Claude Sonnet 5.5
- Anthropic: Introducing Claude Sonnet 5
- Claude Docs: Claude Sonnet 5.5
- Claude Docs: What's new in Claude Sonnet 5.5
- Claude Docs: Migrating to Claude Sonnet 5.5
- Claude Docs: Refusals and fallback
- Claude Docs: Models overview
- Artificial Analysis: Claude Sonnet 5.5
- Artificial Analysis: Claude Sonnet 5
- TechCrunch: Anthropic releases Sonnet 5.5
- Bank Indonesia: kurs JISDOR