Jawaban langsung: EmbeddingGemma 2 adalah model embedding terbuka dari Google DeepMind. Model ini mengubah teks, kode, gambar, video, dan audio menjadi vektor 768 dimensi dalam 1 ruang yang sama. Pakai model ini untuk pencarian dan RAG di mesin sendiri. Mulai dengan encoder teks 270M, prefix tugas, dan vektor 256 dimensi.
Kondisi utama: jalur ini cocok bila data pelanggan tidak boleh keluar ke APIAPIPintu resmi yang dipakai 2 sistem untuk saling mengirim data, tanpa orang menyalin data secara manual.Buka glosarium pihak lain, atau bila katalog Anda berisi foto dan rekaman. Batas: untuk teks bahasa Indonesia saja, uji kami tidak menunjukkan kenaikan dari EmbeddingGemma 1. Embedding hanya mengurutkan dokumen. Ia tidak menjamin jawaban chatbot benar.
Pada 13 Oktober 2026, EmbeddingGemma 2 tayang di halaman Product Hunt dan berada di peringkat 1 harian dengan 256 poin saat kami baca pukul 09.32 WIB. Google mengumumkan model ini pada 6 Oktober 2026 di blog Google. Kami menjalankan model di laptop RTX 4060 8 GB pada 13 Oktober 2026. Data uji adalah FAQ klinik gigi dummy dan 6 foto menu dari Wikimedia Commons.
Masalah yang diselesaikan: kata pelanggan tidak sama dengan kata di FAQ
Pelanggan menulis "gigi linu tiap minum es teh". FAQ Anda menulis "gigi sensitif". Pencarian kata kunci tidak menemukan kecocokan, karena tidak ada kata yang sama. Chatbot lalu menjawab umum, atau meneruskan chat ke admin.
Embedding mengubah kalimat menjadi deret angka. Kalimat dengan arti dekat mendapat angka yang dekat, walau katanya berbeda. Itu dasar RAG, yang kami jelaskan di knowledge base AI lokal untuk dokumen perusahaan.
Masalah kedua adalah data. API embedding di cloud menerima setiap pertanyaan dan setiap dokumen Anda. Pada tier gratis Gemini API, halaman harga Gemini API menulis "Used to improve our products: Yes". EmbeddingGemma 2 berjalan di mesin sendiri, jadi teks tidak keluar dari jaringan Anda.
Cara kerja EmbeddingGemma 2
Model ini punya 740M parameter total dan memakai arsitektur Gemma 4. Lisensinya Apache 2.0, jadi pemakaian komersial diizinkan. Bobot model tersedia di Hugging Face dan Kaggle sejak 6 Oktober 2026, menurut blog Google.
1 ruang vektor untuk 4 modalitas
Teks, gambar, video, dan audio masuk ke ruang 768 dimensi yang sama, menurut model card Hugging Face. Akibatnya, kueri teks bisa langsung dibandingkan dengan vektor foto. Anda tidak perlu model kedua untuk gambar.
1 input juga boleh mencampur modalitas. Contoh: deskripsi produk, 2 foto, dan 1 video demo menjadi 1 vektor. Penanda posisinya adalah token <|image|>, <|video|>, dan <|audio|> di dalam teks.
Encoder modular: muat yang Anda pakai saja
Basis teks dan kode berukuran 270M: 130M transformer dan 140M embedder. Encoder gambar menambah 170M. Encoder audio menambah 300M. Tabel di model card Hugging Face memberi 4 konfigurasi: 270M, 440M, 570M, dan 740M.
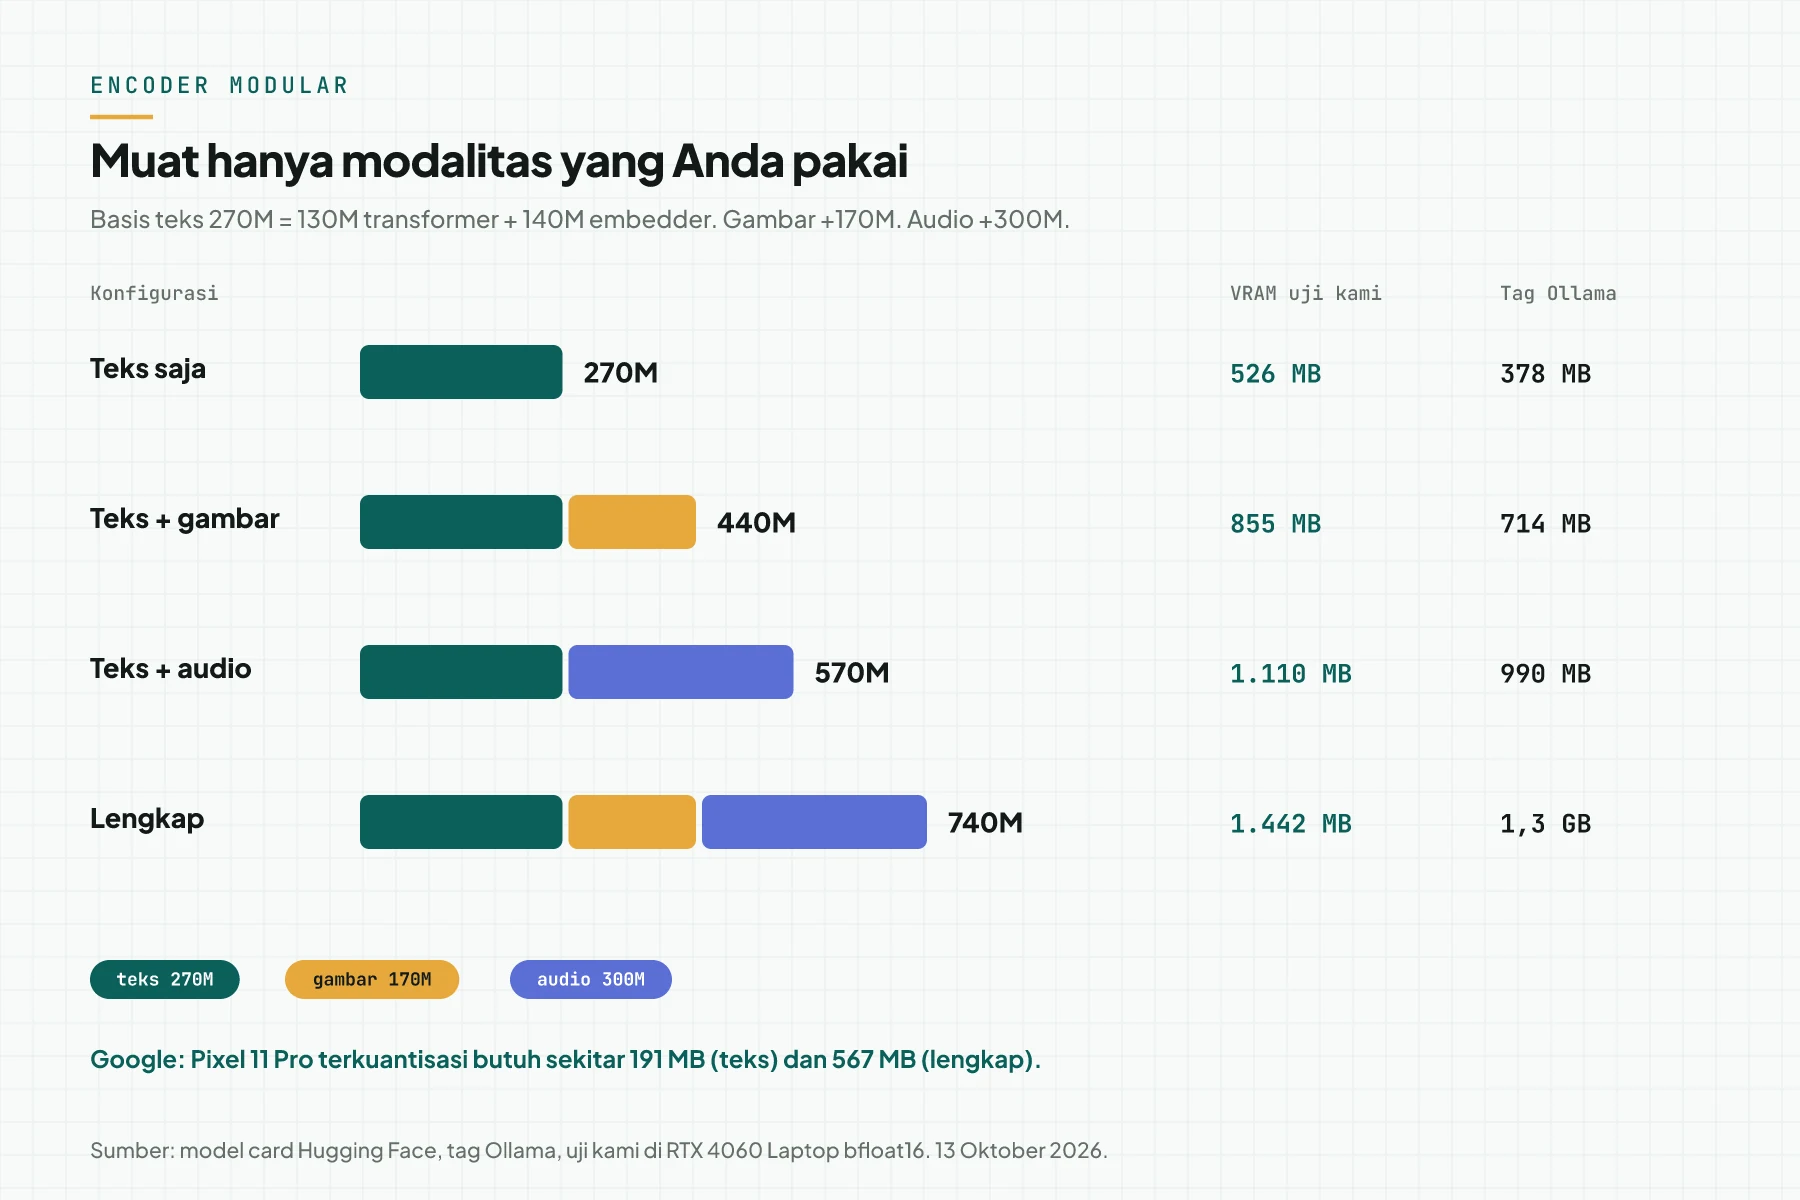
Google menulis bahwa Pixel 11 Pro dengan kuantisasi butuh sekitar 191 MB RAM aktif untuk teks dan sekitar 567 MB untuk model lengkap. Itu klaim vendor. Pada uji kami tanpa kuantisasi, VRAM puncak adalah 526 MB untuk teks dan 1.442 MB untuk model lengkap.
Konteks 8.192 token yang dibagi semua modalitas
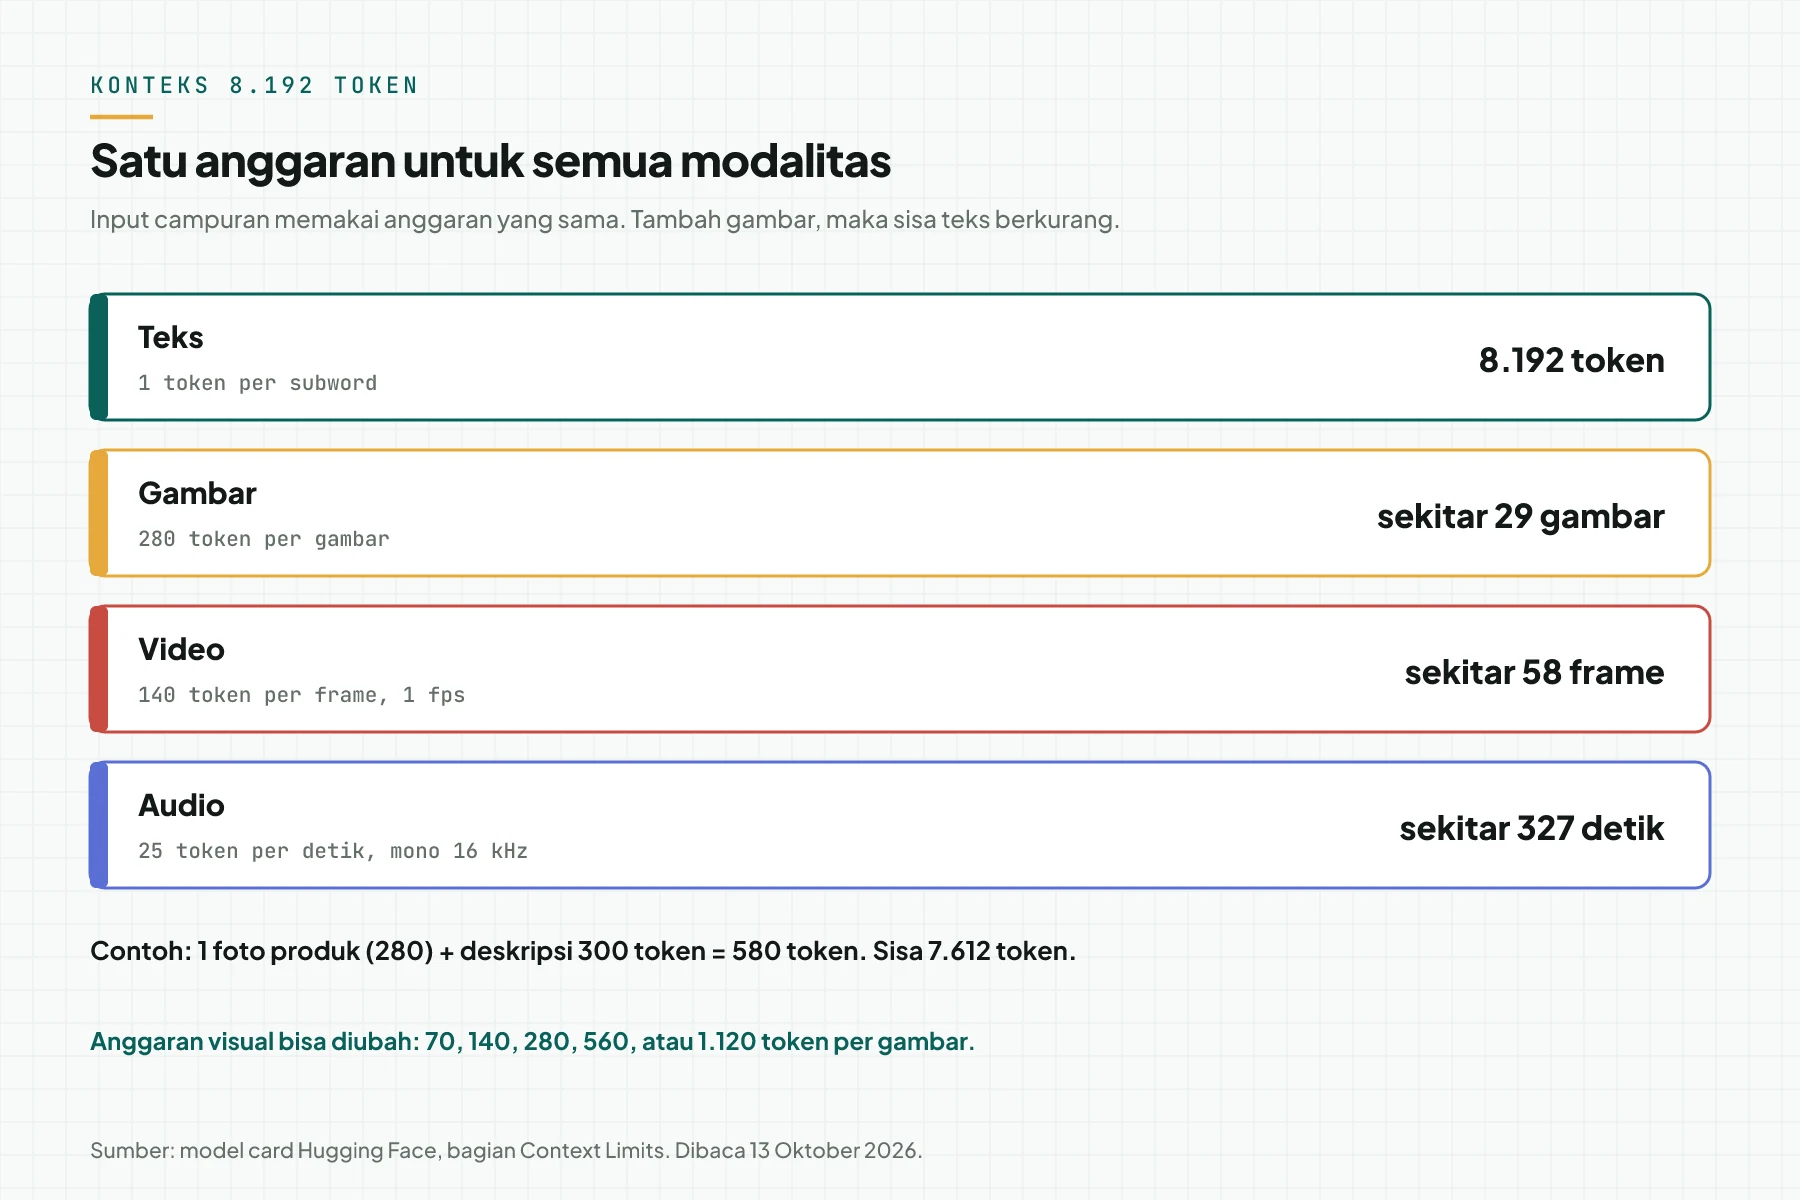
EmbeddingGemma 1 menerima 2K token teks, menurut model card EmbeddingGemma 1. Versi 2 menerima 8.192 token. Gambar memakai 280 token, frame video 140 token, dan audio 25 token per detik.
Prefix tugas
Model dilatih dengan prefix pendek di depan teks. Kueri pencarian memakai task: search result | query: {kueri}. Dokumen memakai title: {judul} | text: {isi}. Gambar, video, dan audio tidak memakai prefix. Model card menyebut 7 nama prompt, antara lain SearchQuery, CodeRetrieval, dan Classification.
Matryoshka (MRL)
Vektor 768 dimensi boleh dipotong ke 512, 256, atau 128. Bagian depan vektor membawa informasi paling penting. Potongan wajib dinormalisasi lagi, dan kueri harus memakai dimensi yang sama dengan dokumen.
Perbandingan: EmbeddingGemma 1, EmbeddingGemma 2, dan Gemini Embedding 2
Tabel ini memakai fakta dari halaman vendor yang kami baca pada 13 Oktober 2026. Harga Gemini adalah harga paid tier dalam dolar AS per 1 juta token.
| Atribut | EmbeddingGemma 1 | EmbeddingGemma 2 | Gemini Embedding 2 |
|---|---|---|---|
| Tempat jalan | Mesin sendiri | Mesin sendiri | API Google |
| Parameter | 300M | 270M sampai 740M | Tidak disebut |
| Input | Teks | Teks, kode, gambar, video, audio | Teks, gambar, video, audio, PDF |
| Konteks | 2K token | 8.192 token | 8.192 token |
| Dimensi | 768, MRL ke 512, 256, 128 | 768, MRL ke 512, 256, 128 | 128 sampai 3.072 |
| MTEB multilingual v2 | 61,15 | 61,36 | Tidak dibandingkan di sumber ini |
| MTEB code v1 | 68,76 | 78,68 | Tidak dibandingkan di sumber ini |
| Lisensi atau biaya | Gemma, akses Hugging Face perlu persetujuan | Apache 2.0, tanpa gerbang di Hugging Face | Teks $0,20, gambar $0,45, audio $6,50, video $12,00 |
Sumber skor MTEB adalah model card Hugging Face. Data Gemini berasal dari halaman model Gemini Embedding 2 dan halaman harga Gemini API. Mode batch Gemini memotong harga menjadi separuh.
Yang perlu Anda siapkan
- 1 mesin dengan Python 3.12. Kami memakai RTX 4060 Laptop 8 GB. CPU juga bisa, dengan float32.
- Ruang disk sekitar 8 GB untuk PyTorch CUDA dan 1,5 GB untuk bobot model.
- Akses internet sekali untuk mengunduh
google/embeddinggemma-2. Sesudah itu, jalankan denganHF_HUB_OFFLINE=1. - 20 sampai 50 pertanyaan asli pelanggan, sudah tanpa nama dan nomor. Pasangkan setiap pertanyaan dengan dokumen yang benar.
- 1 katalog yang boleh diubah: FAQ, SOP, atau folder foto produk.
Langkah 1: Pilih runtime dan cek versinya
Cek versi runtime sebelum mengunduh model. Pada 13 Oktober 2026, Ollama 0.32.3 di mesin uji kami menolak ollama pull embeddinggemma-2:270m-bf16-text dengan kode 412. Pesannya meminta versi Ollama yang lebih baru.
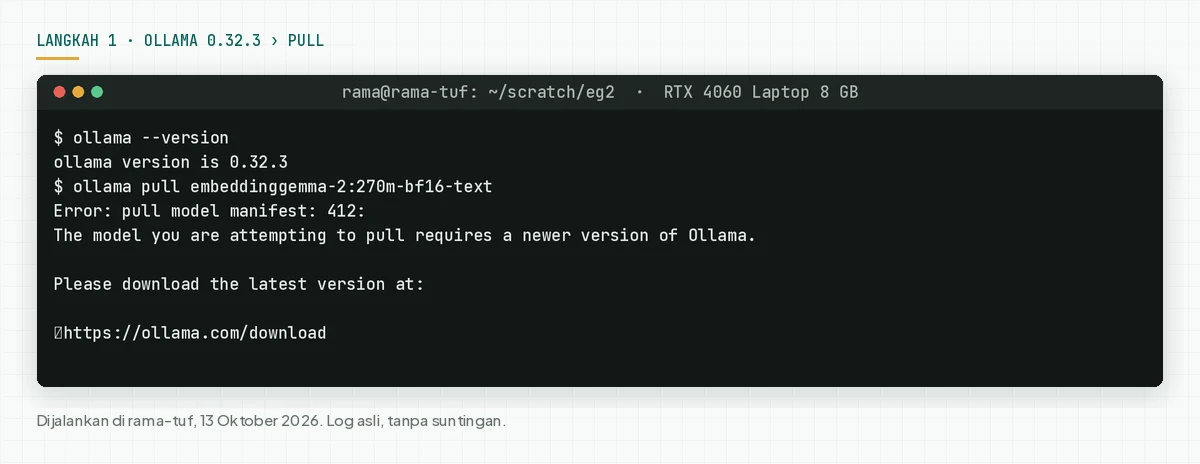
rilis Ollama v0.40.0 pada 25 September 2026 menambah EmbeddingGemma 2 untuk MLX, yaitu jalur Apple Silicon. Untuk Linux dan Windows, pembaruan llama.cpp untuk model ini baru ada di v0.40.4-rc0, rilis kandidat tanggal 12 Oktober 2026. daftar tag Ollama juga menandai banyak tag sebagai MLX.
Rekomendasi Rama Digital: di Mac Apple Silicon, pakai Ollama terbaru. Di Linux atau Windows dengan GPU NVIDIA, pakai sentence-transformers sampai rilis stabil Ollama memuat dukungan llama.cpp. Cek berhasil: runtime memuat model tanpa error versi.
Langkah 2: Pasang sentence-transformers dan muat encoder yang perlu
Buat lingkungan Python terpisah, supaya versi PyTorch tidak mengganggu proyek lain. Kami memakai torch 2.14.1, transformers 5.19.0, dan sentence-transformers 6.1.0. Muat encoder teks saja bila katalog Anda hanya teks.
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python torch --index-url https://download.pytorch.org/whl/cu128
uv pip install --python .venv/bin/python -U sentence-transformers transformers pillow

# muat encoder teks saja (270M)
import torch
from sentence_transformers import SentenceTransformer
dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float32
model = SentenceTransformer(
    "google/embeddinggemma-2",
    model_kwargs={"torch_dtype": dtype},
    config_kwargs={"vision_config": None, "audio_config": None},
)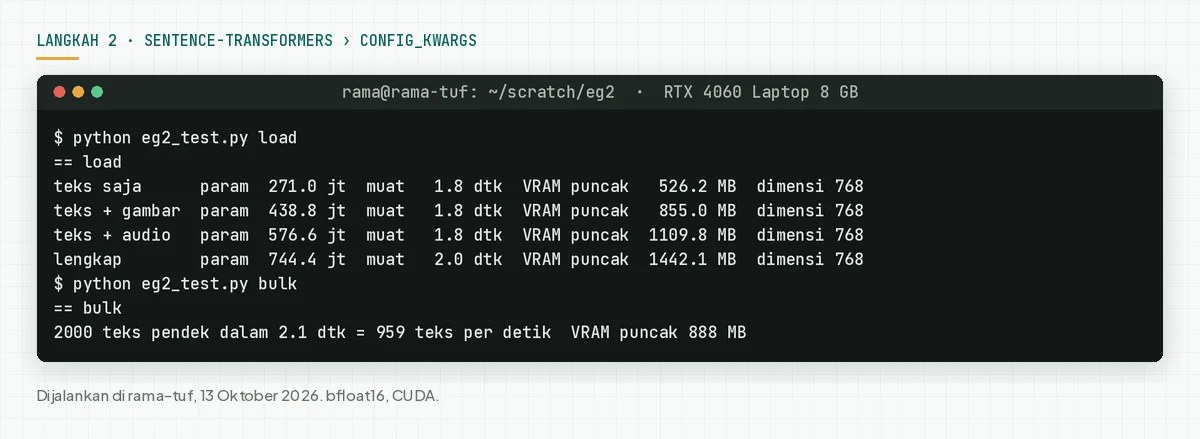
Pada uji kami, setiap konfigurasi selesai dimuat dalam 1,8 sampai 2,0 detik dari cache lokal. Encoder teks memproses 959 teks pendek per detik dengan batch 64. Cek berhasil: model.encode(["tes"]) mengembalikan vektor 768 dimensi. Sumber parameter config_kwargs: model card Hugging Face.
Langkah 3: Pakai prefix tugas, lalu uji dengan FAQ sendiri
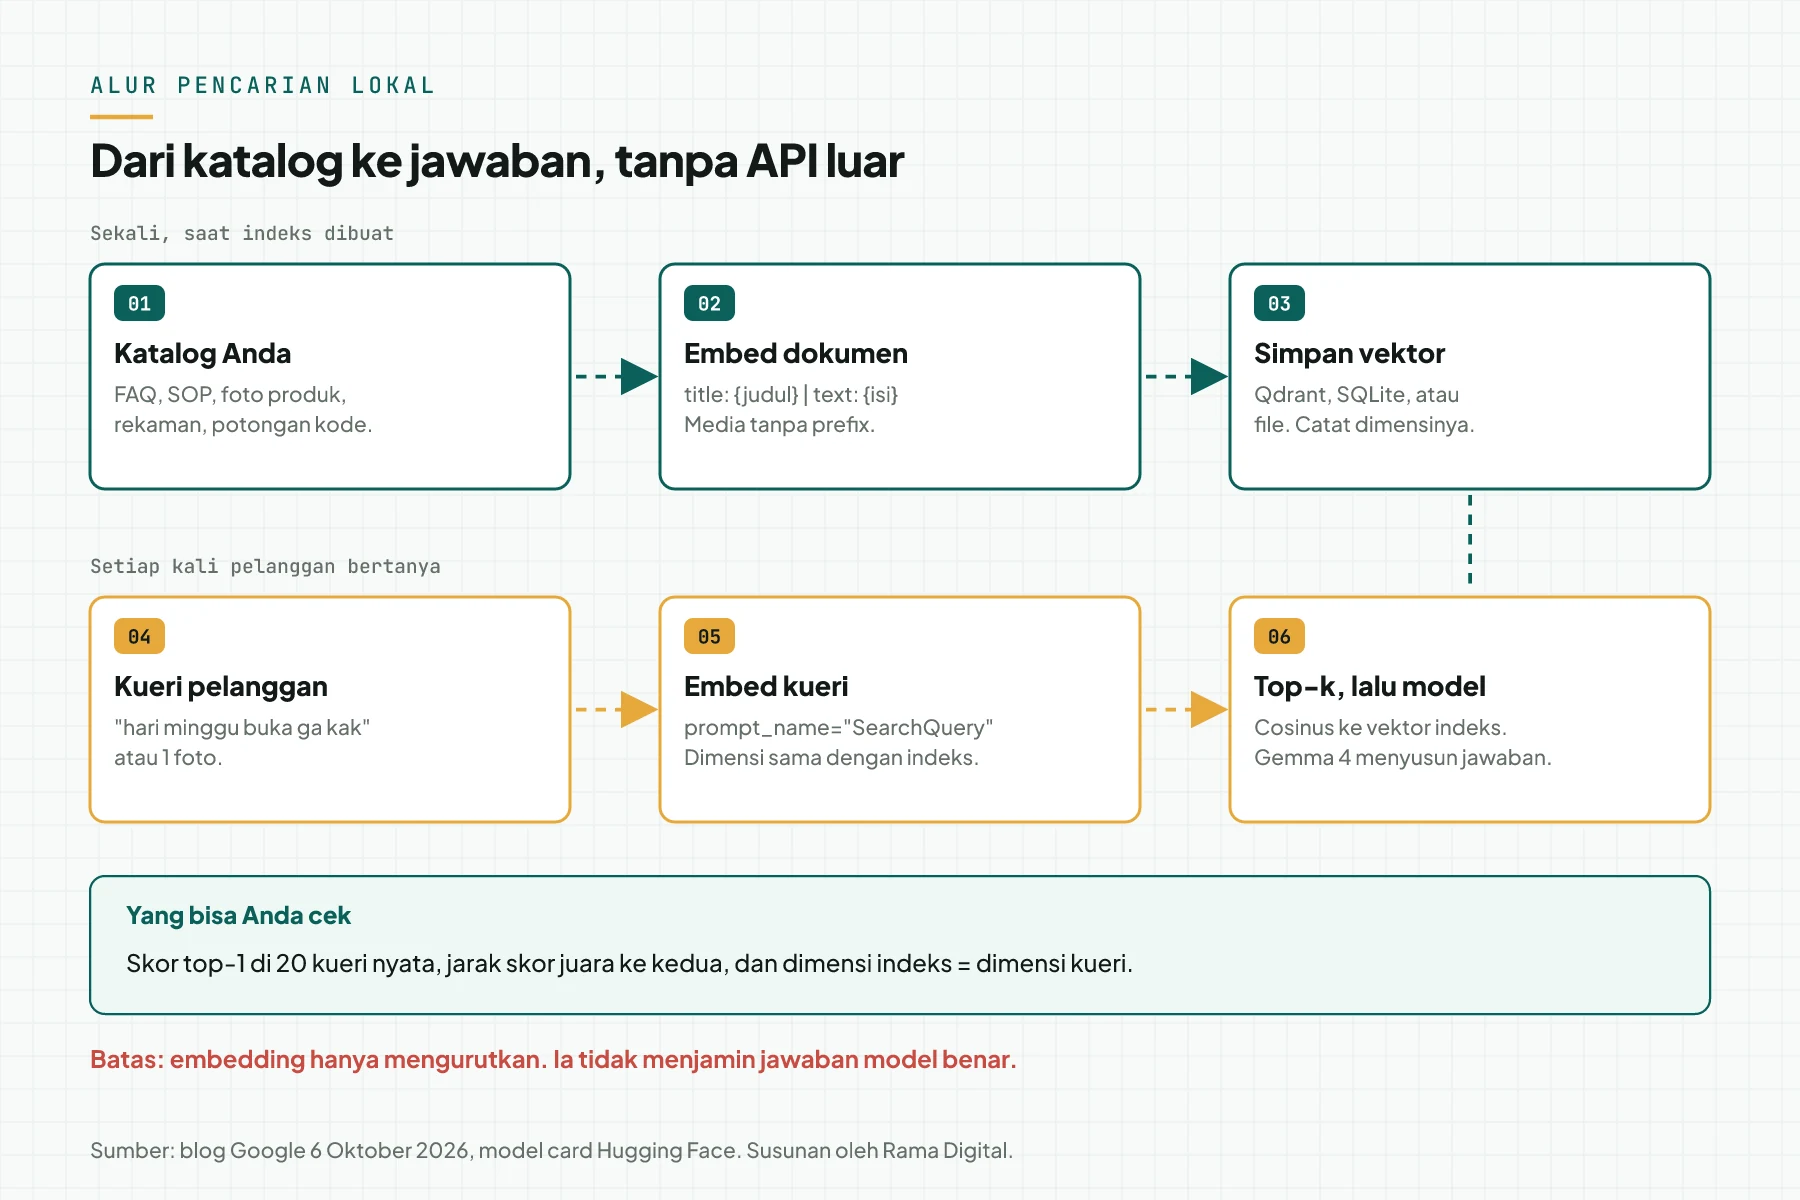
Format dokumen sebagai title: {judul} | text: {isi}. Pakai prompt_name="SearchQuery" untuk kueri. Lalu ukur top-1 dengan pertanyaan asli, bukan dengan contoh dari vendor.
docs = [f"title: {judul} | text: {isi}" for judul, isi in faq]
d = model.encode(docs, normalize_embeddings=True)
q = model.encode("hari minggu buka ga kak",
                 prompt_name="SearchQuery", normalize_embeddings=True)
skor = model.similarity(q, d)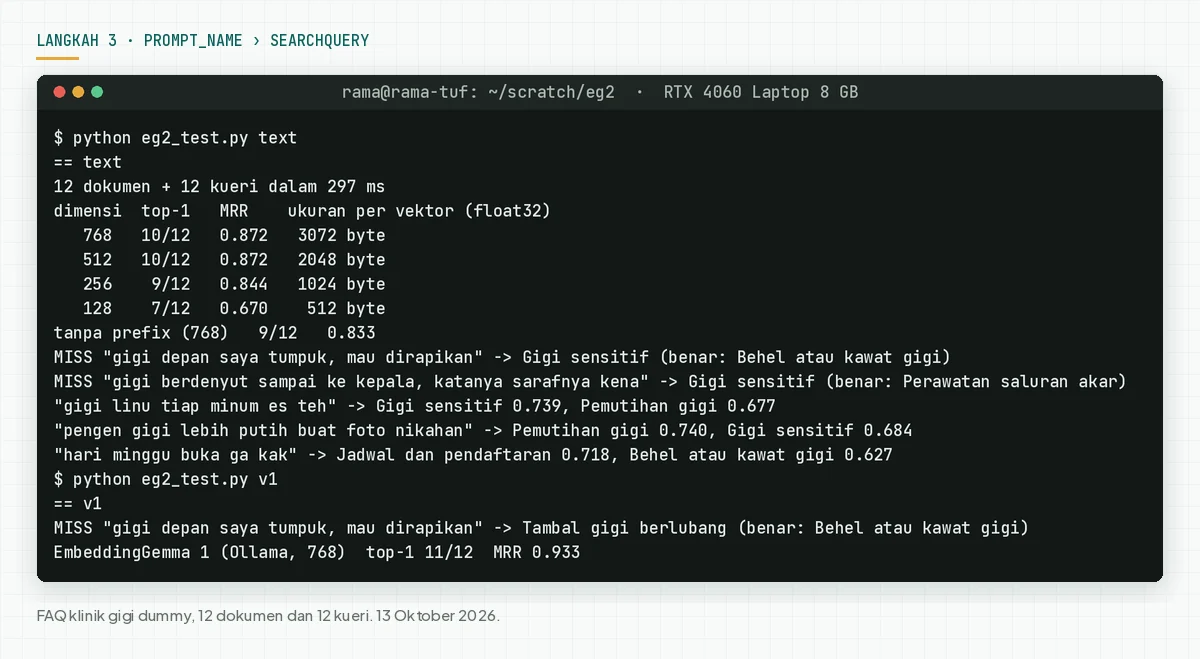
Pada uji kami, prefix menaikkan top-1 dari 9 menjadi 10 dari 12 kueri. EmbeddingGemma 2 meleset pada "gigi depan saya tumpuk" dan "gigi berdenyut sampai ke kepala". EmbeddingGemma 1 lewat Ollama hanya meleset pada kueri pertama. Selisih 1 kueri di 12 kueri belum membuktikan model lama lebih baik.
Hasil ini sejalan dengan model card Hugging Face: skor MTEB multilingual hanya naik dari 61,15 ke 61,36. Kenaikan besar ada di kode, dari 68,76 ke 78,68. Cek berhasil: Anda mencatat top-1 dan MRR untuk 20 kueri asli, dengan dan tanpa prefix.
Langkah 4: Potong dimensi dengan MRL, lalu normalisasi lagi
Pakai truncate_dim dan normalize_embeddings=True pada kueri dan dokumen. Simpan angka dimensi di metadata indeks. Kueri 768 dimensi tidak bisa dibandingkan dengan indeks 256 dimensi.
q = model.encode(kueri, prompt_name="SearchQuery",
                 truncate_dim=256, normalize_embeddings=True)
d = model.encode(dokumen, truncate_dim=256, normalize_embeddings=True)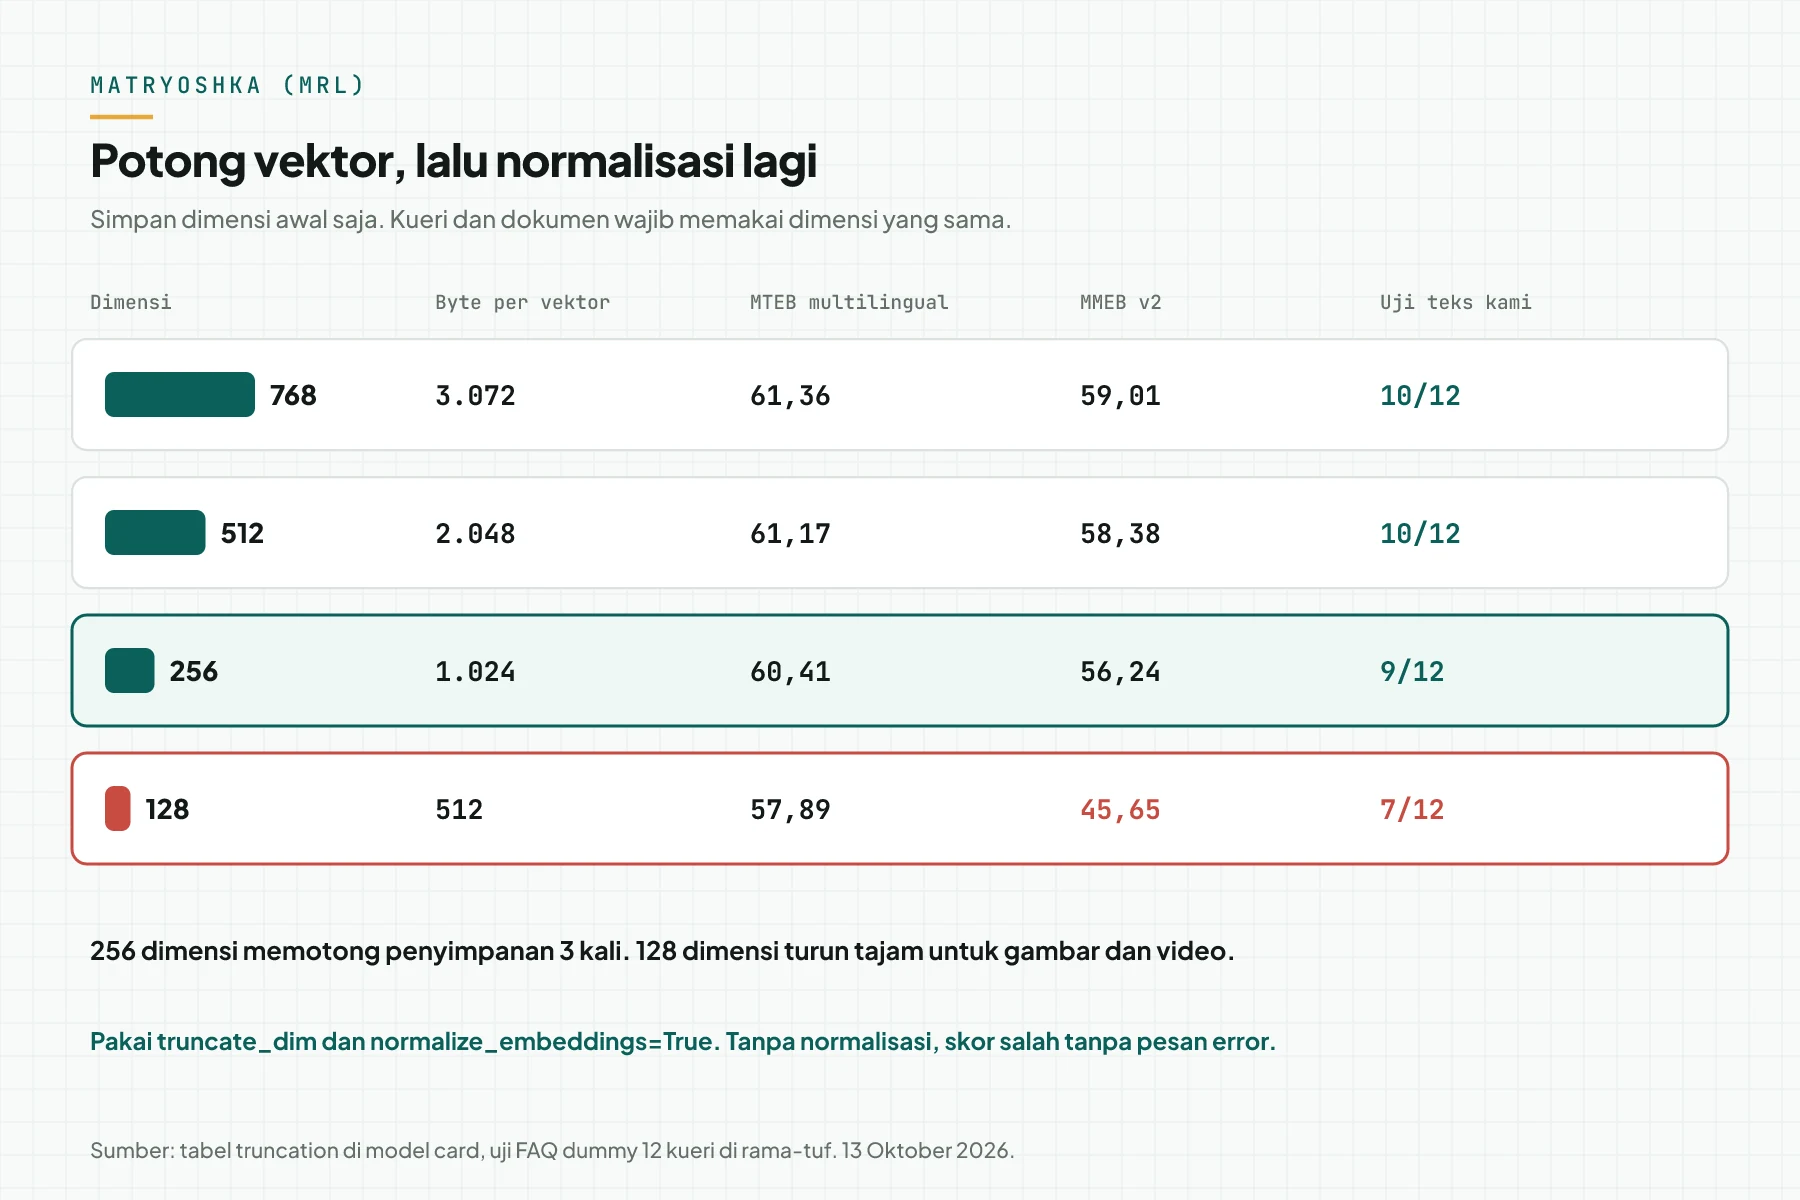
Satu vektor float32 768 dimensi berukuran 3.072 byte. Pada 256 dimensi, ukurannya 1.024 byte. Untuk 1 juta dokumen, itu 3 GB berbanding 1 GB, sebelum indeks. Model card menulis bahwa 128 dimensi menurunkan mutu multimodal secara besar. Cek berhasil: top-1 di dimensi pilihan Anda turun paling banyak 1 kueri dari hasil 768.
Langkah 5 (opsional): Cari foto dengan kalimat bahasa Indonesia
Muat konfigurasi teks dan gambar, yaitu 440M. Embed setiap foto tanpa prefix. Lalu kirim kueri teks dengan SearchQuery. Kami memakai 6 foto makanan dari Wikimedia Commons sebagai menu dummy.
model = SentenceTransformer("google/embeddinggemma-2",
    model_kwargs={"torch_dtype": dtype},
    config_kwargs={"audio_config": None})          # 440M
foto = model.encode([{"image": p} for p in paths], normalize_embeddings=True)
q = model.encode("minuman panas hitam, ampasnya mengendap",
                 prompt_name="SearchQuery", normalize_embeddings=True)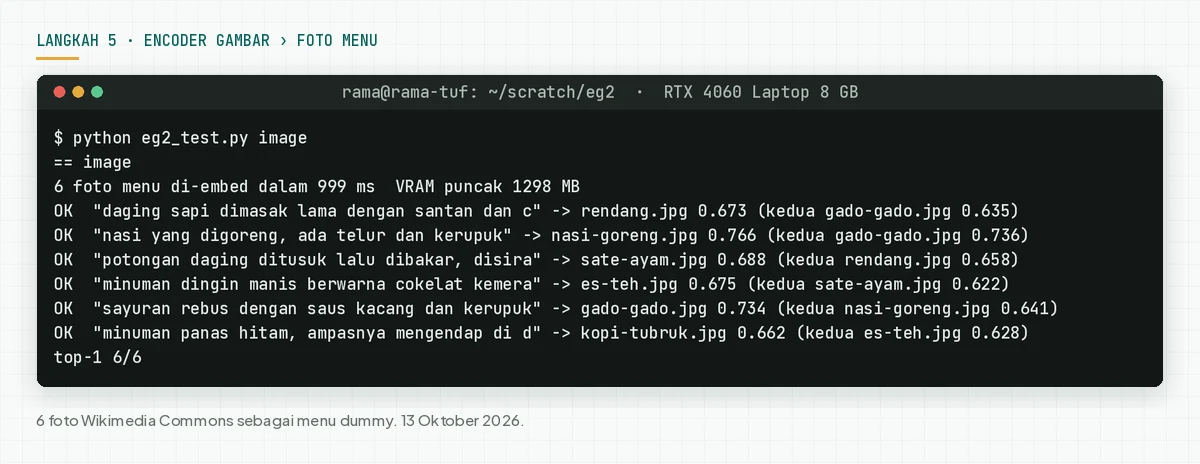
Kueri "minuman panas hitam, ampasnya mengendap di dasar gelas" menemukan kopi tubruk dengan skor 0,662. Foto kedua, es teh, mendapat 0,628. Kueri tidak menyebut nama menu sama sekali. Embed 6 foto butuh 999 ms dan VRAM puncak 1.298 MB.
Skor 6 dari 6 berasal dari 6 foto dengan jenis makanan yang jauh berbeda. Katalog asli punya foto yang mirip, misalnya 12 varian kopi. Uji ulang dengan katalog Anda. Panduan resmi ada di panduan multimodal Google. Cek berhasil: skor juara dan skor kedua tercatat untuk setiap kueri uji.
Langkah 6: Kunci presisi di bfloat16 atau float32
Set torch_dtype ke bfloat16 bila GPU mendukung, atau float32 di CPU. Jangan pakai float16. Model card menulis bahwa aktivasi model melebihi rentang float16, dan kegagalannya tidak memunculkan error.
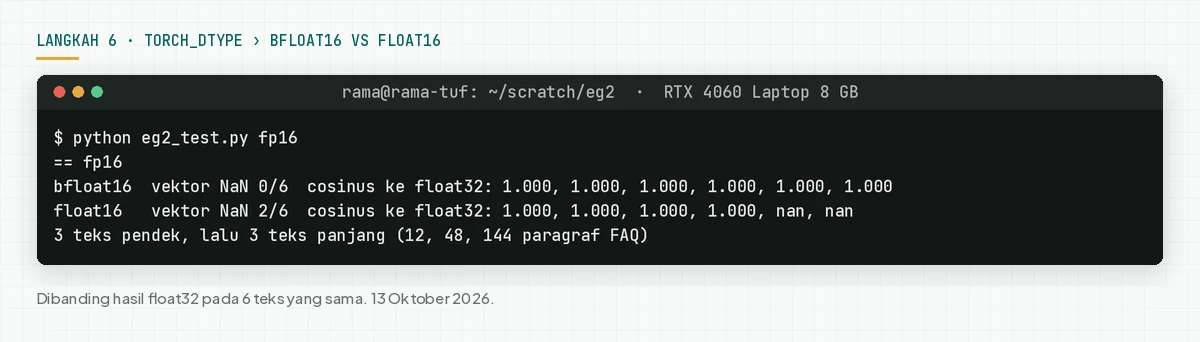
Kami membandingkan bfloat16 dan float16 dengan hasil float32 pada 3 teks pendek dan 3 teks panjang. Teks pendek lolos di float16. Dua teks terpanjang menghasilkan NaN. Jadi uji 1 kalimat tidak menangkap masalah ini. Cek berhasil: torch.isnan(emb).any() bernilai False pada dokumen terpanjang di katalog Anda.
Contoh: chatbot klinik gigi memakai indeks lokal
Simulasi dengan data dummy. Skor berasal dari uji kami pada 13 Oktober 2026. Ambang 0,70 adalah contoh, bukan angka dari Google.
| Waktu | Input | Yang sistem catat | Output |
|---|---|---|---|
| 09.00 | 12 FAQ diindeks di 256 dimensi | 12 vektor, 1.024 byte per vektor, dim=256 | Indeks 12 KB |
| 09.05 | "hari minggu buka ga kak" | Juara: Jadwal dan pendaftaran 0,718. Kedua: 0,627 | Bot menjawab jam buka dari FAQ |
| 09.07 | "gigi depan saya tumpuk, mau dirapikan" | Juara salah: Gigi sensitif. Skor di bawah 0,70 | Chat diteruskan ke admin |
| 09.10 | Admin menambah 1 kalimat "gigi berjejal" ke FAQ Behel | 1 vektor dibuat ulang | Kueri yang sama diuji lagi |
Pelajaran dari simulasi: ambang skor dan jalur ke manusia sama penting dengan model. Untuk pola pembagian peran bot dan admin, baca RAG, knowledge base, dan memory agent.
Checklist sebelum dipakai pelanggan
- Developer mencatat versi runtime, torch, dan transformers. Bukti: output
pip freezedi repo. - Developer memuat encoder yang perlu saja. Bukti: jumlah parameter dan VRAM puncak di log.
- Pemilik FAQ menyiapkan 20 kueri asli dengan jawaban benar. Bukti: file CSV kueri dan ID dokumen.
- Developer mengukur top-1 dan MRR di 768 dan 256 dimensi. Bukti: tabel hasil dengan tanggal.
- Developer menguji dokumen terpanjang dalam bfloat16 atau float32. Bukti: 0 NaN di log.
- Pemilik layanan memilih ambang skor dan jalur ke admin. Bukti: aturan tertulis dan 3 contoh chat uji.
- Developer menyimpan dimensi dan prefix di metadata indeks. Bukti: field
dimdanpromptdi setiap koleksi. - Berhenti dan kembali ke EmbeddingGemma 1 atau model lain bila top-1 di 20 kueri asli turun lebih dari 2 kueri dari model saat ini.
Kapan memilih EmbeddingGemma 2, versi 1, atau Gemini Embedding 2
Pilih EmbeddingGemma 2 bila katalog Anda berisi foto, rekaman, video, atau kode, dan data harus tetap di mesin sendiri. Pilih tetap di EmbeddingGemma 1 bila indeks Anda hanya teks Indonesia dan sudah berjalan baik. Pindah model berarti membuat ulang semua vektor.
Pilih Gemini Embedding 2 bila Anda tidak mau mengurus server, butuh input PDF, dan data boleh diproses di API Google. Rekomendasi Rama Digital: uji ketiganya dengan 20 kueri asli yang sama. Putuskan dari top-1, biaya per bulan, dan aturan data, bukan dari skor benchmark.
Untuk memilih laptop atau server yang menjalankan model generatif di sebelahnya, baca Gemma 4: spek laptop dan benchmark dan kapan perusahaan butuh local AI server.
Pertanyaan yang sering muncul
Apakah EmbeddingGemma 2 gratis untuk bisnis? Ya. Lisensinya Apache 2.0 dan mengizinkan pemakaian komersial. Biaya Anda adalah listrik, perangkat keras, dan waktu developer. Pemakaian tetap harus mengikuti Gemma Prohibited Use Policy, menurut model card.
Apakah EmbeddingGemma 2 lebih baik untuk bahasa Indonesia daripada versi 1? Belum terbukti. Skor MTEB multilingual hanya naik dari 61,15 ke 61,36. Pada uji 12 kueri kami, versi 1 benar 11 dan versi 2 benar 10. Uji dengan data Anda sendiri.
Berapa memori yang dibutuhkan EmbeddingGemma 2? Pada RTX 4060 Laptop dengan bfloat16, VRAM puncak 526 MB untuk teks dan 1.442 MB untuk model lengkap. Google menyebut sekitar 191 MB dan 567 MB di Pixel 11 Pro dengan kuantisasi.
Apakah EmbeddingGemma 2 sudah bisa dipakai di Ollama? Di Apple Silicon, ya, sejak Ollama v0.40.0 lewat MLX. Di Linux dan Windows, dukungan llama.cpp ada di v0.40.4-rc0 per 12 Oktober 2026. Ollama 0.32.3 menolak model ini dengan kode 412.
Apakah EmbeddingGemma 2 bisa menjawab pertanyaan pelanggan? Tidak. Model ini hanya membuat vektor untuk mencari dan mengurutkan dokumen. Model generatif, misalnya Gemma 4, menyusun jawaban dari dokumen yang ditemukan. Keduanya memakai tokenizer teks dan encoder audio yang sama.
Berapa dimensi yang sebaiknya dipakai EmbeddingGemma 2? Mulai di 256 dimensi untuk teks, karena penyimpanan turun 3 kali. Pakai 512 atau 768 untuk foto dan video. Hindari 128 dimensi untuk multimodal, karena skor MMEB turun dari 59,01 ke 45,65.
Langkah berikutnya
Batas di atas tetap berlaku: uji kami kecil, dan embedding tidak menjamin jawaban benar. Local AI Server untuk Perusahaan menyiapkan perangkat keras, model, knowledge base, benchmark dengan kueri asli Anda, dan SOP. Halaman layanan itu menulis harga mulai Rp 99 juta pada 13 Oktober 2026. Jadwalkan sesi 30 menit bila Anda ingin membawa 20 kueri asli dan memutuskan model dari hasil uji.
Sumber
- blog Google, 6 Oktober 2026. Parameter, lisensi, RAM Pixel 11 Pro, konteks, dan mitra runtime.
- model card Hugging Face. Dibaca 13 Oktober 2026. Arsitektur, benchmark, tabel truncation, prefix, config_kwargs, batas konteks, dan float16.
- panduan multimodal Google dan panduan inferensi Google. Dibaca 13 Oktober 2026. Input gambar, audio, video, dan anggaran visual.
- model card EmbeddingGemma 1. Dibaca 13 Oktober 2026. Konteks 2K dan 300M parameter.
- halaman Product Hunt. Dibaca 13 Oktober 2026 pukul 09.32 WIB. Peringkat dan poin harian.
- daftar tag Ollama, rilis Ollama v0.40.0, dan v0.40.4-rc0. Dibaca 13 Oktober 2026. Tag, ukuran, dan dukungan runtime.
- halaman model Gemini Embedding 2 dan halaman harga Gemini API. Dibaca 13 Oktober 2026. Input, dimensi, dan harga Gemini Embedding 2.